Token是大模型处理文本的基本计量单位,一次调用消耗的Token数量,近似对应着模型完成的工作量——因此在大模型行业,调用量常被视作观测AI应用景气度的“发电量”指标。根据全球头部AI模型API聚合平台OpenRouter的最新数据测算,2026年9月14日至20日当周,全球AI大模型总调用量达到129万亿Token,环比增长1.57%,在8月24日至30日当周首次突破100万亿关口(113万亿)后,连续第四周刷新历史高位。
更具标志性的数字有三个:其一,当周上榜AI大模型中,中国大模型周调用量达67.46万亿Token,环比增长10.28%,约为美国的4.7倍,已连续21周超越美国、稳居全球首位;其二,同期美国大模型周调用量为14.21万亿Token,环比下滑34.7%;其三,全球调用量排名前五的模型中,中国模型占据四席——9月10日才发布的DeepSeek V4.1 Flash以单周15.8万亿Token、环比219%的增速首次登顶全平台。
一、当周全景:129万亿Token与“4比1”的Top 5
129万亿Token意味着什么?按当周总量简单折算,平均每天约有18.4万亿Token经由OpenRouter路由。把时间轴拉长,更能感知这条增长曲线的陡峭:2025年9月中旬,该平台的周处理Token量还只有4.92万亿;一年之间,这一数字增长约26倍。
当周最大的变化发生在榜首。9月10日发布的DeepSeek V4.1 Flash,在发布后的第一个完整统计周内即以15.8万亿Token的周调用量升至全平台第一,环比增速高达219%。智谱GLM 5.3 Flash(14.1万亿Token,环比+18%)、腾讯混元Hy4 preview(12.5万亿Token,环比+26%)分列第二、第三;OpenAI的GPT-5.6 Luna(9.72万亿Token,环比+47%)是前五中唯一的美国模型,位居第四;DeepSeek上一代V4 Flash 0731(9.44万亿Token,环比+18%)排名第五。
表:2026年9月14-20日当周OpenRouter调用量Top 5(数据来源:OpenRouter官网榜单)
排名 | 模型 | 厂商 | 周调用量(万亿Token) | 环比 |
1 | DeepSeek V4.1 Flash | DeepSeek | 15.8 | +219% |
2 | GLM 5.3 Flash | 智谱 | 14.1 | +18% |
3 | 混元Hy4 preview | 腾讯 | 12.5 | +26% |
4 | GPT-5.6 Luna | OpenAI | 9.72 | +47% |
5 | DeepSeek V4 Flash 0731 | DeepSeek | 9.44 | +18% |
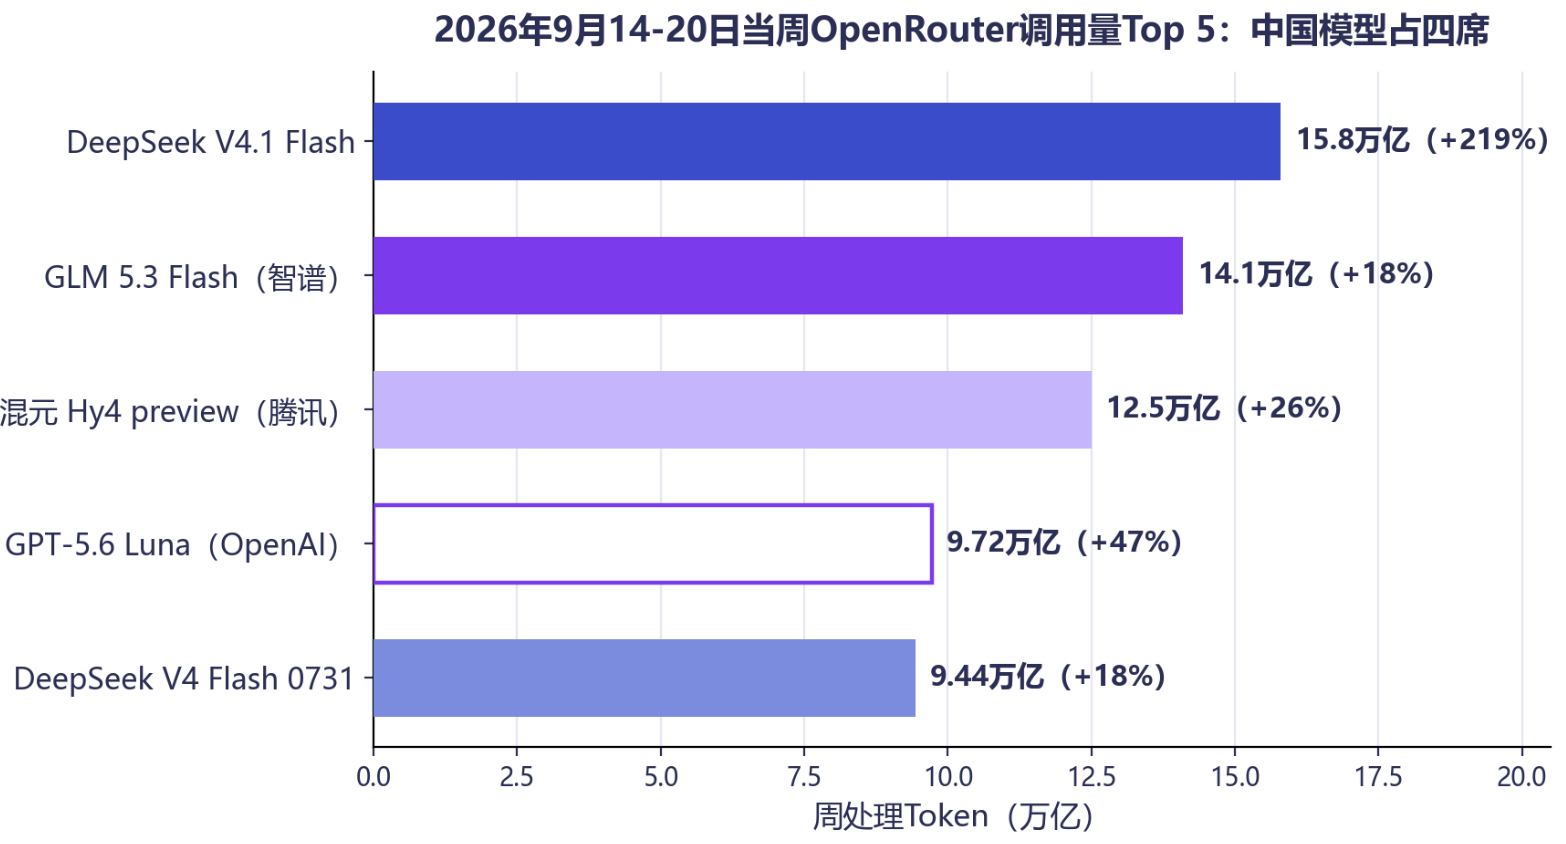
图1:当周调用量Top 5,中国模型占据四席
从厂商维度看(按文本请求份额口径),DeepSeek以25.4%的份额高居第一,且环比仍在增长(+9%);谷歌以18.6%位列第二(环比-3%),OpenAI以17.0%排在第三(环比-30%);智谱(9.4%,环比+31%)、千问(6.7%,环比+25%)、腾讯混元(6.4%)紧随其后。整体来看,中国厂商在OpenRouter上的合计请求份额已超过45%(含小米等);美国厂商约为43%(含x-ai等归入“其他”的美国厂商,属媒体测算口径;按OpenRouter官网当日榜单明确列出的谷歌、OpenAI、Anthropic三家计,合计约38.3%)。两个口径各有侧重:Token量更反映单次任务的复杂度与长度,请求份额更反映调用频次,两者共同勾勒出流量的流向。
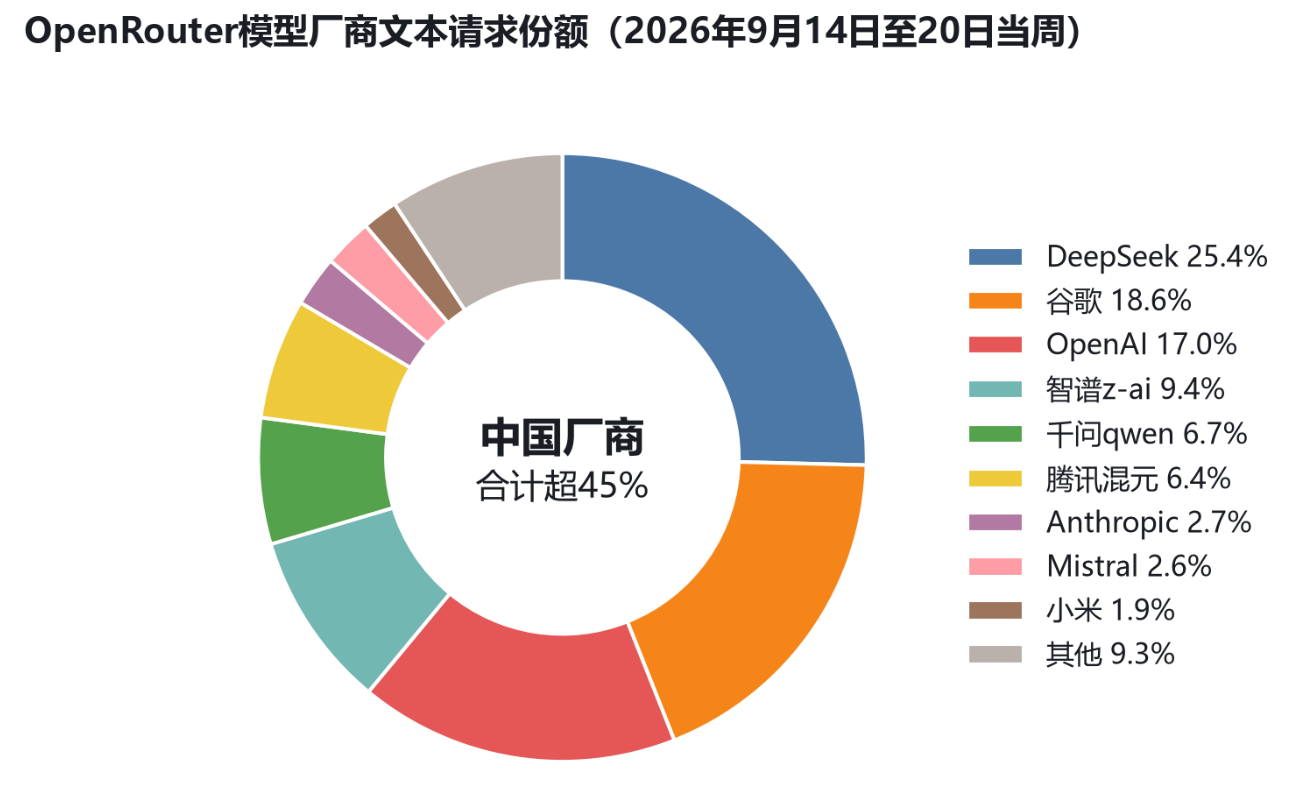
图2:当周模型厂商文本请求份额,中国厂商合计超45%
二、连续21周:一份反超时间线
中国模型的领先并非一夜逆转,而是经历了从“首次反超”到“周周领跑”的完整过程。今年2月,中国大模型在OpenRouter上的周调用量首次全面反超美国——2月9日至15日当周,中国模型录得4.12万亿Token,超过同期美国的2.94万亿Token;到3月9日至15日当周,中国模型调用量升至4.69万亿Token,实现连续第二周领先。从4.12万亿到当周的67.46万亿,七个多月时间,中国模型的周调用量增长了约16倍。
需要说明的是,这一领先并非一路顺风:2月23日至3月1日当周,美国模型曾以3.97万亿Token反超(同期中国3.11万亿);4月13日至19日当周美国4.908万亿对4.441万亿、4月20日至26日当周4.982万亿对4.371万亿,美国连续两周领先;自4月27日至5月3日当周中国重新反超后,领先优势再未易手。8月24日至30日当周,全球周总调用量达113万亿Token、环比增长21.11%,中国大模型以55.16万亿Token实现连续第18周领跑;8月31日至9月6日当周,全球115万亿,中国56.72万亿、连续19周;9月7日至13日当周,全球127万亿、环比增长10.4%,中国近61.2万亿、连续20周——当周美国调用量曾大幅回暖至21.8万亿(环比+31.6%),一度将差距缩小至约2.8倍;但紧接着的一周,美国调用量环比下滑34.7%,中国则继续增长10.28%,差距重新拉大至4.7倍。
值得注意的还有榜单头名的快速更迭:8月31日至9月6日当周,登顶的还是当月新上线的腾讯混元Hy4 preview,周调用量14.7万亿Token、环比增长379%;到9月14日至20日当周,榜首已换成发布仅四天的DeepSeek V4.1 Flash。两周之内,头名两度易主,Flash类新品的密集上线,正在对调用格局形成“即插即用”式的即时冲击。
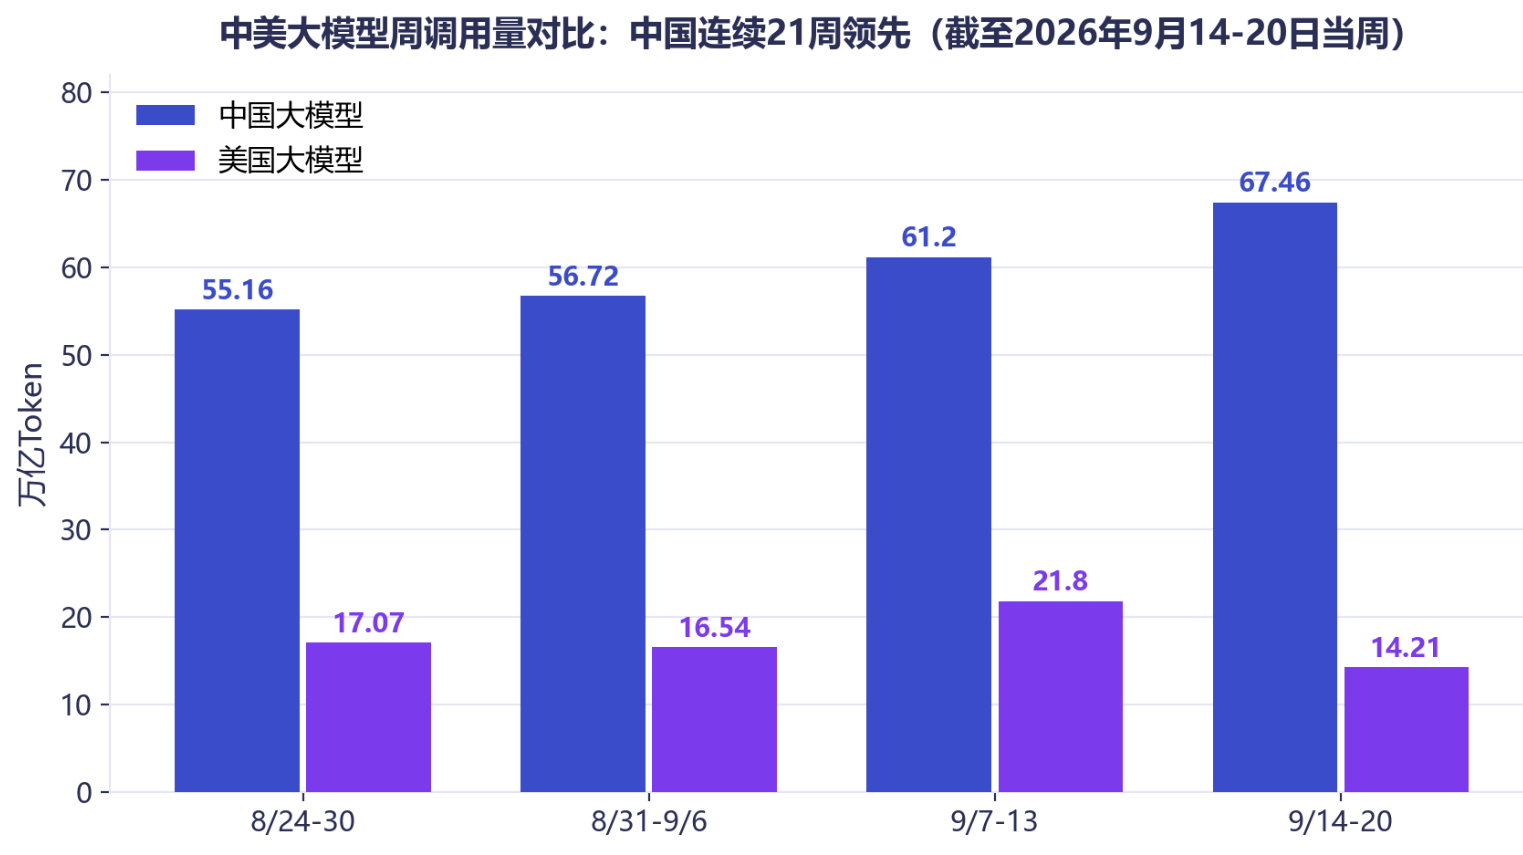
图3:近四周中美大模型周调用量对比(万亿Token)
格局的翻转在一年前几乎不可想象。2025年9月22日当周,OpenRouter调用量第一的厂商还是谷歌,份额约39%,美国厂商合计占比约80%,中国厂商不足20%;一年后的9月,中国厂商整体份额已超过45%,美国厂商降至约43%(含x-ai等归入“其他”的美国厂商,为媒体测算口径)。在这个开发者可以自由选择模型的开放市场上,流量分配的重心已经完成“东移”。
三、登顶解构:DeepSeek V4.1 Flash的“闪电战”
当周最大的变量,是DeepSeek V4.1 Flash的横空出世。9月10日,DeepSeek正式发布这款新架构系列中尺寸最小的模型,并一度计划自9月14日起将原V4 Pro的全部API请求切换由V4.1 Flash承接、按Flash价格计费;但仅一天后的9月11日,DeepSeek应开发者反馈撤销了该计划,宣布9月14日之后继续提供V4 Pro的API调用服务、计费方式保持不变,真正切换至V4.1 Flash的是旧模型名deepseek-v4-flash。模型上新与平台统计周期几乎无缝衔接,直接催化了当周219%的调用增速。
OpenRouter披露的数据勾勒了这场“闪电战”的速度:模型上线24小时内处理了约1万亿Token,48小时内的调用量有望达到约2.8万亿,可能创下平台模型发布48小时内调用量的新高。有开发者感叹:“AI领域的用户似乎在几个小时内、而非几天,就将新模型切换到他们的工作流程和应用中。”媒体则形容,开发者几乎是在“抢着换”。
技术层面,V4.1 Flash采用全新的Causal-Encoder-Decoder(因果编码器-解码器)结构,是一个主干参数5520亿(另含约1960亿Engram稀疏记忆模块)的混合专家(MoE)模型:处理输入时激活80亿参数,生成输出时激活160亿参数,并为读取信息与生成内容分配不同的计算规模;模型原生支持多模态视觉理解,支持100万Token上下文与最大384K输出。这一“输入轻、输出重”的不对称设计,与Agent需要读取大量上下文、再生成有限指令的工作方式高度契合。官方公布的基准成绩显示,V4.1 Flash在科学问答测试GPQA Diamond中取得90.9分,DeepSeek称其在性能、费用、速度等指标上已全面超越上一代V4 Pro,且这套新架构还支持向更大参数规模扩展。
价格是另一个决定性因素。V4.1 Flash闲时定价为每百万Token缓存命中输入0.02元、未命中输入1元、输出4元,较前一代分别下降60%、33.3%和11.1%;高峰时段则分别为0.04元、2元和8元。对于需要反复读取历史对话、工具说明与代码仓库的Agent任务而言,缓存输入的降价直接压低了连续工作的重复开销。OpenRouter数据显示,该模型约90%的调用量来自缓存读取,按市场定价折算成本约每百万Token 0.006美元,比GLM 5.3 Flash等相近模型低约80%。评测机构Arena.ai将其列为Agent Arena开源模型第三名,单任务成本中位数仅0.07美元;与更强的Fable 5等模型相比,其成本降低97%至99%的同时,仍保留了对方35%至54%的净改进效果——而部分顶级模型完成同一任务的成本,是它的37倍至76倍。
值得注意的是,低价并不意味着赔本赚吆喝。据瑞银证券调研,中国模型厂商的API业务毛利率大多处于20%至40%区间——厂商是通过模型架构创新与训练、推理效率优化来兼顾盈利与性价比的。
四、Token ROI时代:中国模型为什么赢下调用量
调用量迁移的底层逻辑,是AI从“尝鲜”进入业务流程之后,成本与产出的权衡成为选型的第一性原则。瑞银证券中国互联网行业分析师熊玮在近期交流中指出,2026年下半年,“Token ROI”(衡量AI投入产出比)正在成为行业讨论的关键词:上半年流行的“token-maxxing”,指不少企业鼓励员工尽可能多地使用AI、以加快内部采用;但一个阶段过后,企业发现AI账单居高不下,且难以衡量Token用量带来的经济价值。于是从年中开始,企业与开发者转向“token optimization”——在性能领先与性价比之间寻求平衡,对AI账单提出更严格的投入产出要求。
这一变化推动模型市场走向分层:对于高价值、高风险的任务,企业仍然愿意使用全球最顶尖的模型;但在真实工作环境中,大量价值密度较低的任务并不需要每次都调用最强模型,却对价格、速度和稳定性更敏感——这恰好是中国模型更容易切入的市场。以公开API价格计,国内主流模型的平均定价约为国际同行的10%至20%。
耐人寻味的是能力榜与调用量榜之间的“剪刀差”。据AI基准测试机构Artificial Analysis 9月中旬的智能指数,前五名仍均为海外模型:Anthropic的Claude Fable 5.1、OpenAI的GPT-6 Astra分列前两位;国产排名最高的智谱GLM-5.3以45分位列第7、与榜首相差8分,月之暗面Kimi K3第9,Qwen3.8与DeepSeek V4.1 Flash分别排在第13、第14位。换言之,中国模型并未在技术能力上全面领先,却成为了越来越多开发者“用脚投票”的选择——今年5月至6月起,海外领先IT企业将中国开源模型纳入实际工作流的趋势明显加快。
开发者的真实感受印证了这一迁移。有开源项目开发者向第一财经表示,其自今年5月起已将工作流全部切换为国产模型,主力是智谱GLM 5.3、阿里千问Qwen 3.8 Max与DeepSeek V4.1 Flash;在他看来,“99.99%的编程任务对GLM 5.3这一档的模型来说,都称不上是较难的任务”——除非涉及渲染引擎、操作系统内核等复杂底层任务,否则没有必要为顶尖模型支付数十倍的成本。
五、产业链传导:从Token洪流到分发、算力与资本
理解这场收购,先要理解OpenRouter本身的角色。作为统一API的模型聚合路由平台,OpenRouter通过智能路由优化推理成本,对外交付的Token调用价格普遍低于厂商官方直连,并以标准化接口与统一的Token计量结算,帮助开发者省去对接多家厂商带来的多账号、多计费碎片化成本;其接入规模也在快速扩张——到8月Stripe公告时,表述已是“来自80多家服务商的400多个模型”。对上游厂商而言,它是最灵敏的调用晴雨表;对下游开发者而言,它是切换模型的最低成本通道。
Token洪流最先漫过的是“分发层”。8月20日,全球支付巨头Stripe宣布收购OpenRouter,交易规模约80亿美元(约合538亿元人民币),由现金与股票组成,成为Stripe迄今规模最大的收购。而就在数月前的5月,OpenRouter完成最近一轮融资时的估值仅约13亿美元(该轮累计募资1.13亿美元,投资方包括Alphabet旗下CapitalG、Andreessen Horowitz等)——短短数月,交易对价已大幅放大。这笔交易被市场普遍解读为对“AI交通枢纽”价值的直接定价:当模型供给高度冗余,谁掌握分发、计量与结算,谁就握住了产业的关键入口。
向上游看,推理需求的膨胀正在重塑算力市场。国内方面,火山引擎今年4月披露,截至今年3月,豆包大模型日均Token使用量已突破120万亿,较三个月前翻倍、较2024年5月首次发布时增长超过1000倍;当时据晚点LatePost报道,全球日均Token消耗超100万亿的公司仅有OpenAI、谷歌与字节跳动三家。头部平台的消耗量级说明,推理侧的算力需求仍处在指数爬坡阶段。
向下游看,Token消耗的结构本身也在变化。国信证券在专题研究中指出,OpenRouter的增长动力正由简单聊天向复杂工作流迁移:随着推理、长上下文与工具调用逐渐成为主流,Token增长更多来自单次任务复杂度的提升,推理需求正在进入由Agent化任务驱动的新阶段。平台应用榜单(当日快照口径)清晰指向同一趋势——调用量居前的应用几乎清一色是编码与智能体类:Hermes Agent(当日1.44万亿Token)、Claude Code(5050亿)、Kilo Code(4930亿)、Cline(4120亿)、OpenClaw(1660亿)、Codex(1500亿)与DeepSeek Harness(1310亿)等。
六、冷思考与展望:129万亿之后看什么
狂欢之余,这份周度榜单的边界同样需要被看见。OpenRouter的统计仅覆盖经由其平台路由的调用,模型厂商自有API、云平台调用、私有化部署以及直接面向消费者的应用均未纳入;其用户以追求多模型统一接入与成本优化的开发者、小微团队为主。因此,129万亿与67.46万亿不能直接等同于全球市场份额,但作为观察开发者真实推理活动的重要窗口,其趋势信号具备稀缺的参考价值。
其一,竞争主线正从“能力单极”转向“效能多维”。当Token ROI成为决策主线,单纯堆参数、刷榜单的叙事正在让位于“单位成本的有效产出”。中国厂商在模型架构(如V4.1 Flash的不对称MoE设计)、缓存定价、峰谷定价上的快速迭代,本质都是围绕效能的工程化竞争——低价并非补贴换量,而是架构与效率优化的结果。
其二,“周抛式”发布节奏下,持续供给能力成为新的竞争门槛。9月1日至11日,海内外7家头部厂商密集迭代模型:Anthropic推出Claude Fable 5.1与Mythos 5.1,谷歌发布Gemini 3.8 Flash,Meta祭出Muse Spark 1.3,OpenAI跟进GPT-6 Astra;国内千问、DeepSeek、Kimi同步提速。模型升级周期从以年、月计压缩至以周为单位,开发者的工作流评估速度已经跟不上发布节奏——谁能留在开发者的“默认选项”里,谁就赢得了下一轮竞争的入场券。
同时也要看到,美国阵营内部正在分化:当周(按OpenRouter官网当周快照口径)OpenAI的请求份额环比下滑30%,谷歌仅微降3%。份额的此消彼长说明,以性价比为轴心的竞争同样在改写美国厂商的座次。
其三,分层市场将长期并存。能力榜的头部位置仍由海外旗舰模型占据,而调用量榜的“中国四席”说明:在更广阔的日常应用市场,高性价比供给已经赢得先手。两条榜单的收敛速度——即中国旗舰模型何时在能力上全面追平——将决定下一阶段竞争天平的方向。
对于129万亿Token这一新纪录而言,比数字本身更值得注意的是其斜率:一年约26倍的平台增速、连续21周的中美反超、以周为单位的模型迭代节奏。全球AI产业的推理经济正在进入深水区,而中国大模型,已经从追赶者变成了规则的重要书写者。