【导语】9月22日,2026云栖大会上,阿里平头哥正式发布新一代自研AI芯片真武V900,算力达到前代M890的三倍;依托自研ICN Switch互联芯片,单一集群可扩展至50万卡,直接瞄准5万亿至10万亿参数前沿大模型。从真武GPU、倚天CPU到磐脉网卡、镇岳存储主控,数据中心核心芯片实现全品类自研;与之配套的,是2032年20GW数据中心目标、三年3800亿元投入与800亿港元港股配股。一场以“全栈+集群+重资产”为关键词的国产算力突围战,正式进入决战阶段。
一、云栖“亮剑”:真武V900刷新国产AI芯片性能天花板
9月22日,杭州国际博览中心,2026云栖大会现场。阿里巴巴集团CEO吴泳铭宣布,旗下平头哥半导体正式发布新一代自研国产AI芯片——真武V900。“这是目前真武系列算力性能最强的AI芯片,整体性能达到前代产品M890的三倍。”吴泳铭在发布会上表示。官方进一步将其定义为当前国内算力性能最强的自研AI芯片。
这一发布的分量,需要放在阿里芯片的演进节奏中理解。2026年1月,平头哥对外披露真武810E(PPU);5月20日阿里云峰会上,真武M890亮相,性能为810E的三倍;仅四个月后,真武V900再次实现三倍跃升。从810E到M890再到V900,两代产品各涨三倍,累计算力提升约九倍,迭代周期从此前的两年压缩至一年。“一年一代”不再是路线图上的口号,而是被工程交付验证过的节奏。
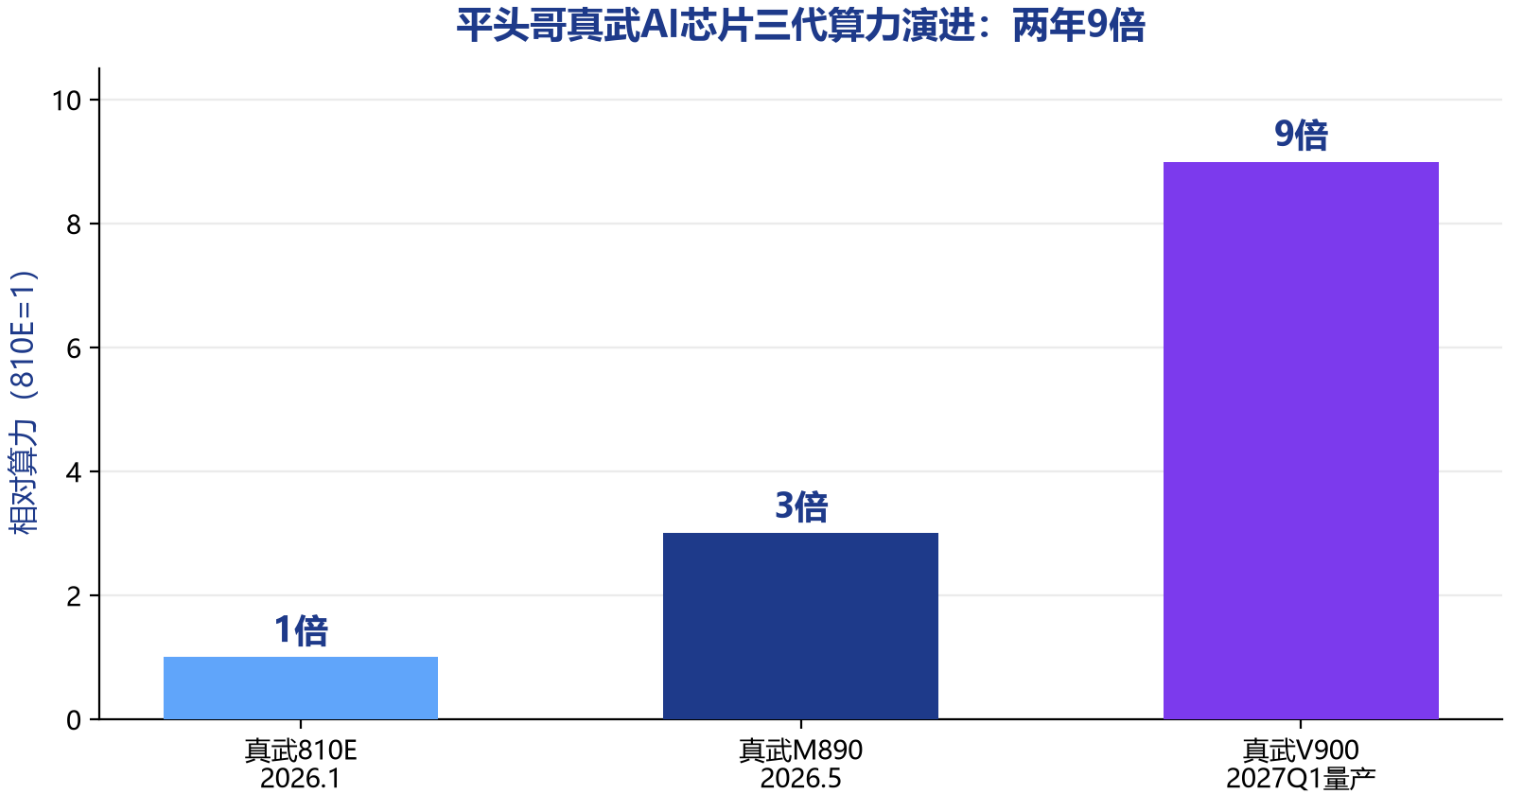
图1:平头哥真武AI芯片三代算力演进(810E=1,两年累计约9倍)
市场对这次“亮剑”给予了直接回应。9月22日盘中,受真武V900发布与全球AI板块集体回暖双重催化,港股阿里巴巴-W(09988.HK)涨幅一度扩大至4%—5%,盘中报约118.3港元,连续第三个交易日上涨,恒生科技指数同步走强。在吴泳铭看来,AI模型、AI芯片和AI云是机器智能时代的三大基石,阿里将坚定投入这三项基础设施,“未来机器思考总量将是人类的1000倍,而今天这一比例不到3%,至少还有几万倍的增长空间”。
二、从参数竞赛到系统决战:216GB显存背后的技术路线
具体到产品规格,真武V900搭载216GB大容量显存,片间互联带宽达到1200GB/s,原生支持FP8、FP4低精度计算,定位训推一体,可覆盖万亿级参数大模型训练、推理全场景。作为对照,今年5月亮相的真武M890内置144GB显存、片间互联带宽800GB/s,原生支持从FP32到FP4的多种数据精度;更早的真武810E则为96GB显存、700GB/s互联带宽。
从成本视角看,显存与低精度的组合还有一层商业逻辑。在推理成为算力消耗主体的阶段,单卡显存越大,越能减少大模型推理时的张量并行切分与跨卡通信,从而降低单次推理的延迟与单位Token成本;而FP4/FP8这类低精度格式,能在保持模型可用性的前提下,让同等硬件获得数倍的有效吞吐。这意味着V900的升级并非简单“堆料”,而是直接对应云厂商最关心的指标——单位投资所能产出的Token数量。这也与阿里“提升整个AI集群Token产能”的官方表述互为印证。
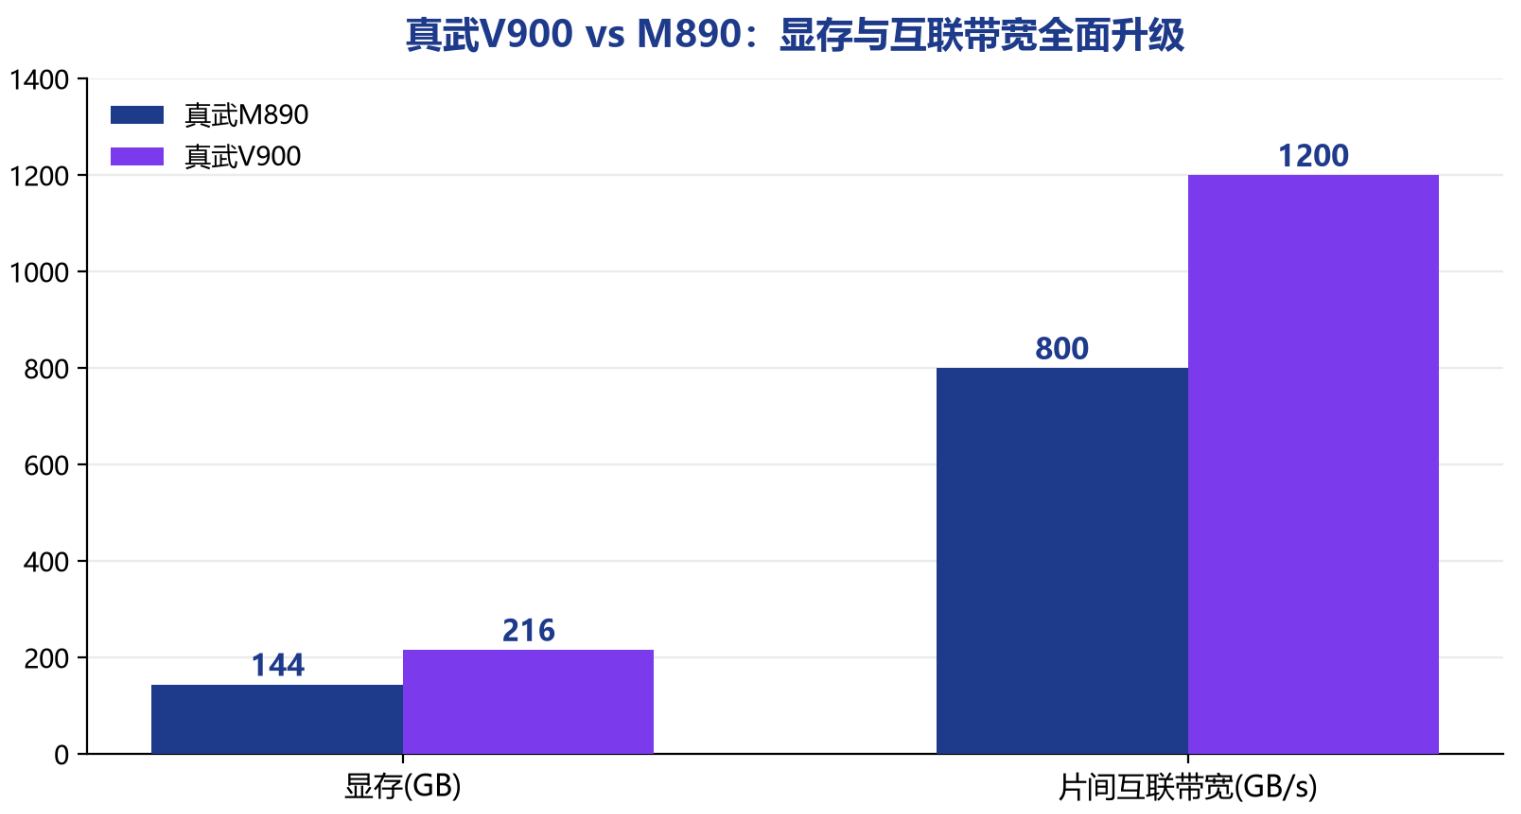
图2:真武V900与M890核心规格对比
显存与互联带宽的同步抬升,指向的正是大模型时代最核心的两个瓶颈。一方面,Agent时代推理负载呈现大规模并发、长链路任务特征,对显存容量和数据搬运能力提出极高要求;另一方面,低精度计算(FP8/FP4)已成为兼顾训练效率与推理成本的行业共识,V900对FP8、FP4的原生支持,意味着其能够以更低的数据位宽换取更高的有效算力。
值得注意的是,阿里并未把叙事停留在单颗芯片的参数竞赛上。吴泳铭明确表示,平头哥的核心研发力量正投向超大规模集群的整体能力搭建。这与行业判断高度一致——国产芯片的性能比拼,正从“单卡性能竞争”走向“系统效率竞争”。当单芯片物理指标逼近工艺与功耗的双重约束,谁能把成百上千颗芯片高效地“粘”成一台超级机器,谁才握有下一阶段的入场券。
三、50万卡超级集群:支撑5万亿至10万亿参数前沿模型
真武V900真正的“大招”在集群侧。依托自研ICN Switch互联芯片,V900可实现千卡全带宽高速协同,上千颗芯片如同单颗超级芯片一样联动工作。官方披露,基于真武V900构建的单一算力集群,最高可扩展至50万卡,能够直接支撑5万亿至10万亿参数级别的前沿超大模型的训练与推理,完成工业级超级集群的技术突破。
作为集群的关键纽带,ICN Switch 1.0基于平头哥自研ICN互联总线协议和PCCL通信库,吞吐量高达25.6Tbps。M890搭配ICN Switch 1.0时,可实现64卡乃至128卡全带宽互联,通信时延被压至150纳秒以下,从8卡服务器、128卡整机柜到超节点可平滑扩展。新一代磐久超节点服务器进一步将真武V900、ICN Switch、磐脉智能网卡和镇岳SSD主控芯片集成于一体,实现算、存、网系统协同,再依托阿里云新设计的智算网络架构完成组网。
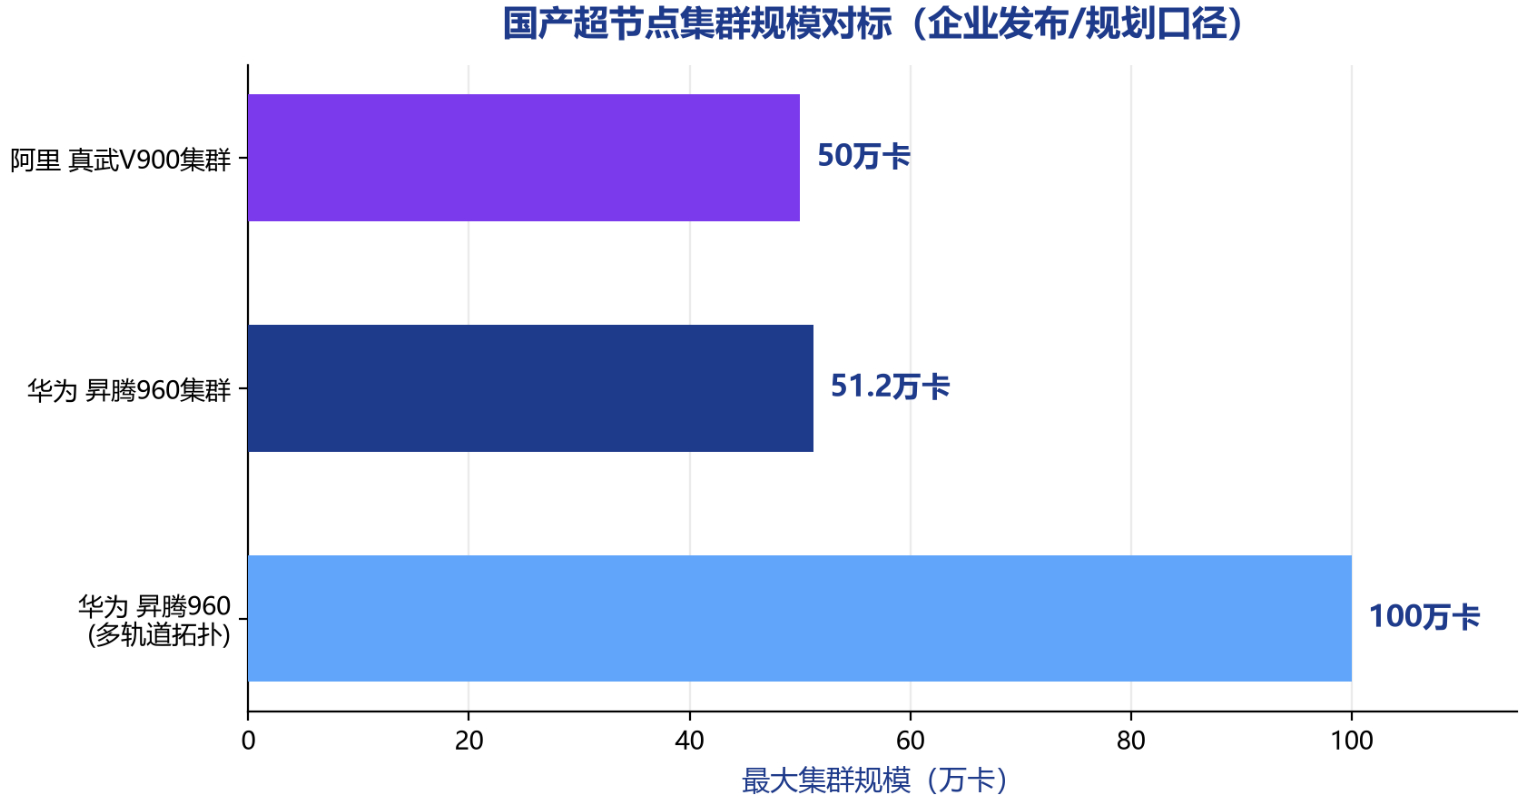
图3:国产超节点集群最大规模对标
50万卡是一个尚未有公开同类国产集群可以对照的量级。据OFweek梳理,此前国内已落地的大规模国产算力集群,规模基本处于十几万卡一档,阿里直接把规划数字抬到新的层面。与之对应,阿里通义千问(Qwen)团队已明确计划训练5T—10T参数规模的全新模型,主攻更复杂、更长程的任务,并在递归式自我改进(RSI)路径上取得阶段性进展。
这套能力并非停留在纸面。此前基于自研M890搭建的AI超节点已在阿里云规模化供给,灵骏真武M890超节点实例GP9A对外提供服务,并成功跑通Qwen3.8、Kimi K3等超过2万亿参数的大模型。今年第四季度,阿里云还将新增大量服务节点,进一步扩大自研超节点的供给规模。超节点之所以成为必选项,背后是训练效率的硬约束:华为马尔科夫实验室仿真显示,由4K超节点组成的10万卡集群,相比由8卡服务器组成的同规模集群,MFU(模型浮点算力利用率)可提升2.75倍——而传统服务器架构下,集群通信往往占用超过40%的训练时间。
四、五大芯片品类集齐:平头哥全栈自研矩阵成型
随着真武V900发布,平头哥数据中心核心芯片的全产品线布局正式成型。目前其产品矩阵覆盖五大品类:真武系列AI芯片(GPU/PPU)、倚天系列服务器CPU、磐脉系列智能网卡、ICN Switch互联芯片,以及镇岳系列存储主控芯片。组建超大规模AI集群所需的核心芯片,已全部实现自研覆盖。
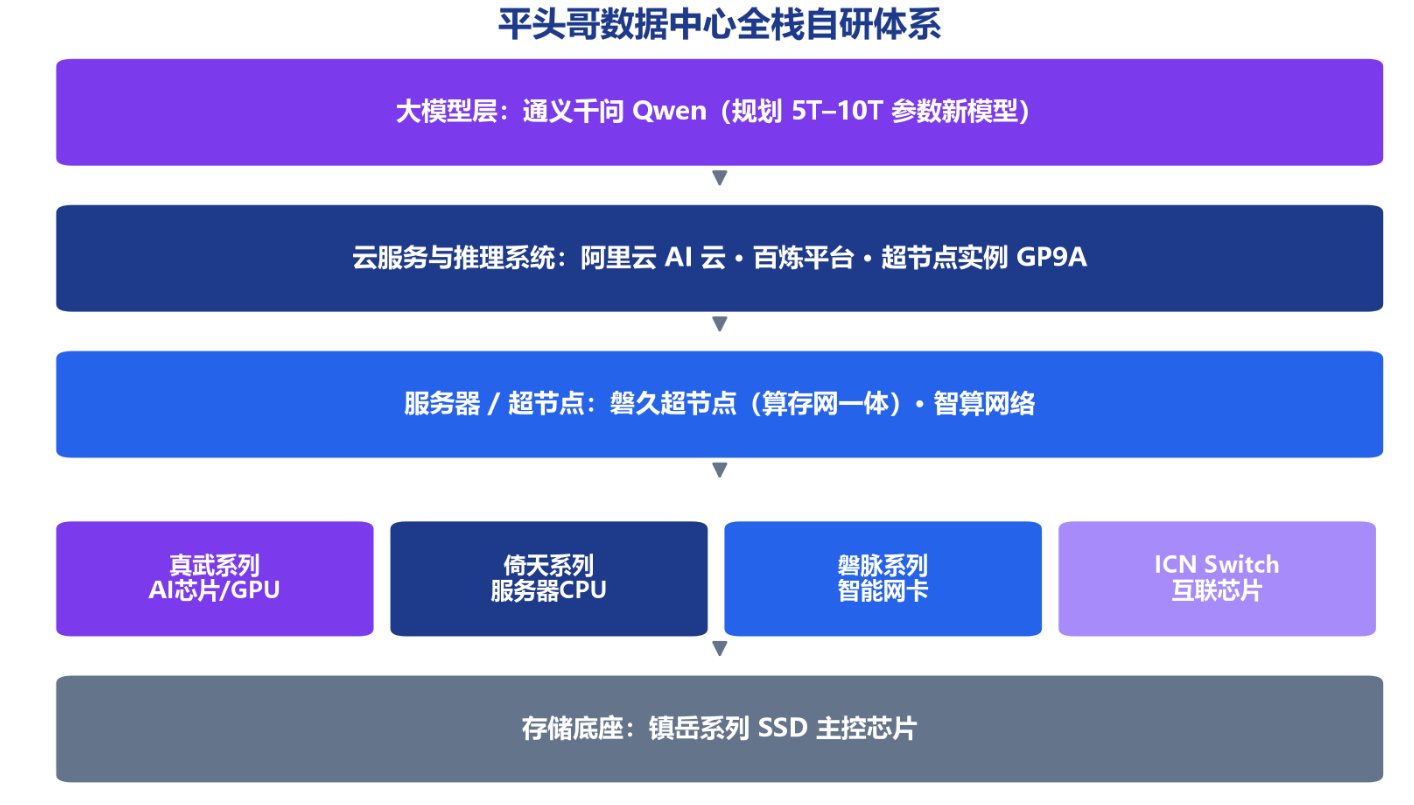
图4:平头哥数据中心全栈自研体系框架
CPU路线图也在本届云栖大会上首次公开。2027年,平头哥将推出倚天720、倚天730两代产品:倚天720全面升级单核性能、核密度与能效;倚天730则首次采用平头哥全自研CPU微架构,单核SPECint2017/GHz性能最高可达倚天710的1.4倍。规划中的倚天750将支持ICN自研互联总线,实现CPU与真武AI芯片直连。在Agent跑长任务的场景下,任务规划、状态管理与工具调用大量压在CPU侧,CPU与加速芯片的直连有望进一步释放软硬协同效率。
全品类自研的价值,最终通过全链路联合调优兑现。阿里正在推进芯片、服务器、超节点、网络、大模型和推理系统的全链路联合调优,从底层硬件到上层软件打通全栈协同,目标是大幅提升整个AI集群的Token产能与运行效率。商业化数据印证了这一路径:截至2026年8月,真武系列芯片已服务超过650家外部企业,覆盖智驾、金融、具身智能、制造等20多个行业,客户包括中国电信、中国一汽、浦发银行等,其中金融行业部署超过10万卡、覆盖150多家机构。
五、3800亿蓝图与20GW目标:算力帝国的资本账本
芯片集中爆发的同时,阿里同步披露了配套的长期算力基建蓝图,目标是完成“芯片—数据中心—云服务—大模型”的全链条内部需求闭环。其中最受关注的,是20GW数据中心远景目标:到2032年,阿里云运营的全球数据中心总容量将超过20吉瓦,相比生成式AI爆发前的水平扩大约10倍,整个体系重点围绕“算电协同”布局,实现算力与电力资源的高效匹配。
资金安排上,据电子工程专辑报道,阿里承诺未来三年投入超过530亿美元(约合3800亿元人民币)用于AI基建建设。需要说明的是,这一3800亿元口径最早可追溯至2025年2月24日——彼时吴泳铭宣布未来三年投入超过3800亿元建设云和AI硬件基础设施,总额超过去十年总和,创下中国民营企业在该领域的最大规模投资纪录;530亿美元是该计划按汇率折算的表述。据最新披露,截至2026年6月季度末,该计划已累计投入约1900亿元。
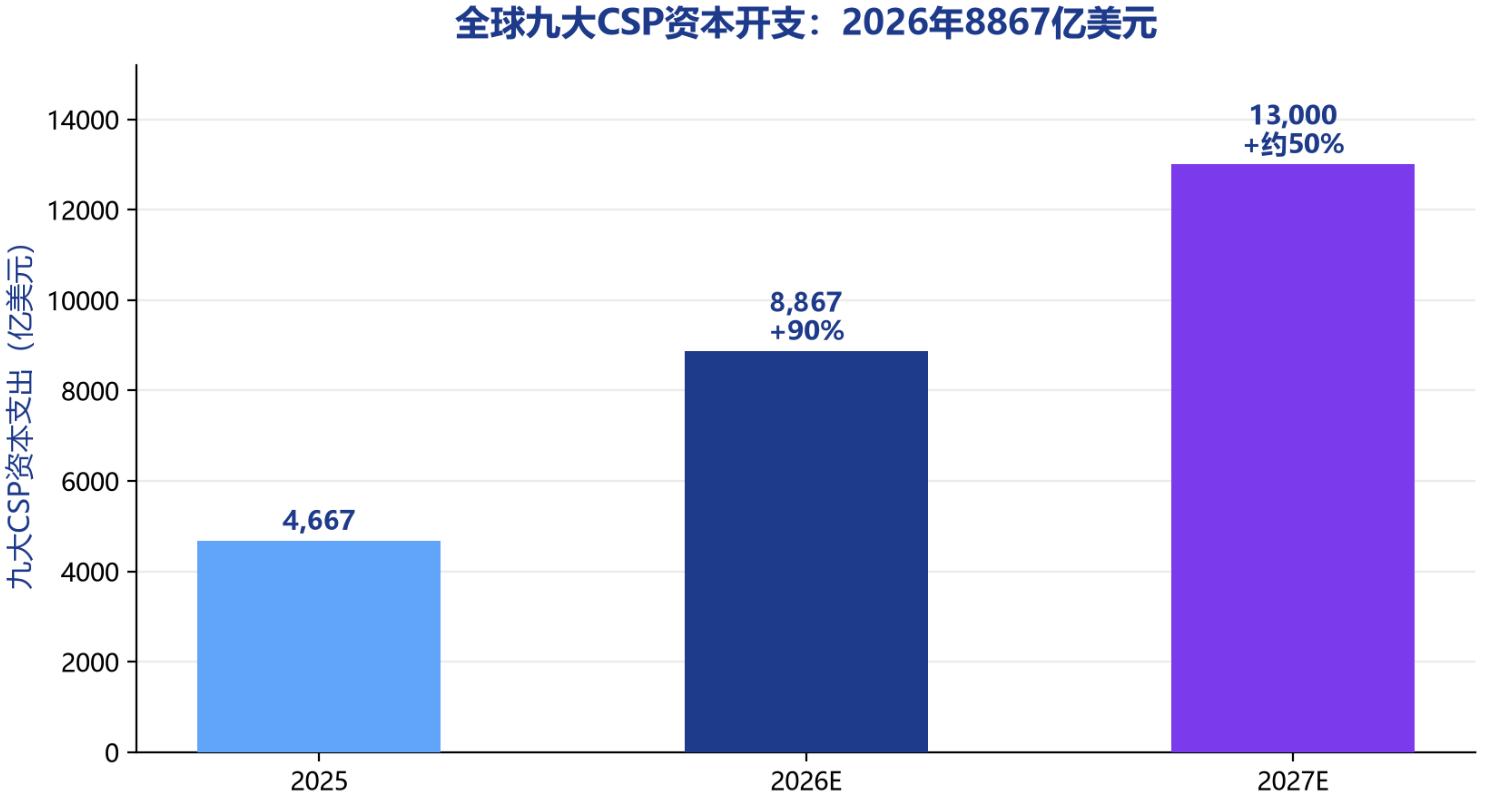
图5:全球九大CSP资本开支规模
把阿里的投入放进全球坐标更能看清位置。2026年全球前九大CSP资本支出约8867亿美元,阿里530亿美元的三年承诺折算到单年,约占这一盘子的2%上下,与Google、Microsoft、Meta、Amazon单年千亿美元级的AI开支相比仍有量级差距,但已显著高于多数中系同行。配股选择以主权财富基金为主要承接对象,也透露出阿里希望用长期资本匹配长周期基础设施、规避短期估值波动的考量。
为给长期扩张储备弹药,阿里在2026年8月完成了一次重磅股权融资。8月23日至26日,阿里巴巴完成香港新股配售,共发行7.1亿股、每股定价112.7港元,募资总额约800亿港元(约102亿美元),为港股有史以来规模最大的公司配售,净额100%投向全栈AI能力与AI基础设施。此次配售启动不到一小时即获超额认购,最终以中东、欧洲、亚洲主要主权财富基金等高质量长线投资者为主;中金、汇丰、摩根士丹利、瑞银参与。蔡崇信与吴泳铭还在8月24日合计增持约1.2亿港元,以表信心。
高强度投入已开始反映在报表与回报上。2027财年第一季度(截至2026年6月30日),阿里资本支出达676.78亿元,同比增长75%;同期阿里云外部商业化收入同比增长45%,创22个季度新高,AI相关产品季度收入123.76亿元、连续第12个季度三位数增长,AI相关产品ARR突破495亿元(约73亿美元),占云外部商业化收入35%,管理层预计下季度ARR将接近100亿美元。面向2030年云外部收入1000亿美元的目标,吴泳铭称按当前毛利水平AI算力Capex三年内可回本,随着自研芯片占比提升,回本周期有望缩短至2.5年甚至2年。
六、对标昇腾、夹击英伟达:国产算力座次重排
真武V900的登场,使国产AI算力的头部竞争格局更趋清晰。最强劲的对手来自华为。在9月17日开幕的华为全联接大会2026上,华为发布全球首个采用NPO(近封装光学)技术的昇腾960超节点:基于“灵衢+Hi-ONE”打造,单个超节点规模4096卡,可提供8 EFLOPS FP8算力和高达1PB的HBM容量;其用5500个Hi-ONE光引擎替代原本约4.8万颗800G光模块,功耗降低超550千瓦,系统可用度达99.8%。组网层面,昇腾960超节点通过二层CLOS四平面组网最大集群规模达51.2万卡,结合多轨道拓扑技术可支持100万卡。
两条路线的差异值得细品。华为走的是“整机+超节点+生态”的系统路线,强调光互联(NPO/Hi-ONE)对系统功耗与可靠性的改善;阿里则是“自研芯片+云服务+模型”的垂直整合路线,芯片既自用上云、也对外供给,目标是让算力直接转化为云收入。前者更像AI时代的ICT设备商,后者更像拥有底层硬件能力的云厂商,两种模式将在后续的商业化与客户结构上持续分化。
出货与市场份额方面,IDC口径显示,2026年第一季度真武PPU出货突破60万片,在国内厂商中排名第二,仅次于华为昇腾;而2025年下半年中国国产AI芯片市场中,华为昇腾位居第一、百度昆仑芯排名第三。华为方面披露,昇腾超节点已部署超过1000套、客户370多家;百度则在2025年12月上线1万卡规模的昆仑芯P800集群并计划扩展。此外,寒武纪、沐曦、燧原、天数智芯、壁仞、清微智能等厂商共同构成了不断扩容的国产阵营。
本土阵营的集体起势,正持续改写英伟达的在华版图。据相关报道,2026财年前三季度,英伟达来自中国的收入仅占总收入的11%,明显低于此前多年约25%的水平;国内已有至少9家AI芯片厂商实现或锁定超过1万颗的出货与订单规模。行业人士提醒,万颗级出货更多意味着进入“大规模交付验证”阶段,反映市场对性能、稳定性与总体拥有成本(TCO)的初步认可,但竞争格局尚未定型,竞争焦点已从单纯跑分转向系统可靠性、软件生态与商业化能力。
资本市场的看法则呈现明显分化。配股消息公布后的首个交易日(8月24日),阿里港股一度下跌约8.4%;知名投资人迈克尔·伯里(Michael Burry)公开清仓阿里、转投京东,担忧其投入资本回报率(ROIC)持续下降,彭博行业研究也质疑其AI业务可能沦为回报微薄的“基础设施型业务”。不过,美银证券指出,配股将使阿里净现金由310亿美元提升至410亿美元以上,并维持买入评级;野村证券则认为约7.1亿股新股对现有股东的摊薄仅约3.7%,实际冲击远低于市场预期。多空分歧之下,3800亿投入的长期回报仍是市场反复审视的核心命题。
七、超节点时代:从单卡突围到生态之战
将视野拉到全行业,阿里此次“亮剑”并非孤例,而是全球AI基础设施进入超大规模升级周期的一个缩影。TrendForce数据显示,2026年全球九大CSP——Google、Amazon、Meta、Microsoft、Oracle以及字节跳动、腾讯、阿里巴巴、百度——总资本支出将突破8867亿美元,年增约90%;其中四大中系CSP合计资本支出年增逾80%。展望2027年,九大CSP资本支出预计扩大至约1.3万亿美元,年增率收敛至近50%,主要反映高基数效应而非投资趋势逆转。
结构上,AI产业成长正从单一的GPU扩张,转向AI服务器、液冷散热、先进封装、高速互联、电源与存储等基础设施的全面升级。TrendForce将2026年AI服务器出货年增幅由28%上调至近31%;Google、AWS新一代自研ASIC平台将于2026下半年陆续放量,自研芯片以降低基础设施成本、提升推理效率,已成为中美头部厂商共同的战略选择。
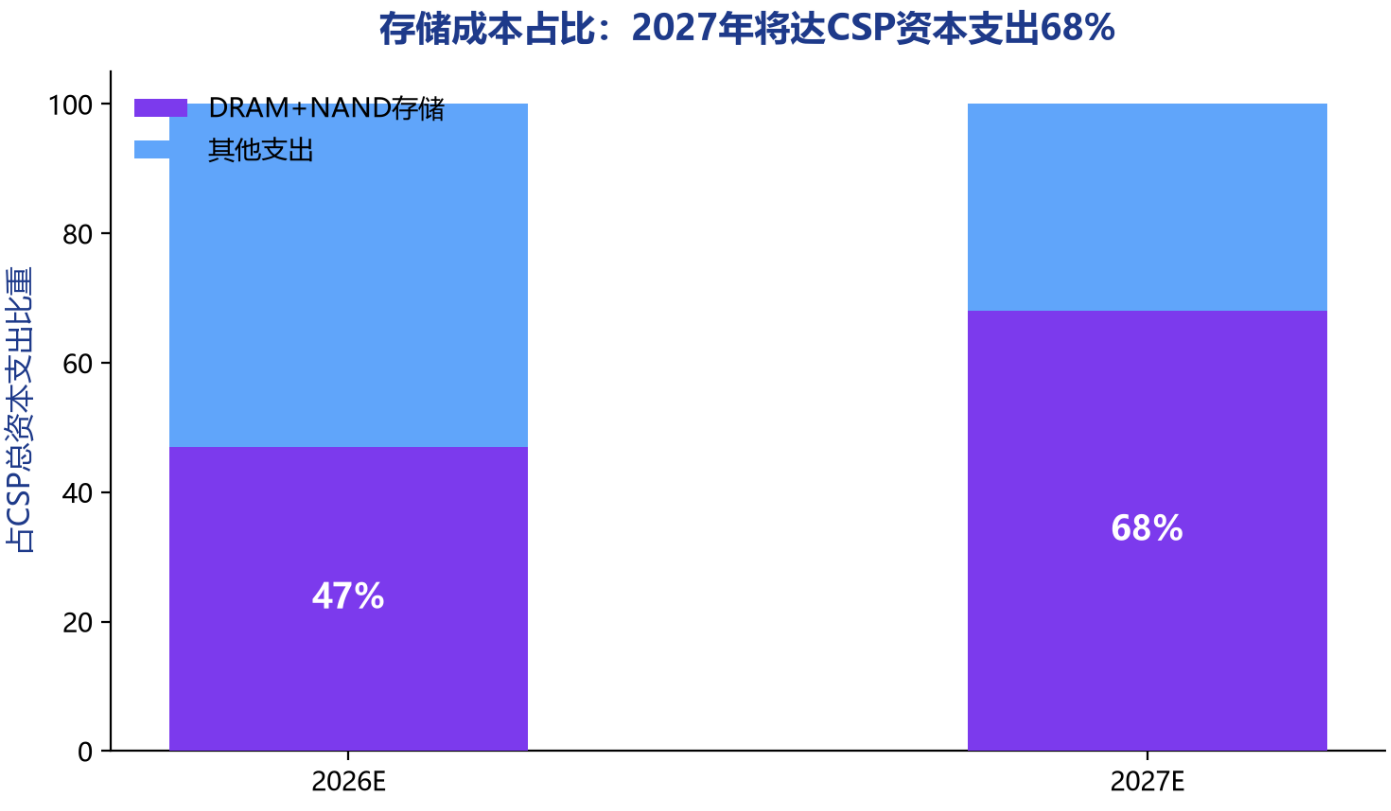
图6:DRAM与NAND占CSP资本支出比重
成本侧最大的变量来自存储与电力。TrendForce预计,DRAM与NAND合计占CSP总资本支出的比重将从2026年的47%升至2027年的68%;服务器DRAM合约价在2025下半年累计上涨约64%后,2026年预计再涨约270%,2027年HBM合约价仍可能上涨70%—140%。电力侧同样紧绷:TrendForce预估2026年全球数据中心电力需求容量达161GW、同比约31%,AI服务器占整体需求容量33.4%;安联投资报告预计,到2030年AI数据中心将贡献全球新增电力需求约10%。这也解释了阿里为何把“算电协同”与20GW目标置于蓝图核心。
必须正视的是国产路线的现实约束。受先进制程设备出口管制影响,国内在6nm/5nm及以下节点只能依靠ArFi浸没式DUV多重图形化(SAQP)硬推,SemiAnalysis测算其精细金属层光刻制造成本增加55%—60%,分摊至整片晶圆的物理成本溢价约20%,且缺陷密度较高、良率受限。这决定了国产算力很难在单卡物理性能上简单复制海外路径,而必须以系统架构、集群效率和供应链协同形成差异化竞争力。
生态则是终局之战的关键。2026年7月23日,平头哥宣布开源自研AI软件栈T-Head SAIL;此前华为已于2025年8月推动CANN全面开源。两大头部厂商相继开放软件栈,意在对标英伟达CUDA长期构筑的生态壁垒,降低国产芯片的适配门槛。此外,彭博社2026年6月曾报道阿里筹备平头哥独立上市,拟先将其重组为员工持股实体;吴泳铭回应称平头哥不排除IPO,但暂无明确时间表。
从真武810E到V900,从128卡超节点到50万卡集群,从3800亿承诺到20GW蓝图,阿里已用一年时间证明了其在AI基础设施上的组织与工程能力。但重资产投入能否如期转化为云收入与利润增长、自研生态能否跨越CUDA壁垒、50万卡集群能否从规划走向稳定运行,仍有待时间检验。可以确定的是,国产算力的竞争已彻底告别“单卡突围”的旧叙事,进入全栈、集群与生态协同的系统决战期。