当地时间 9 月 21 日,AMD 股价盘中一度涨近 10%,触及 615.99 美元的历史新高,市值首次突破 1 万亿美元,成功跻身全球半导体行业 "万亿美元俱乐部"。
这份来自资本市场的认可并非偶然。随着智能体 AI 从概念走向规模化落地,云服务商与大型科技企业对 AI 基础设施的采购节奏正在加快,推理算力需求进入爆发式增长通道,市场正在重新评估平台型AI基础设施企业在智能体时代的核心价值。
这一幕,正是 AI 产业重心迁移的最新注脚。如果说前几年焦点都围绕训练端的模型、算力、参数,那么当模型能力逐渐成熟,AI应用开始规模化落地后,推理渐渐占据C位。
从数据上看,2026年,全球AI算力容量的约60%将用于推理,超过训练;而过去两年间,全球每月消耗的Token量增长了约158倍。
当AI正在走向规模化应用和部署之时,也催生了底层AI基础设施的构建逻辑。自今年7月在旧金山举办Advancing AI 2026(AAI 2026)大会以来,AMD的一系列动作,正是在给出自己的答案。
从第六代EPYC处理器到Instinct MI400系列GPU,从Pensando网络到ROCm软件,再到机架级的Helios系统,还有多笔重量级收购和合作官宣。这家AI行业的领军企业,正在通过强化其全栈AI的能力,将AI创新推向规模化部署,其自身也在加速从单一芯片厂商向平台型AI基础设施厂商角色的进阶。
正如AMD董事会主席及首席执行官苏姿丰博士所言,“AI的下一阶段将涵盖前沿模型、智能体与物理AI,创造将智慧普及至各处的全新机遇。”
“AI Everywhere”的愿景,正在加速到来。而AMD的价值和行业领导力,也随之愈发凸显。市值破万亿美元,或许只是AMD新篇章的开端。
CPU:迈向更重要的核心角色
智能体时代,有别于过去简单的AI问答式交互,具有更多主动响应的需求。这种“感知、思考、执行”的方式,从底层链路看,让一次任务的完成变成了一条复杂的流水线。以前GPU负责算、CPU则为整个计算系统提供坚实的基础支撑,但现在,CPU的重要性再一次得到凸显。
AMD将智能体时代的数据中心服务器重新划分为三类角色:通用型CPU服务器承担Web服务、缓存、应用与数据库等传统负载;GPU服务器作为“主机节点”,由强劲的CPU与GPU协同专注推理与生成;而CPU“沙盒”服务器则是一个全新定位,专门负责智能体的编排控制与工具执行。
在这个新分工中,CPU的角色被前所未有地放大。从最显见的数量角度,行业目前的判断是,过去数据中心CPU与GPU的配比将从过去的1:8、1:4,不断向1:2、1:1靠拢,更加强调同GPU之间的性能和角色平衡。
AMD敏锐地捕捉到了这一变化,第六代AMD EPYC处理器(代号“Venice”)的登场也显得恰逢其时。
作为面向智能体AI的最广泛服务器CPU产品组合,第六代EPYC拥有领先的单核性能和最高的线程密度,不仅能够实现每瓦、每美元、每机架最多的智能体数量,它提供的速度和内存带宽也足以让加速器始终“吃饱”,同时,它又以领先的性能和能效运行关键业务应用和AI辅助任务。
可以说,第六代EPYC处理器不仅能够从容应对云、企业和HPC更工作负载,更是为智能体AI量身打造的高效管理与调度中枢。
过去几年,凭借制程、架构和系统优化方面的多维度创新,以及强悍的执行力,AMD在服务器CPU市场高歌猛进,客户也不断投出信任票。
Meta已经在其基础设施中部署了数百万颗EPYC处理器,并成为“Venice”的首批客户。微软、Oracle等企业也宣布将实现规模部署。
在AI基础设施领域,对于一家承担“调度中枢”角色的平台型公司来说,这种长期建立起来的市场信任,恰恰是最不容易被复制的东西——这也是AMD在AI领域领导力的一个侧面。
网络与存储:隐形基石
一套真正的全栈AI平台,并不是仅包括那些显眼的CPU、GPU部分。网络、存储、推理能力同样是核心竞争力的重要组成部分,可以说是“隐形基石”。针对上述领域,AMD也通过积极布局,夯实平台基础。
网络方面,AMD Pensando在Helios机架级解决方案中承担着前端、纵向扩展和横向扩展网络的关键角色。在吉瓦级部署中,成千上万的计算单元需要高效协同,网络带宽和延迟直接决定了整个集群的有效算力。Pensando的存在,让AMD能够从芯片内部一直优化到机架之间的数据流转,而不是把网络交给第三方拼凑。
内存方面,2026年6月,AMD宣布收购MEXT——一家AI驱动内存优化技术的领先企业,着力于存储能力的提升。MEXT开发的创新AI预测内存技术,旨在让闪存表现得更像DRAM,在保持性能和能效的同时扩展可用内存容量,有望降低基础设施成本、提高资源利用率,加速AI部署。
如果说训练是AI的“起点”,那么推理就是AI真正产生价值的“终点”。随着AI进入更多实时、高吞吐量的应用场景,推理正成为AI市场中增长最快的细分领域之一,而工作负载也变得日益专业化。
2026年8月,AMD宣布达成收购Taalas的最终协议。Taalas是专用AI推理芯片领域的先驱,其技术通过优化推理数据流,显著降低通用架构相关的计算和内存瓶颈,实现高度优化的AI推理能力。AMD计划将Taalas技术整合到其加速器路线图中,并与AMD GPU一起开发系统级解决方案。
可以看到,从通用计算到专用推理,AMD正在用一套“组合拳”回应一个日益分化的市场:没有任何一种芯片能通吃所有场景,而AMD希望打造的全栈AI平台的价值恰恰在于让客户各取所需,让每一种AI工作负载都能够找到灵活部署的合适算力。
机架系统:重新定义部署单元
如果说EPYC CPU和Instinct GPU构成了智能体数据中心的脊梁,网络、存储技术是构成数据流转的血液,那么机架级系统则是AI规模化部署的新单元,是集众多创新于一身的完全体。
随着AI模型对算力的需求呈指数级增长,传统的“一台服务器一台服务器堆叠”的方式正在触及瓶颈。前沿AI的交付需要一套完全集成的机架架构,让堆栈中的每一个部分都协同推进性能的边界。AMD Helios机架级解决方案正是为此而生——它将高性能Instinct MI455X GPU、第六代EPYC CPU、AMD Pensando前端/纵向扩展/横向扩展网络以及AMD ROCm开放软件协同优化,整合为一个完整工程化的机架级平台。
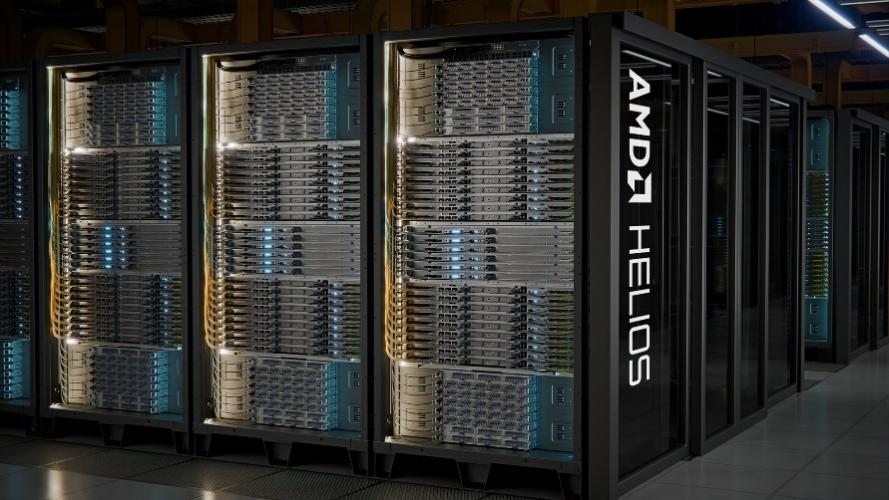
Helios的意义不在于某一个部件的参数,而在于它代表了一种架构理念的转变:把机架本身作为一个被设计、被优化、被交付的整体。它基于Meta通过OCP(开放计算项目)推出的Open Rack Wide(ORW)开放机架标准构建,将AMD对开放性的承诺从芯片和软件延伸到了系统、机架乃至大规模集群。
这种开放的机架级架构正在被全球领先的AI实验室和云服务商选择。OpenAI预计将在2026年下半年开始通过多个部署合作伙伴将Helios上线,并在2027年加速部署——这是双方在2025年10月宣布的6吉瓦GPU部署的第一阶段。Meta则在为吉瓦级部署进行联合工程设计,已经对Helios进行早期访问测试,双方工程师在硬件、软件、系统集成层面并肩工作。Anthropic更是宣布将部署高达2吉瓦的基于Helios的解决方案。
微软、Oracle、HUMAIN、Tensorwave、Vultr、Cirrascale等云服务商也在选择Helios;Bull、HPE、Lenovo、Supermicro等OEM以及Sanmina、Wiwynn等基础设施合作伙伴将提供相关系统。从单一机架到多机架集群,Helios正在成为AI规模化部署的通用语言,也足见市场对其的青睐。
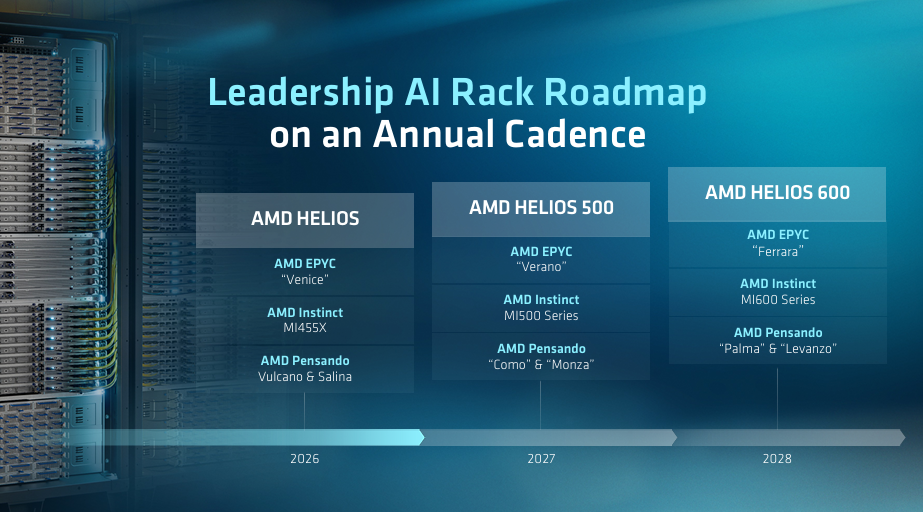
按照AMD的路线图,Helios 500机架解决方案将由下一代Instinct MI500系列GPU和EPYC“Verano”CPU驱动,Helios 600则将搭载更新一代Instinct MI600系列GPU、EPYC“Ferrara”CPU和新一代Pensando网络。
从Helios再到Helios 600,AMD机架级方案的演进路线清晰而连续,计算、CPU与网络每一代同频迭代,为业界持续注入着期待与信心——而机架级方案本身,也正是AMD在数据中心领域雄心壮志与全栈AI技术领导力的最集中体现。
软件生态:真正的护城河
硬件的堆叠如果没有软件加持,如同肉体没有灵魂,AMD对此有清醒的认知。软件与生态,往往是构建AI基础设施厂商最大的护城河所在。
多年来,AMD持续投入ROCm开放软件平台的生态建设——从推出HIP可移植性层降低CUDA代码的迁移门槛,到逐步完善对PyTorch、TensorFlow等主流框架的原生支持,再到不断扩展硬件覆盖范围、优化开发者工具链与文档体系,AMD一直在做一件看似缓慢却至关重要的事:让更多开发者能够低门槛地在AMD平台上构建和部署AI应用,把越来越多的开发者汇聚到开放生态的旗下。
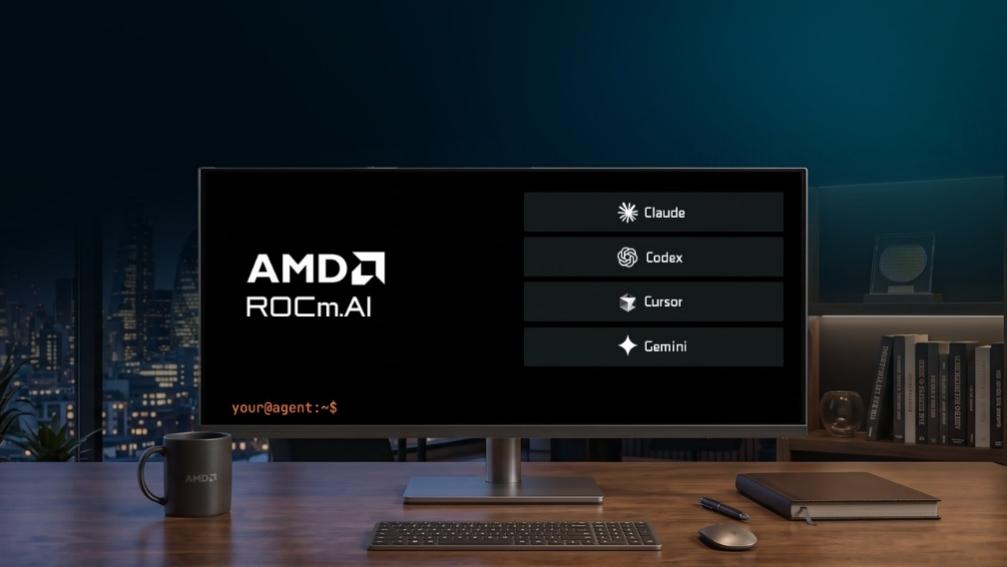
正是在这一长期积累的基础上,AAI 2026上推出的ROCm.ai成为水到渠成的一步——它让Claude、Codex、Cursor等主流编码智能体原生理解AMD平台和ROCm,开发者不再需要手动适配底层接口,AI辅助的GPU编程能力被直接交到每一个人手中,生态门槛被进一步拉低。
AMD软件生态的核心逻辑清晰可见:降低门槛、汇聚开发者、让AI本身成为加速生态进化的工具。而支撑这一切的底层路线,是AMD一以贯之的开放策略。
在AI基础设施日益走向封闭的当下,AMD始终相信只有开放的标准、开源的软件和可互操作的生态才能给客户真正的选择权。这种开放贯穿全栈——ROCm本身是开源平台,主流开源框架在AMD平台上原生可用;Helios基于OCP开放机架标准构建,把开放性延伸到硬件系统。
从软件到硬件、从框架到标准,AMD把开放变成了可落地的技术路线,客户可以自由组合、灵活迁移,不必被锁死在某一家的生态里。当软件、标准与客户在同一个开放体系内协同进化,硬件的每一次进步才能真正转化为用户可感知的应用性能,这也是AMD全栈战略中最容易被忽视、却最具长期价值的一环。
结语
站在现在的时间点回看,AMD自AAI 2026以来,面向AI基础设施频频落子的棋局,脉络正逐渐清晰。
从训练到推理,从CPU到GPU,从网络到内存优化,从芯片到机架级系统,从软件到生态,拼接成一张完整的全栈AI的版图,在这个过程中,AMD也逐渐成长为面向下一代AI基础设施所需的平台型公司。
当AI从创新走向规模化部署,将智能带到每一个角落,越来越多行业需要的不再只是某一颗“最强芯片”,而是一个开放的、可扩展的、协同进化的平台。而当一家公司能够同时定义芯片的路线图、机架的标准、软件的生态和为客户带来更多选择时,它所展现的已经不是某个产品的领先,而是一个时代的领导力——而这,正是AMD正在书写的答案。