导语 9 月 23 日,灵初智能正式发布新一代具身基础模型 Psi-R2.5。这次发布的关键词不是更大的参数量,而是一条被推倒重来的数据链路:以「强 Pair Data」为核心,重新回答具身智能最昂贵的问题——数据从哪里来、值多少、怎么用。两年前,一台机器人学会一个固定任务约需采集 50 次真机示范;今天,人示范一遍,机器人就能以类 Prompt 的上下文方式完成新任务。数据范式的转折点,可能就在这次发布里。
一、引言:从 50 次示范到一遍示范——数据范式的转折
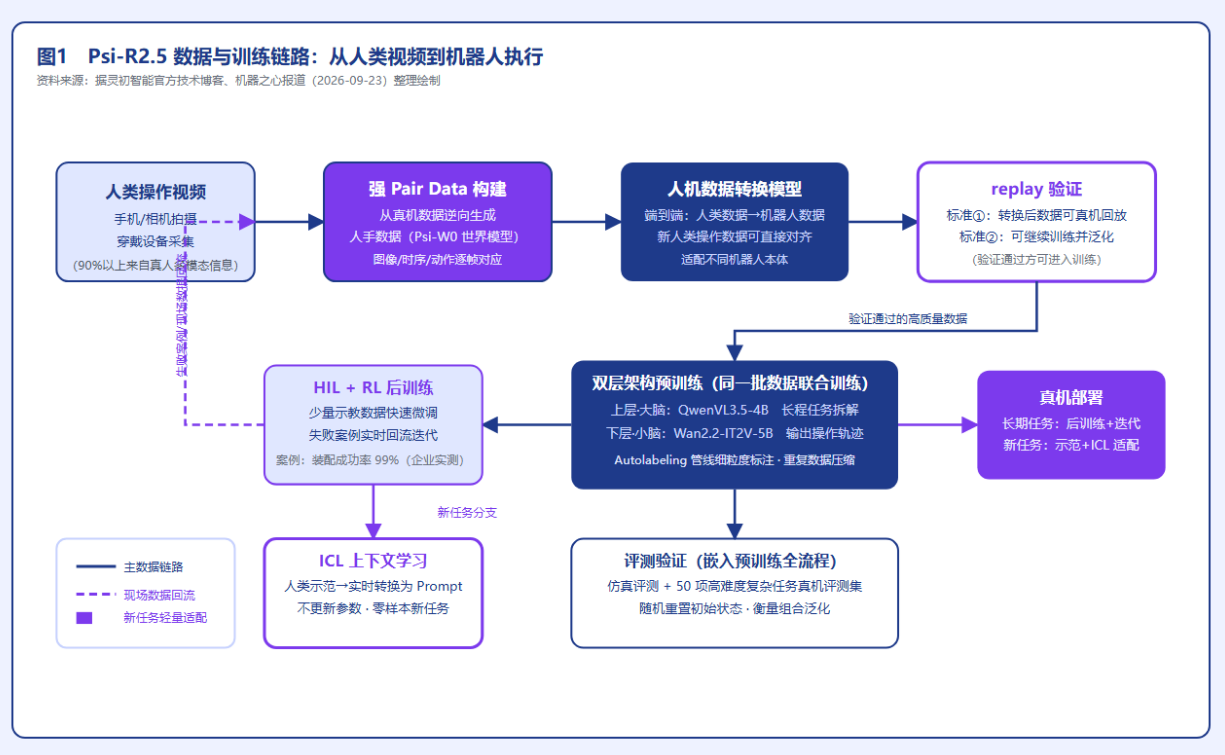
2024 年,一段机器人炒虾的视频让具身智能出圈,但彼时的技术范式也在此后暴露出代价:为了让机器人学会一个固定任务,行业通常需要采集约 50 次真机示范。每个新任务都要重新采集、重新训练,数据产能成为任务扩展速度的天花板。
9 月 23 日,灵初智能发布 Psi-R2.5,给出了另一种答案:演示中,人类示范一遍操作,无需重新训练或微调,机器人即可将该操作作为类 Prompt 的上下文(In-Context Learning,ICL)完成新任务。从 50 次示范到一遍示范,变化的不只是数字,而是任务的输入成本结构——新任务的数据需求从「重采集」变成「轻示范」。
这背后是 2026 年具身智能行业竞争重心的整体迁移。多家产业观察指出,行业竞争焦点已从硬件本体转向数据;在数据的分工上,人类数据因成本低、采集灵活,更适合承担规模化预训练的角色,而真机数据则在精细微调上发挥更大作用。
二、产业背景:真机数采成本之困,与人类数据的机遇
理解 Psi-R2.5 的发布逻辑,需要先看清具身智能行业的「数据账本」。
真机数据贵。 据行业人士测算,一条 30 秒真机操作数据的采集成本约 10—15 元,采集 1 小时约 1000 元;若要凑够 20 万小时训练数据,需投入 2 亿元以上。对大多数创业公司而言,这条路径的资金门槛难以承受。
行业家底薄。 ACE Robotics CEO 王晓刚在接受路透专访时表示,全行业积累的真实机器人数据总量约 10 万小时,远不足以训练具身智能基础模型。许多企业仍在通过实体遥操作训练人形机器人——穿戴外骨骼的数采员每天重复数百次动作,本质上是把人类技能「手工搬运」进数据集。
仿真数据难挑大梁。 仿真路线则受 Sim-to-Real 差距制约,更适合预验证与补充增强,难以承担主力数据角色。这一判断与斯坦福 HAI 的评测数据相互印证:据斯坦福 HAI《AI Index Report 2026》,机器人操控任务在仿真环境中的成功率为 89.4%,而在真实家庭场景中降至 12%——「仿真到现实迁移鸿沟」达 77 个百分点。
三条路都各有瓶颈,人类数据因此被推到了台前。人类数据成本低、采集灵活、可规模化。但人类数据要真正进入机器人训练流程,必须跨过一道门槛——人与机器人本体之间的差异,即具身鸿沟(Embodiment Gap)。这正是 Psi-R2.5 技术叙事的起点。
三、技术拆解:Embodiment Gap 与强 Pair Data 的「逆向构建」逻辑
人类数据不能直接喂给机器人,原因在于两类具身鸿沟:
· 视觉具身鸿沟(Visual Embodiment Gap):人手与机械手的视觉差异、相机拍摄参数不同、环境视角变化,导致同一动作在像素层面几乎无法对齐;
· 动力学具身鸿沟(Dynamic Embodiment Gap):手部姿态估计误差、人手与机器人关节的运动学差异、人机材质摩擦系数等物理参数误差,让「看起来一样」的动作在物理世界执行结果完全不同。
行业普遍的应对是按任务语义收集人机数据对,即「弱 Pair Data」——两段数据只是描述同一个任务,帧级细节并不同源。灵初智能在 Psi-R2.5 中提出的则是「强 Pair Data」:成对的人类数据与机器人数据,除本体外观差异外图像基本一致、时序逐帧对应、机器人动作可直接在真机 replay 复现。
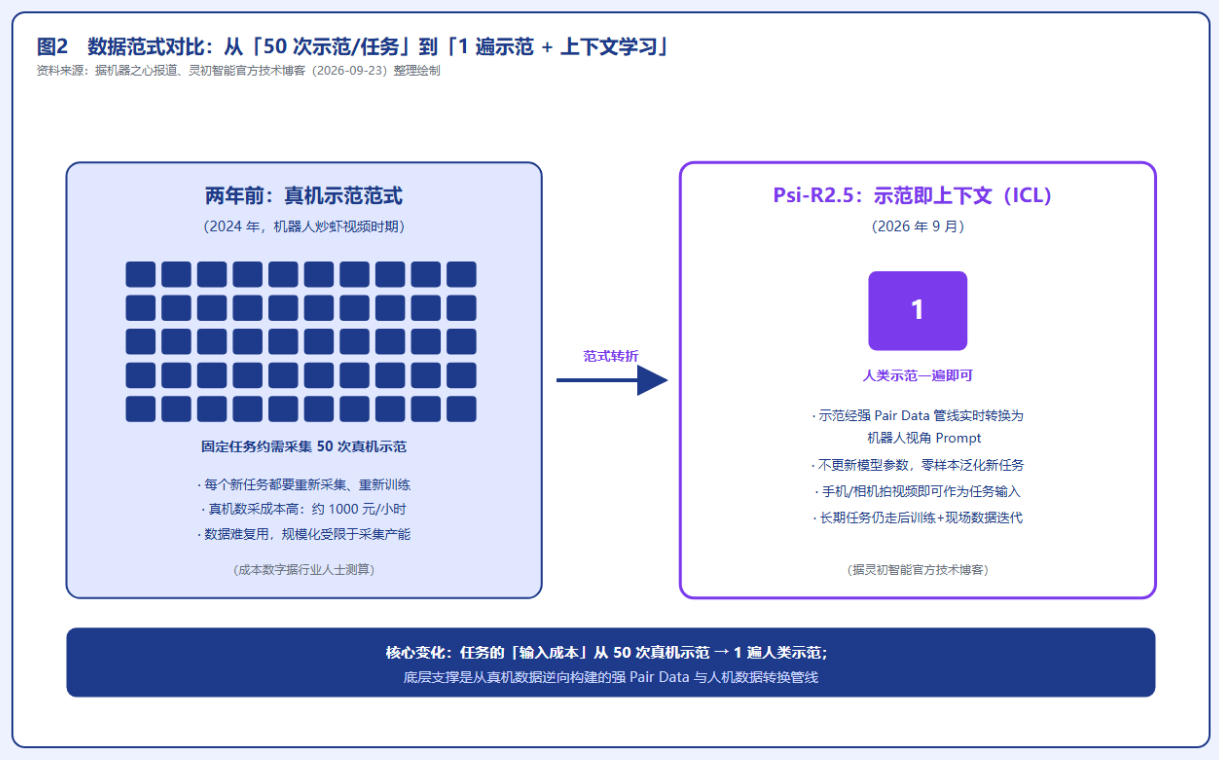
构建方式颇具逆向思维:不从人类数据出发去模拟机器人,而是从真实机器人数据出发,反向调用 Psi-W0 世界模型,批量逆向生成逐帧对应的人手示教视频,由此量产强 Pair Data;再用这些成对数据,蒸馏训练一个带 action 的端到端「人类数据→机器人数据」转换模型。此后,新采集的普通人类操作视频——用手机或相机拍摄即可——可直接经该管线转换成适配不同机器人本体的训练数据。
转换是否可信,灵初设置了两条硬性验证标准:其一,转换后的机器人轨迹可直接在真机上回放复现任务;其二,基于转换数据做继续训练,可稳定泛化到同类新任务。换言之,人类数据只有「能 replay、能训练、能泛化」,才算进入了训练闭环——这也与灵初对「高质量人类数据」的官方定义一致。
这条链路的意义在于,它把 2026 年 4 月已铺开的 10 万小时量级人类数据储备从「静态资产」转化为「可执行数据」——这正是本次发布所宣称要解决的两个核心问题:哪些数据真正有价值,以及怎样让人类数据更顺畅地进入训练过程。
四、架构与训练体系:双层模型 + HIL/RL 后训练 + ICL 三层递进
在数据链路之上,Psi-R2.5 的架构与训练体系呈三层递进结构。
第一层:预训练。 Psi-R2.5 采用双层架构:上层「大脑」以 QwenVL3.5-4B 为骨干,负责长时序任务理解与拆解,将指令分解为子任务并向下层传递任务子文本与价值优先级;下层「小脑」以 Wan2.2-IT2V-5B 为骨干,结合观测输出连续稳定的操作轨迹。两层模型使用同一套高质量预训练数据联合训练。
第二层:HIL + RL 后训练。 针对「快速学会一项工作」,灵初构建了 HIL(人在回路)+ 强化学习后训练框架:仅需少量示教数据即可快速微调,部署中出现的失败案例实时回流、迭代模型。官方给出的实测案例是手机盒装配:直接模仿学习成功率很低,经 HIL 与后训练 RL 几轮迭代后,成功率提升至 99%,全程仅需 1—2 个工作日。
第三层:ICL 上下文学习。 针对「现场学会新工作」,人类示范视频经强 Pair Data 管线实时转换为机器人视角的 Prompt——机器人读到的不是文本,而是真实场景的人类示教视频——模型不更新任何参数,即可零样本泛化完成新任务。
两种能力的分工由此明确:长期稳定的任务走后训练与现场数据迭代,追求性能上限;新任务走示范与上下文学习,追求接入速度。澎湃新闻的报道进一步勾勒出灵初的三阶段技术路线:预训练打基础能力,后训练学会一项工作,上下文学习在现场学会新工作,而贯穿三层的底层能力,正是人类数据到机器人数据的转换。
值得关注的是灵初技术负责人的一个反常识判断:对具身预训练模型而言,模型架构是「最不重要的,两三天就能换一个」,真正影响性能的是数据。这一表态与 Psi-R2.5 官方口号「Scaling Quality, Not Just Size」形成了同一逻辑的两面:本代模型的技术叙事重心,已经完全落在数据侧。
五、数据 Scaling 方法论:从「时长规模」到「信息量密度」
如果说强 Pair Data 解决了人类数据「能不能用」的问题,那么 Psi-R2.5 发布中的另一层叙事,则在回答「怎么衡量数据价值」。
官方给出的思想实验颇具代表性:10000 小时数据覆盖 100 个任务、每个任务 100 小时,与 100 小时数据覆盖同样的 100 个任务、每个任务 1 小时——两者时长相差 100 倍,但所承载的任务信息量可能差别不大。由此,Psi-R2.5 的数据方法论转向:大幅压缩单任务的重复样本,把 Scaling 的重点从单纯增加时长,转向提高同等数据规模中的信息量。配套地,灵初自研全自动标注管线(Autolabeling),将数据标注到原子动作、子任务的细粒度,再经人工审核,为「信息量密度」提供工程抓手。
评测体系与这一数据观相互锁定:仿真评测被嵌入预训练全流程;灵初自研了 50 项高难度复杂任务的真机多任务评测集;测评全程随机重置任务初始状态,以规避模型对固定初始条件的过拟合、衡量真实的组合泛化能力。
这一转向与行业共识呼应。人类数据有望承担 Scaling 角色,而真机数据则更应在精细微调中发挥作用;WAIC 2026 现场的观察也显示,行业展会的机器人任务仍以单点任务为主,通用操作能力尚有限——任务侧的「广度」瓶颈,恰恰指向数据侧的信息量密度。
六、产业影响与展望:数据管线能力,正在成为具身智能公司的分水岭
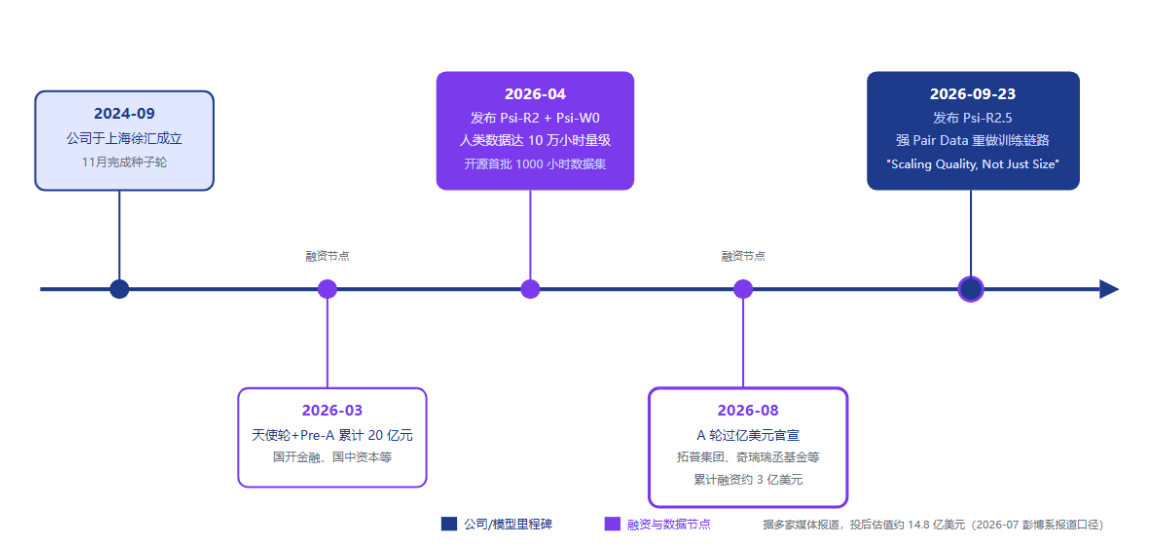
灵初自身的位置。 从时间线看,灵初智能 2024 年 9 月成立于上海徐汇;2026 年 3 月完成天使轮与 Pre-A 轮累计 20 亿元融资;2026 年 4 月发布 Psi-R2 与 Psi-W0 并开源首批 1000 小时人类手部操作数据集,人类数据储备达 10 万小时量级;2026 年 8 月 27 日官宣 A 轮过亿美元融资,累计融资约 3 亿美元;9 月 23 日发布 Psi-R2.5。据多家媒体报道,其投后估值约 14.8 亿美元(超 101 亿元人民币)。公司管理层曾透露,年内目标是冲击百万小时人类数据采集。本轮融资投向两个方向:坚持人类数据路线、深化具身世界模型研发,以及加速物流与先进制造场景的商业落地、推进数据采集基地布局。
商业化方面,灵初已在真实物流客户仓库完成小规模场景验证,落地提袋、穿环、衣服供包、分拣等能力;据公司创始人 2026 年 3 月访谈口径,物流供包节拍达 800 UPH,处于国内最高水平,目前正进入客户现场陪产。
行业的分水岭。 Psi-R2.5 的发布把一个问题摆到了全行业面前:当数据成为具身智能的核心瓶颈,竞争的核心资产就从模型参数、机器人本体,转向了「数据管线能力」——能否低成本获取数据、能否判断数据价值、能否让数据顺畅进入训练。行业观察指出,2026 年具身智能的竞争焦点已从硬件本体转向数据,数据生产各环节的分工正在细化;具身数据公司已分化出真机遥操、便携采集、仿真合成、视频蒸馏四种范式,灵初智能归入「便携采集」范式。据行业统计,2026 年以来机器人赛道总融资超 345 亿元,其中数据采集领域投入超百亿元。同期,光轮智能估值超 10 亿美元(约合 150 亿元),成为具身数据赛道的独角兽企业。
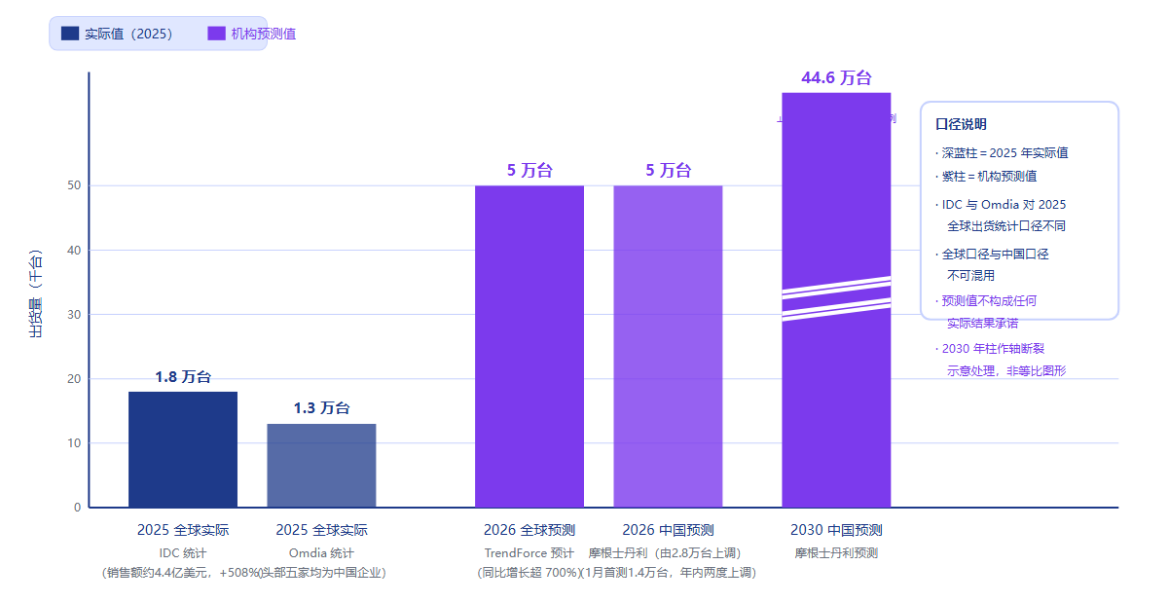
出货量的放大效应。 数据管线的价值,将在需求放量中被检验。IDC 统计显示,2025 年全球人形机器人出货约 1.8 万台、销售额约 4.4 亿美元、同比增长 508%;Omdia《通用具身机器人市场雷达报告》统计 2025 年全球出货 1.3 万台,出货量头部品牌全部为中国企业。TrendForce 预计 2026 年全球出货将突破 5 万台、同比增长超 700%;摩根士丹利将 2026 年中国出货预测由 2.8 万台上调至 5 万台(1 月首测 1.4 万台,年内两度上调),并预计 2030 年中国出货达 44.6 万台。出货量的每一级跳,都会同步放大对训练数据的需求——而行业估算,国内真实物理交互合规数据存量约 50 万小时,与商业化落地所需的数千万小时量级相比,缺口超 99%。
政策侧的合流。 2026 年 6 月,国家数据局印发《关于推进行业高质量数据集建设行动的实施方案》,提出到 2028 年底建成一批行业高质量数据集;2026 年 7 月 24 日,工信部批准《人工智能 关键基础技术 具身智能数据集质量要求及评价方法》,定于 2026 年 11 月 1 日实施,由中国信通院联合 40 余家单位起草;2026 年 8 月 27 日,市场监管总局发布 GB/Z 218.1-2026《人工智能 具身智能数据质量规范 第 1 部分:真实数据》。2026 年 9 月 10 日,国家数据局局长刘烈宏主持召开具身智能座谈会,提出「适时推动具身智能数据标准建设」「积极支持企业加大数据投入」。数据基础设施的竞争,正在从企业自发走向国家统筹。
回到 Psi-R2.5 本身:数据成本是具身智能规模化绕不开的门槛,而人类数据的规模优势,只有转化为机器人能执行、能训练、能泛化的操作数据,才有意义。当「Scaling Quality, Not Just Size」从口号变成一条可验证的数据管线,具身智能的下半场——数据基础设施的竞争——正式鸣枪。