10月13日,华为在上海练秋湖园区举办麒麟媒体技术沟通会。这是时隔六年后,华为首次围绕麒麟芯片举办线下媒体技术沟通会。
在两个多小时的时间里,就外界关注的韬定律、逻辑折叠以及最新一代麒麟系列芯片完整架构等内容,华为半导体业务无线终端芯片产品管理部部长徐松余进行了系统性的解读和分享。
麒麟回归出货已破亿!感谢产业链和消费者托举
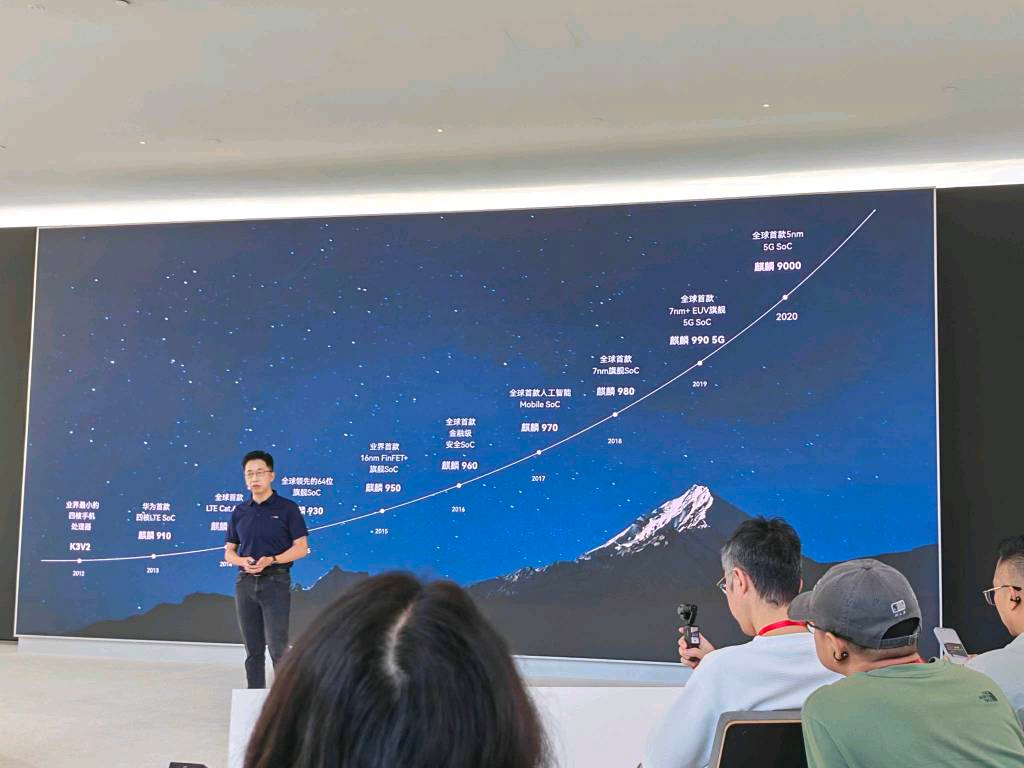
徐松余首先回顾了麒麟芯片坎坷的发展历程:2020 年之前,麒麟从褴褛起步,通过迭代十代旗舰芯片,依托全球化产业生态,成长为全球领先的手机旗舰芯片品牌。彼时行业拥有完备先进的产业环境,迭代虽有挑战,但属于良性的全球化发展阶段。但2020年后受外部环境影响,麒麟失去全部先进产业要素,被迫走向一条“从零构建”的坎坷发展之路。
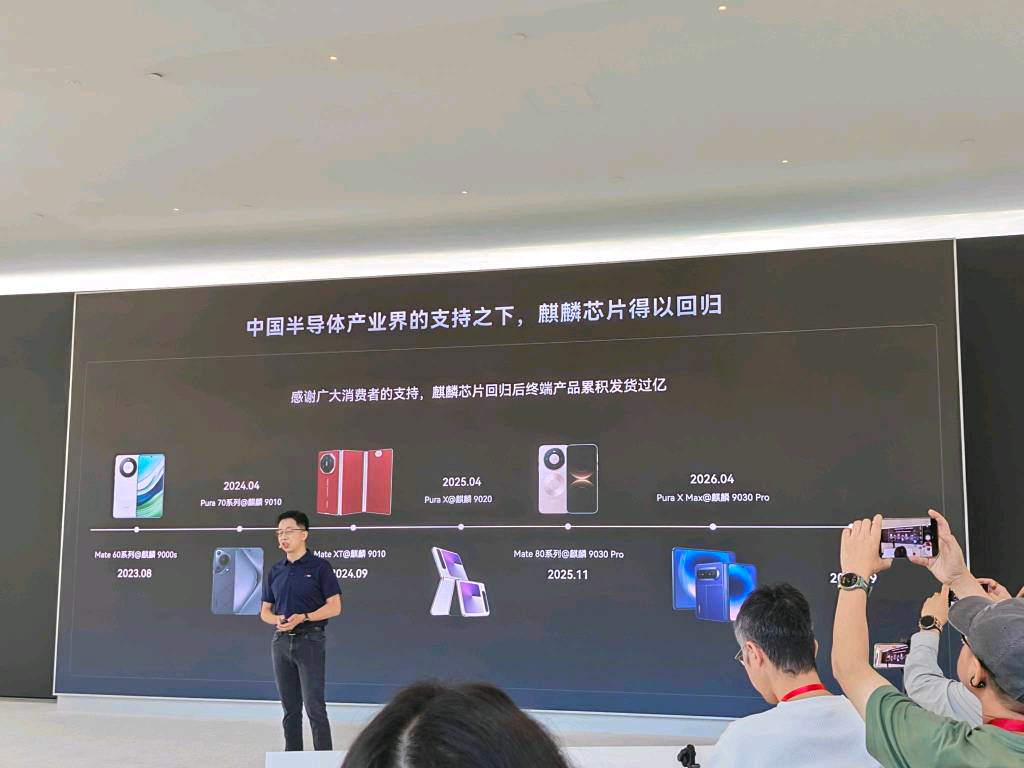
2023年,麒麟正式回归消费市场。自那时以来,搭载麒麟芯片的华为终端累计出货过亿。徐松余特别强调和感谢了再此过程中国内产业链和广大消费者对于华为的托举和支持。
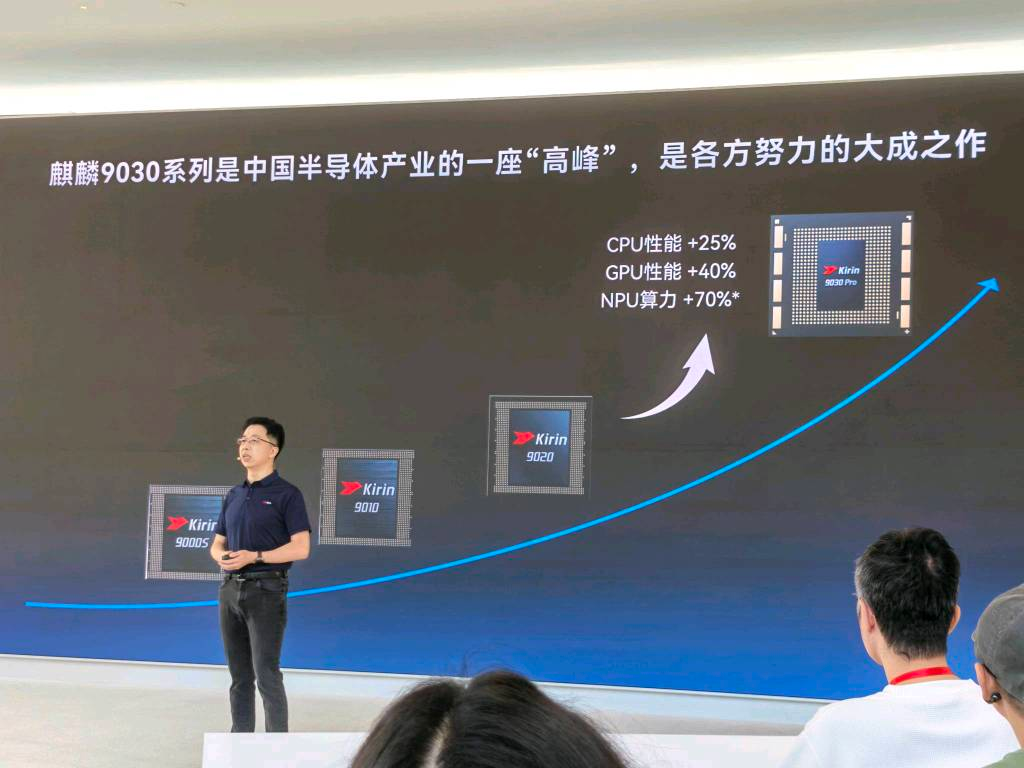
自麒麟回归以来,相继推出麒麟9000S、9010、9020、9030、9050系列产品,麒麟9010、9020 实现架构大幅升级、工艺小幅迭代;麒麟9030 Pro实现架构、工艺双重提升,CPU 性能+25%、GPU提升40%、NPU算力提升70%,是国内产业链协同的大成之作。
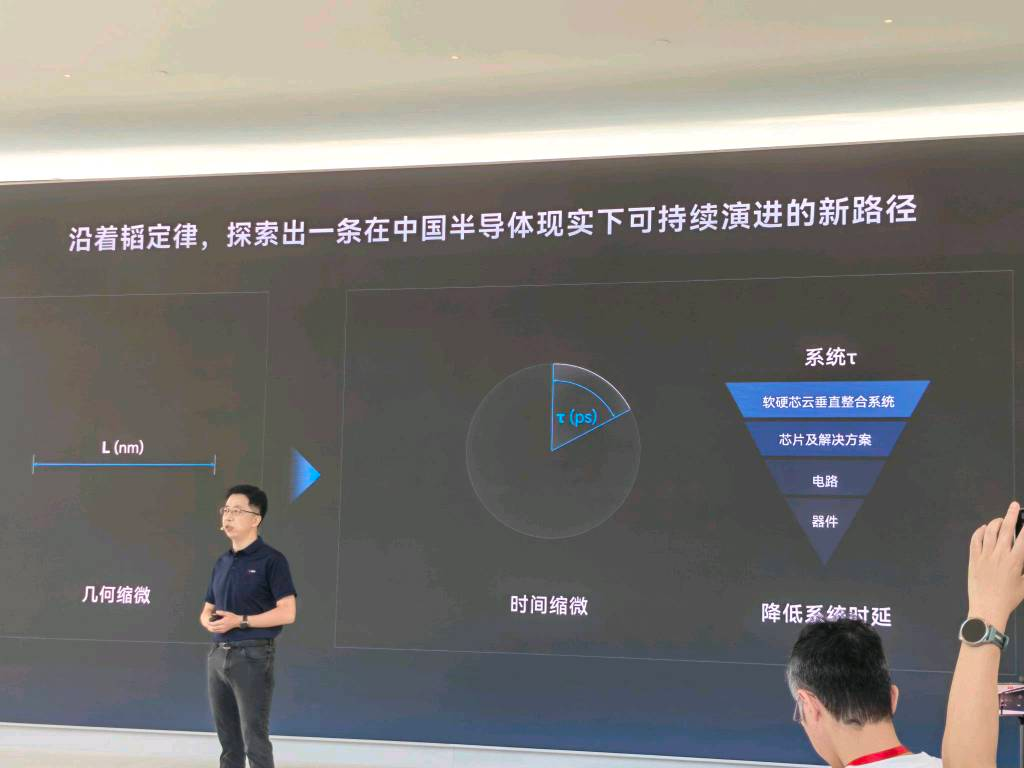
而最新一代旗舰芯片——麒麟9050 Pro,则是华为四年前启动逻辑折叠技术探索并落地的首个产品。由此也验证了华为提出的时间微缩理念、逻辑折叠是一套可行、可持续演进的技术路线。
逻辑折叠量产落地,开启麒麟新十年征程
逻辑折叠并非简单把几颗芯片叠在一起,而是在芯片设计之初就以三维视角进行系统设计,将逻辑电路分布在更适合的位置,把多颗DIE作为一个完整芯片进行协同设计,从而缩短信号走线、提升晶体管密度,并获得性能与功耗收益。
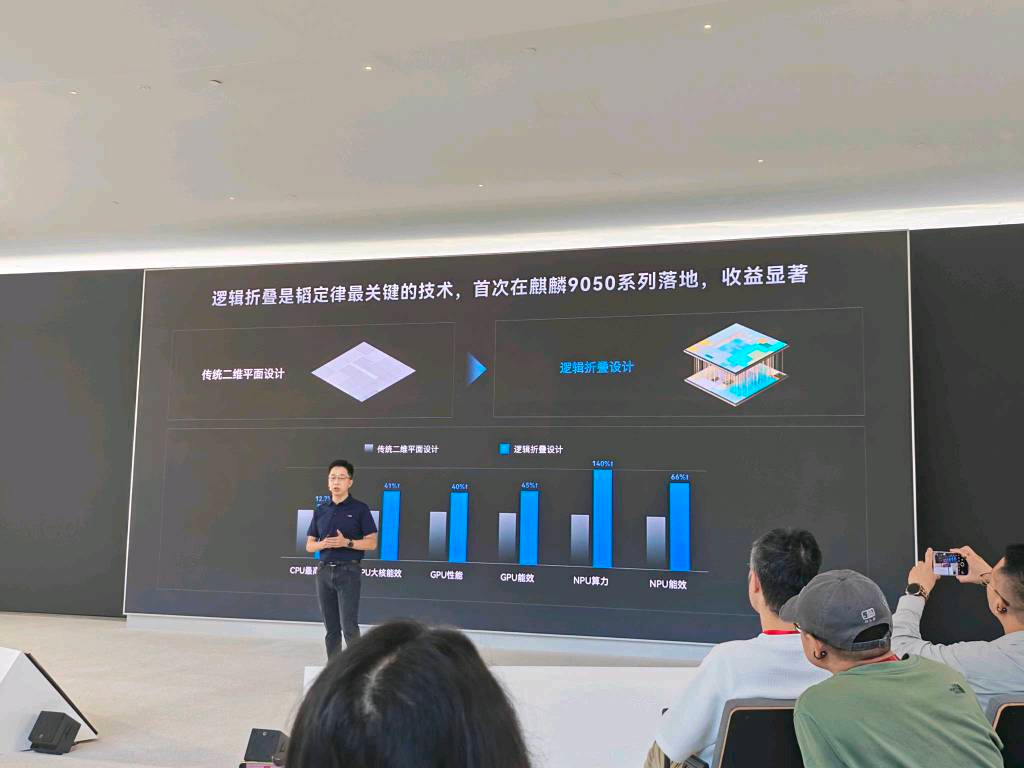
麒麟9050系列拥有超过5000万混合键合,有效信号互连超过500万,晶体管密度提升53.5%。由此带来显著性能和能效的提升。其中,麒麟9050 Pro的CPU主频提升12.7%,CPU大核能效提升41%,GPU性能提升40%,GPU能效提升45%,NPU算力提升140%;NPU能效提升66%。
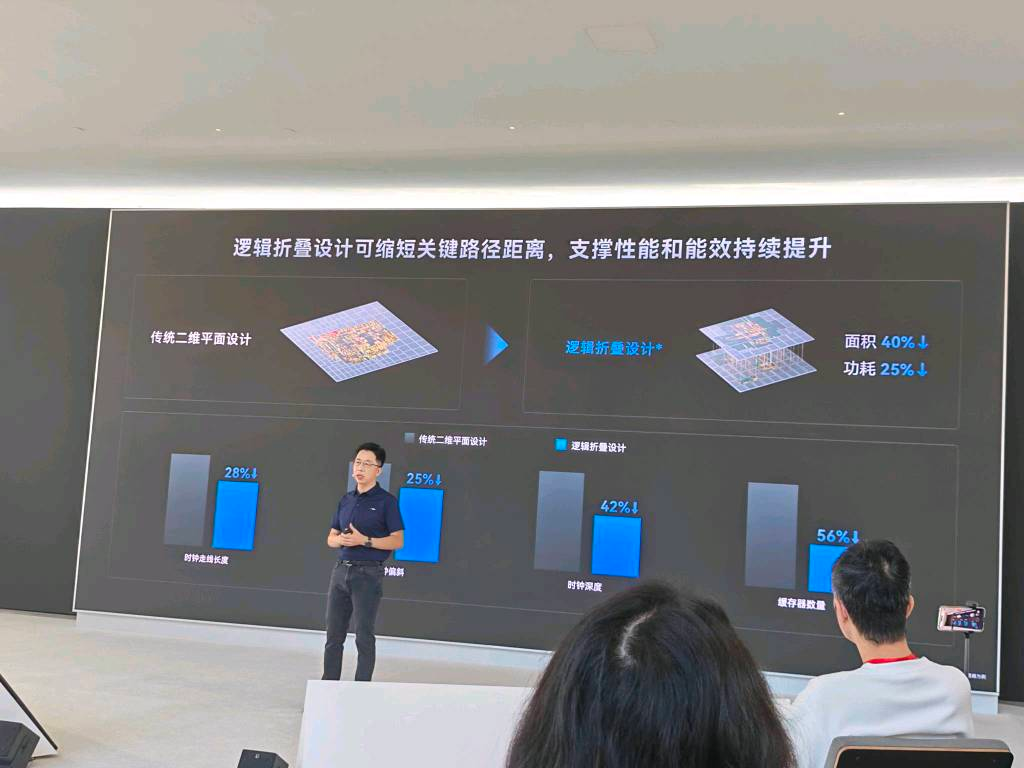
逻辑折叠可以显著缩短关键路径距离,以9050 Pro内部通信处理器模块为例:投影面积降低40%;芯片时钟走线长度缩短 28%。 上下层晶圆处于同一个时钟域;时钟走线缩短,时钟倾斜、时钟深度得到改善,可以减少缓存器数量,进一步降低功耗。
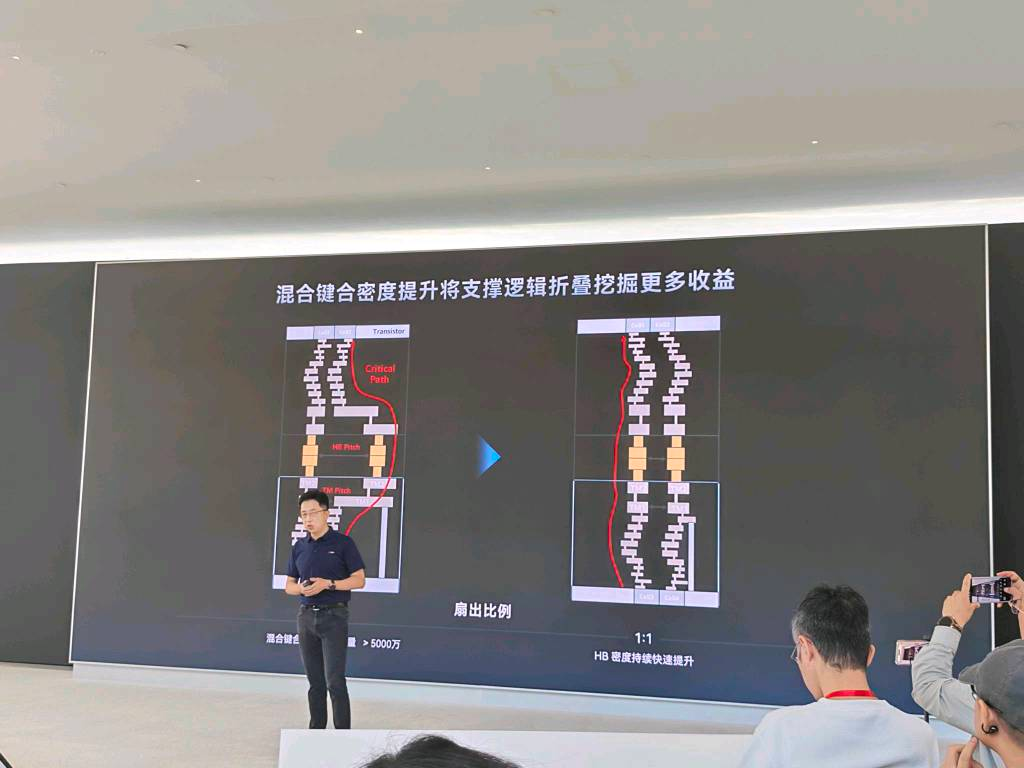
对于逻辑折叠需要依靠的重要技术——混合键合,华为方面表示,要实现有效的折叠,混合键合的间距同顶层金属的间距比必须小于3.麒麟9050 Pro的间距是720nm,也就是键合间距必须小于2um,目前华为已经将其实现到1.5um,2027年将做到1um并在未来持续演进。当间距比达到1:1后,在关键路径上就会缩短距离,提升能效。其次间距缩小后,可以增加更多高速通道数并带来更多的互联,以及实现更多的逻辑折叠。
徐松余表示,今年逻辑折叠芯片实现量产是一个非常关键的起点。未来华为将从多方面努力,包括设计工具、后端优化等。
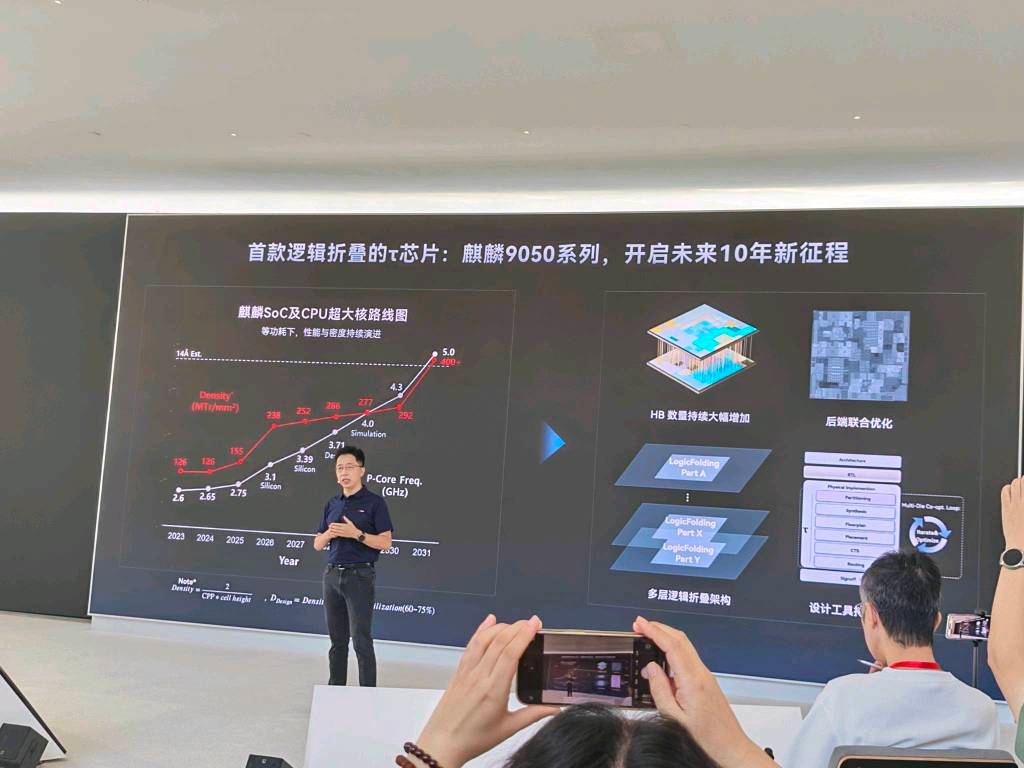
“即使我们暂时失去了在几何缩微方向上的能力,但是我们依然可以开启未来10年的新征程。”徐松余强调。
如何让端侧30B大模型“放得下”“跑得久”
在如今的AI智能体时代,AI正在重塑芯片设计的结构和理念。在今年已经推出的旗舰芯片中,厂商纷纷强调“为AI而生”,AI重塑芯片架构设计底层逻辑。
华为强调,移动智能体(Mobile Agent )时代,跟以往AI的最大差别在于,从被动执行任务到主动协助用户,感受环境,完成多任务的闭环。
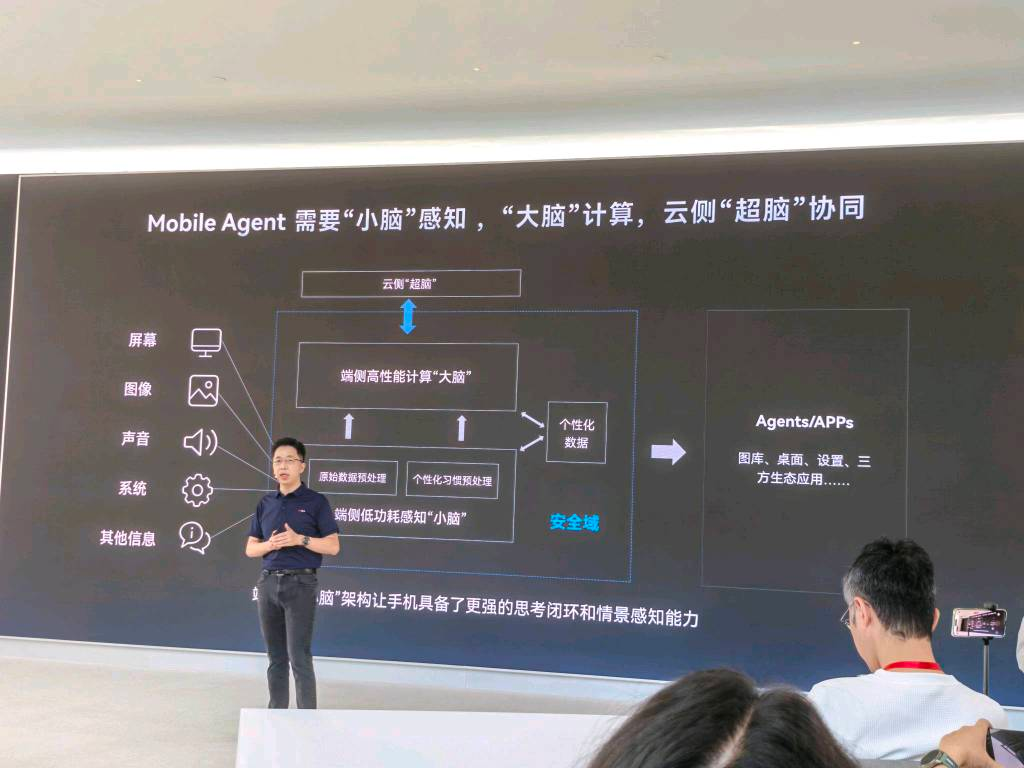
因此,华为在端侧构建了“大小脑”架构。端侧“小脑”(小模型)感知用户状态——声音、图像、通信连接等;端侧“大脑”(大模型)完成多步任务闭环;云侧“超脑”协同处理更复杂的任务。高隐私、低时延的任务留在端侧,复杂任务交给云侧超脑。而麒麟9050 Pro则为这样的架构提供了硬件基础和技术底座。
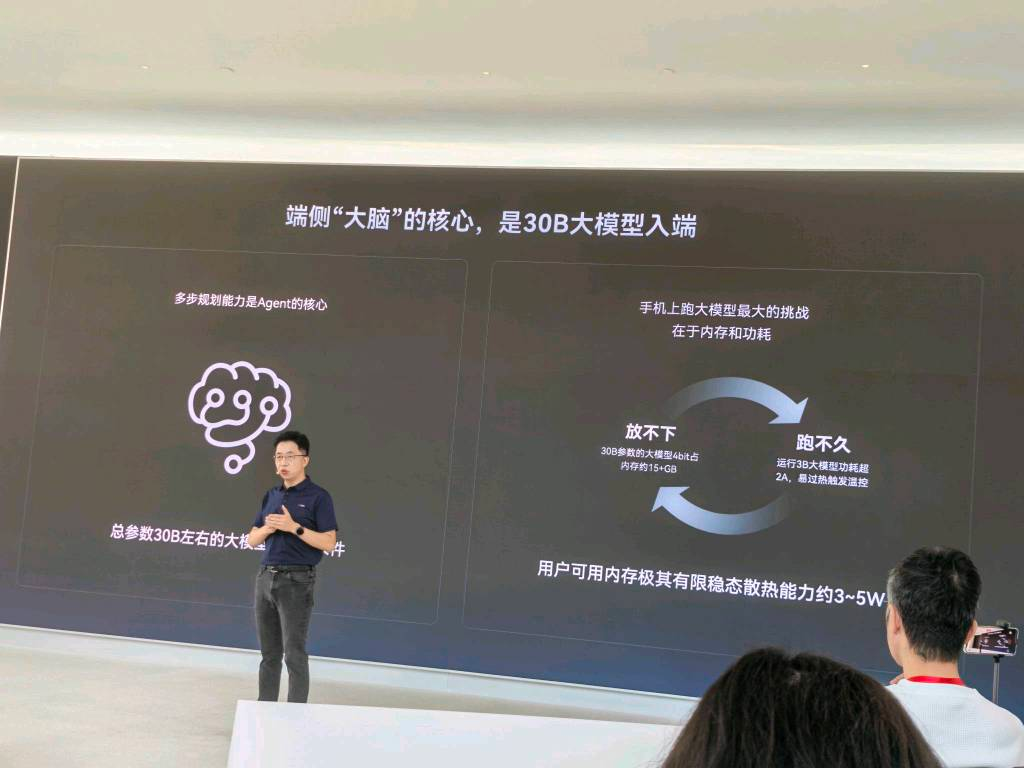
得益于逻辑折叠,采用新一代达芬奇架构的NPU,性能提升140%,功耗降低66%。此外,通过SoC中的灵犀微核,实现多模态低功耗的环境感知。华为认为,大脑最终要协助用户完成任务,核心是多步规划能力,这依赖于模型的尺寸。
经华为研究,30B大模型是一个基本条件,但在手机侧运行30B大模型,将面临两大挑战:内存和功耗,既要放得下还要跑得久。
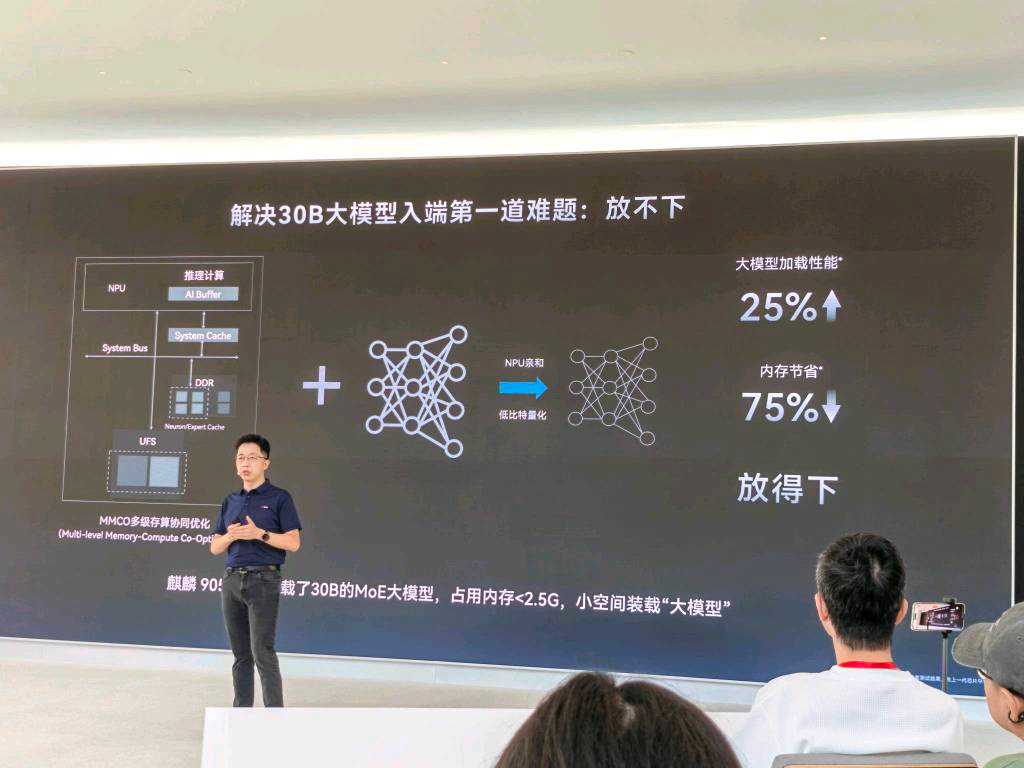
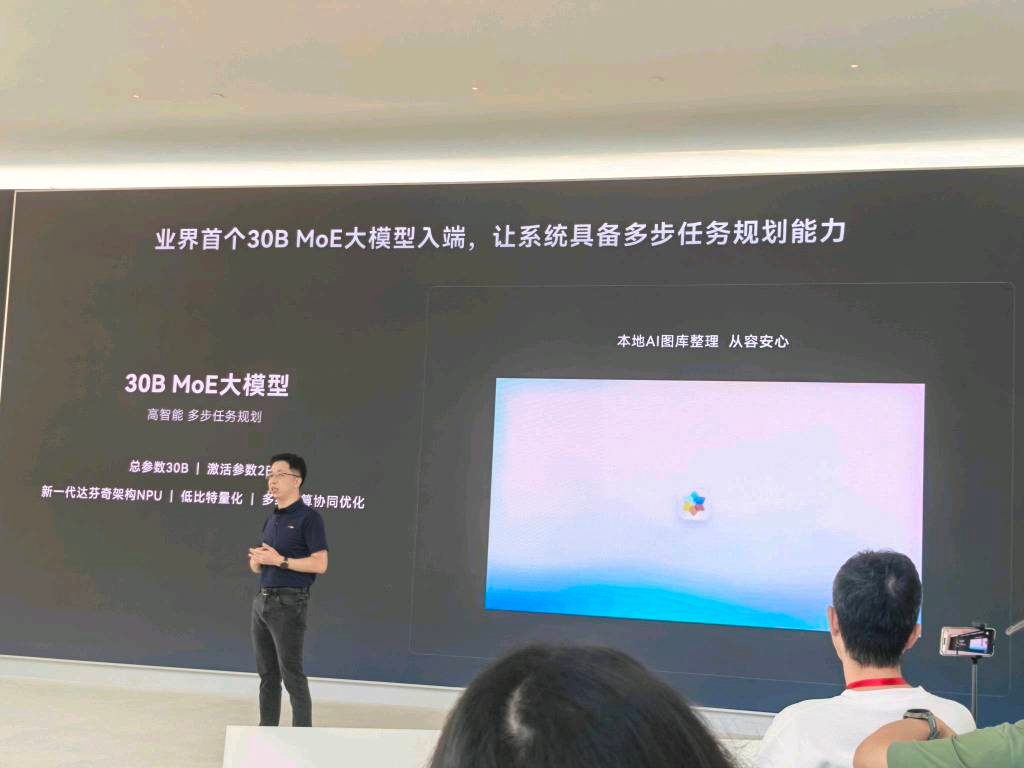
在麒麟9050系列中,通过率先支持多级存算协同的技术,设计了麒麟芯片亲和的MoE架构,大模型加载性能提升25%、内存节省75%,30B MoE大模型占用内存小于2.5GB——最终实现“小空间装载大模型”。
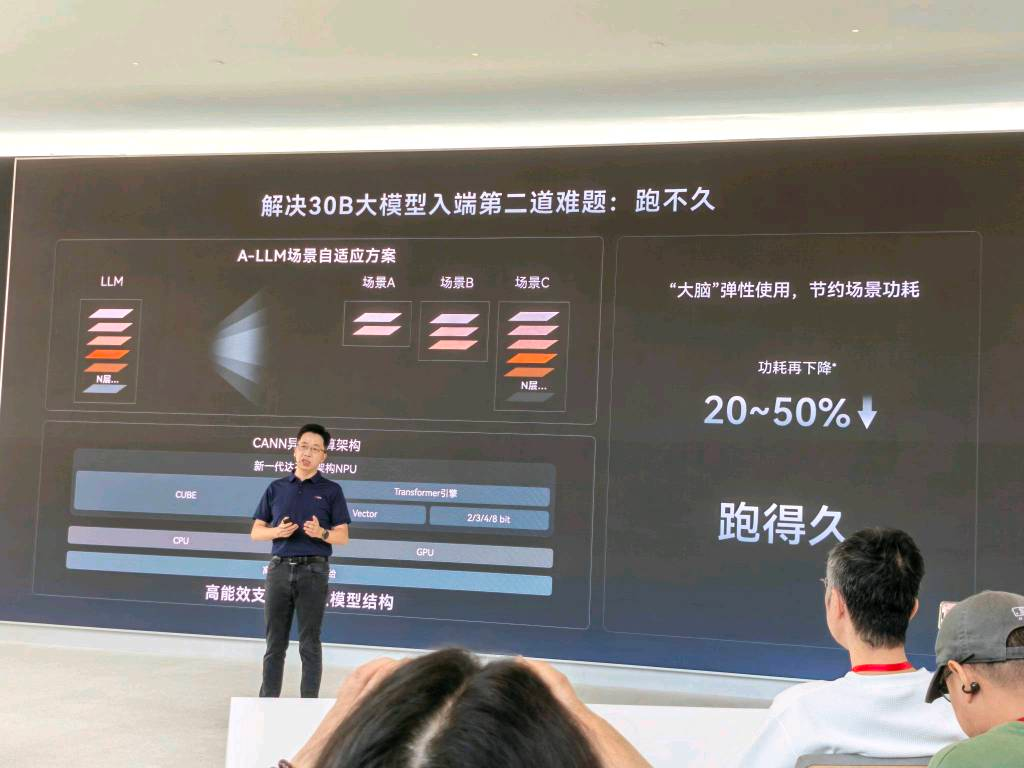
此外,通过联合应用团队,麒麟开发了大模型场景自适应的方案。模型可以根据任务的复杂程度来自动地加载不同规模的参数,从而进一步节约场景功耗20%到50%。
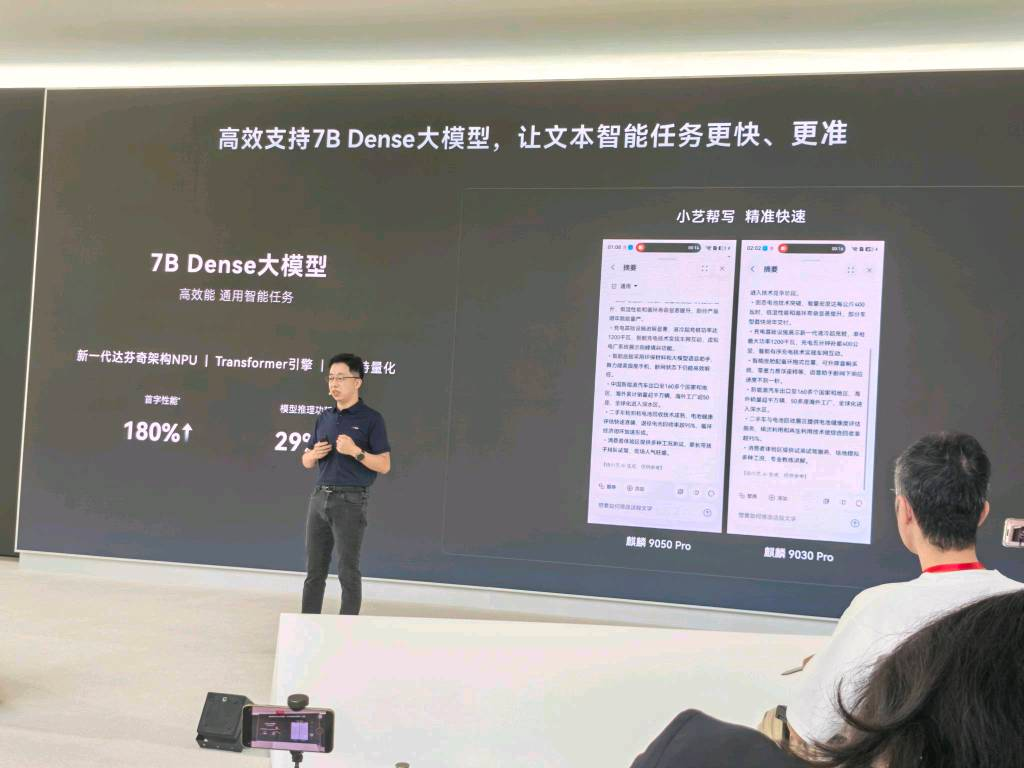 现场,华为演示了几个应用,包括基于本地Agent的图库整理功能,可以根据用户意图完成图库分类、建立相册等。主要涉及30B MoE多步任务规划能力。还有基于7B Dense大模型的小艺帮写,可以帮助用户进行文本内容改写。相比于麒麟9030 Pro,麒麟9050 Pro在运行该模型的首字性能提升180%,模型推理功耗下降29%。
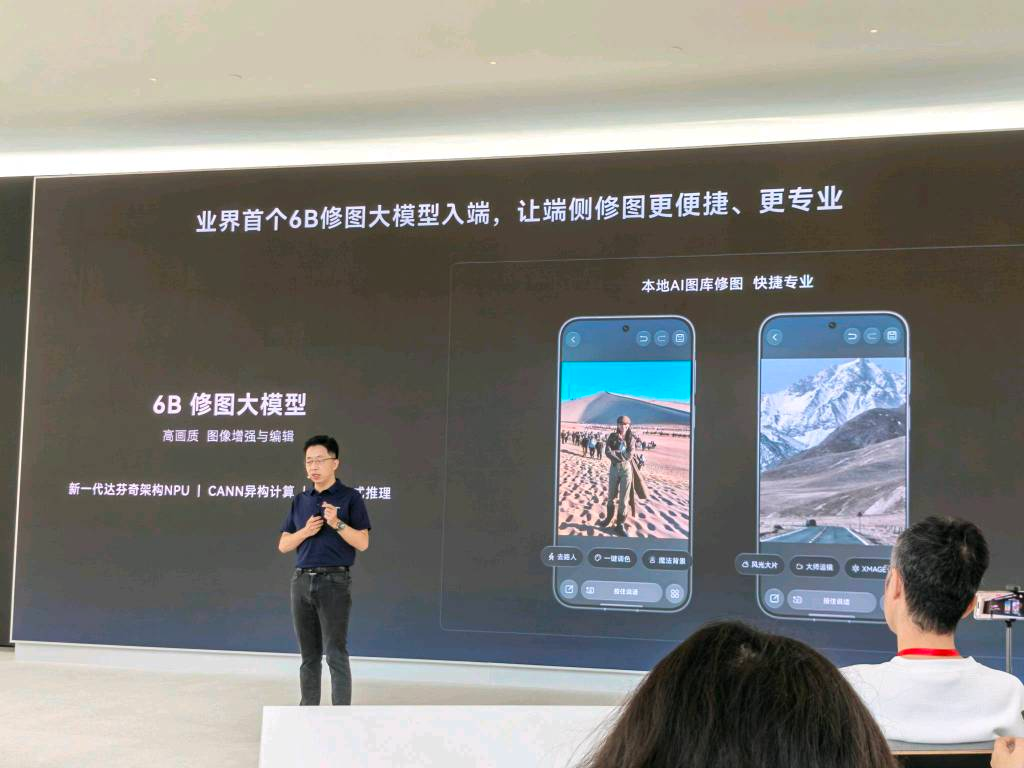
此外,华为还将业界首个6B修图大模型引入端侧,叠加30B MoE高阶图像理解能力,可以根据不同图像内容来进行智能推荐修图选项。
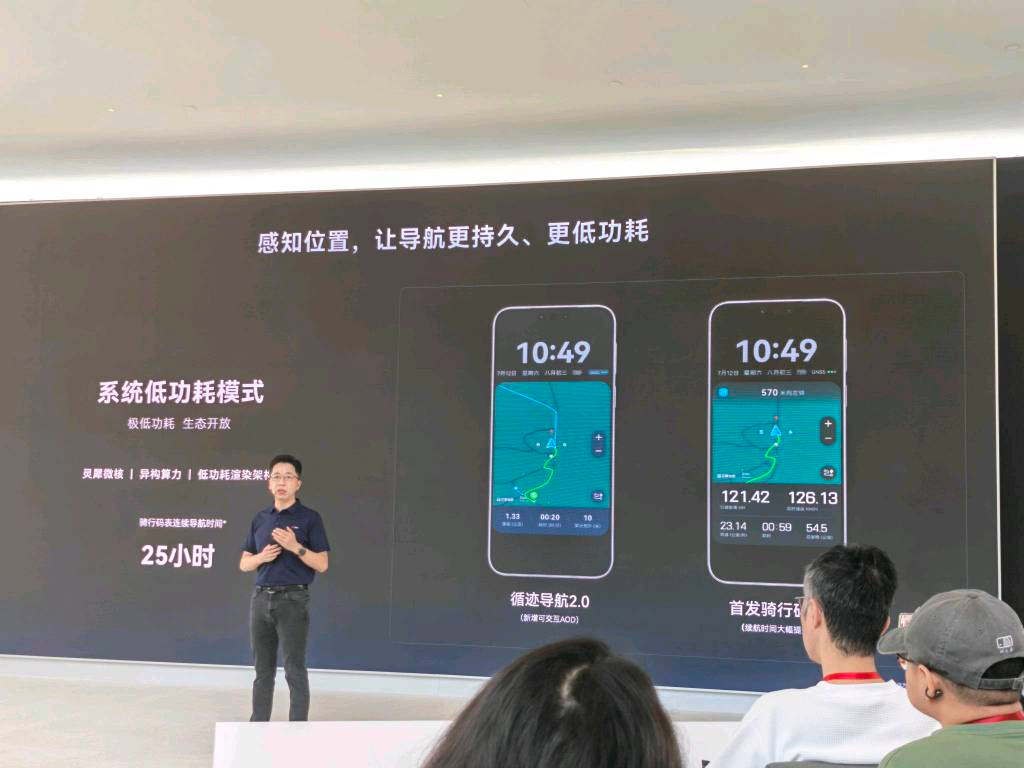
在大算力场景之外,在低功耗感知场景方面,基于灵犀微核加异构算力加低功耗渲染架构,华为打造了业界独有的低功耗息屏导航,首发骑行码表,连续导航可以超过25小时。
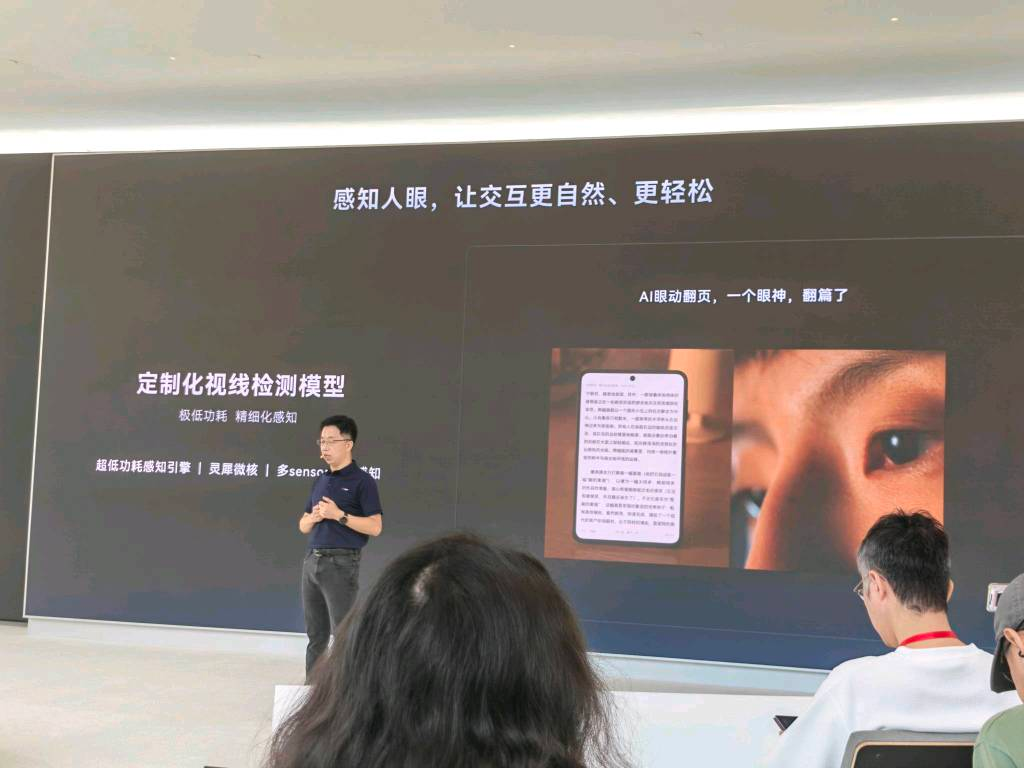
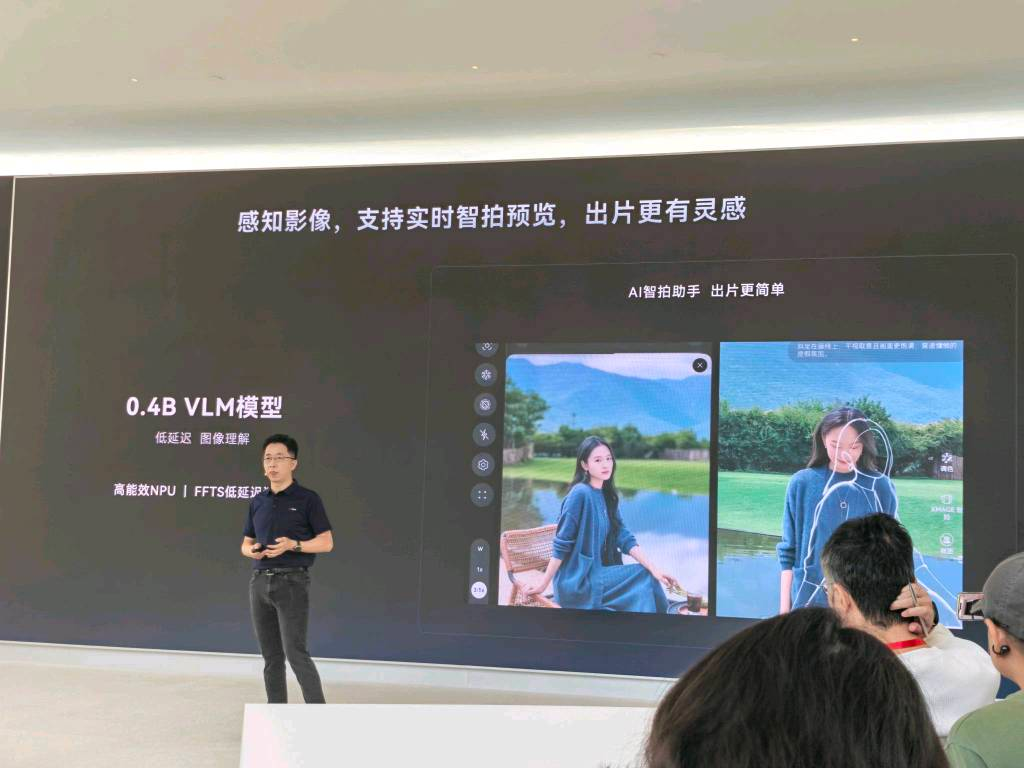
通过0.4B的VLM(视觉语言)模型,实现“感知人脸”、眼动翻页以及AI美肌自拍等功能在端侧实现。
CPU:多核性能提升23% 智能调度显神威
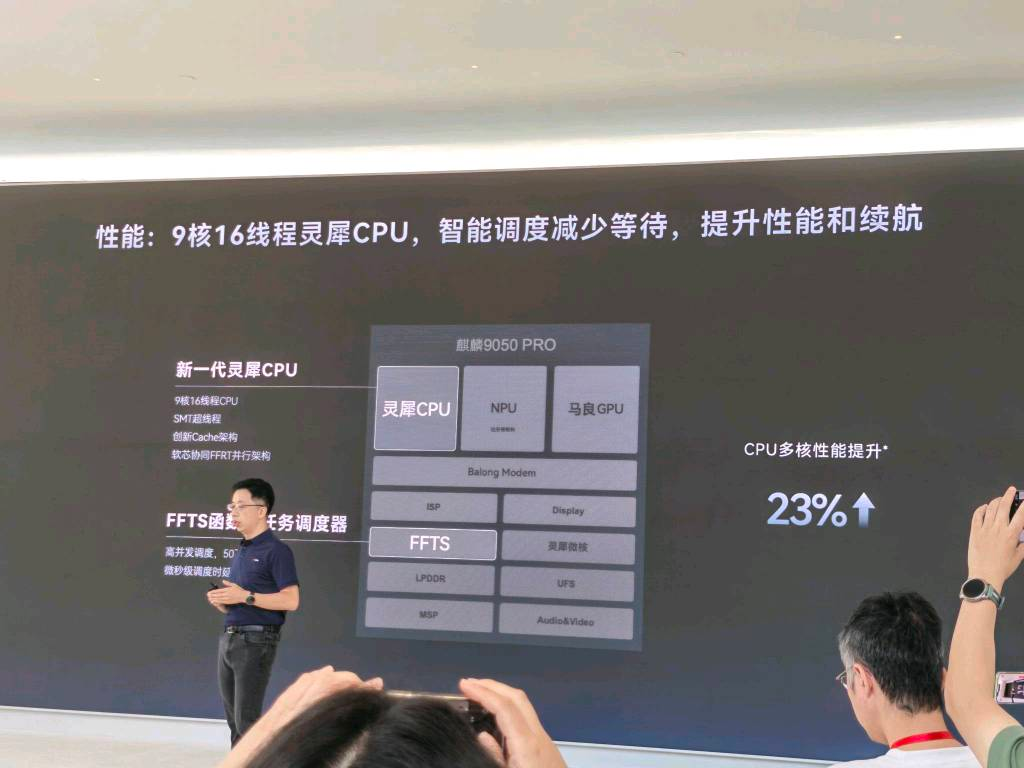
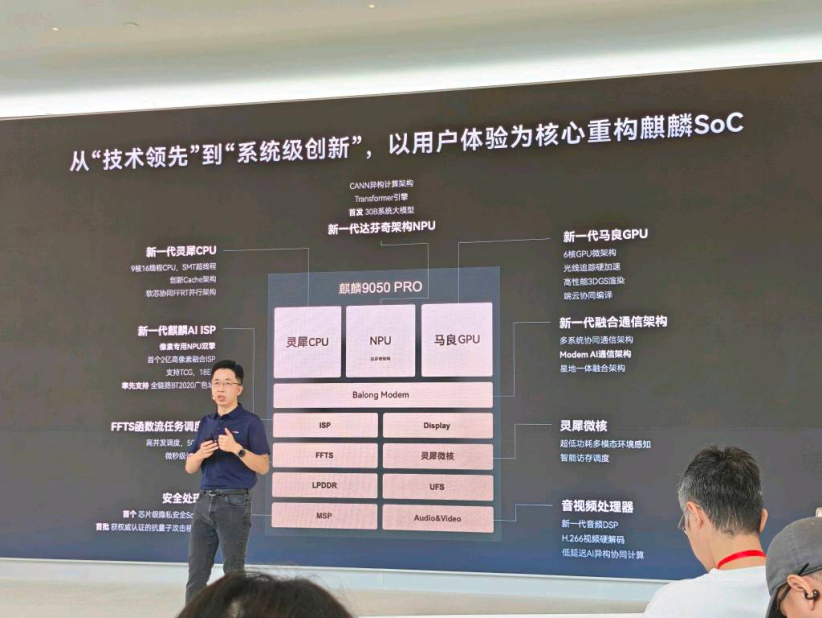
麒麟9050 Pro集成了新一代灵犀CPU,9核16线程,支持SMT超线程,创新Cache架构,CPU多核性能提升23%。其中一大亮点是支持了FFTS, 这是一个函数流的任务调度器,支持每秒50万次的高并发的调度能力,让调度达到微秒级的响应能力。
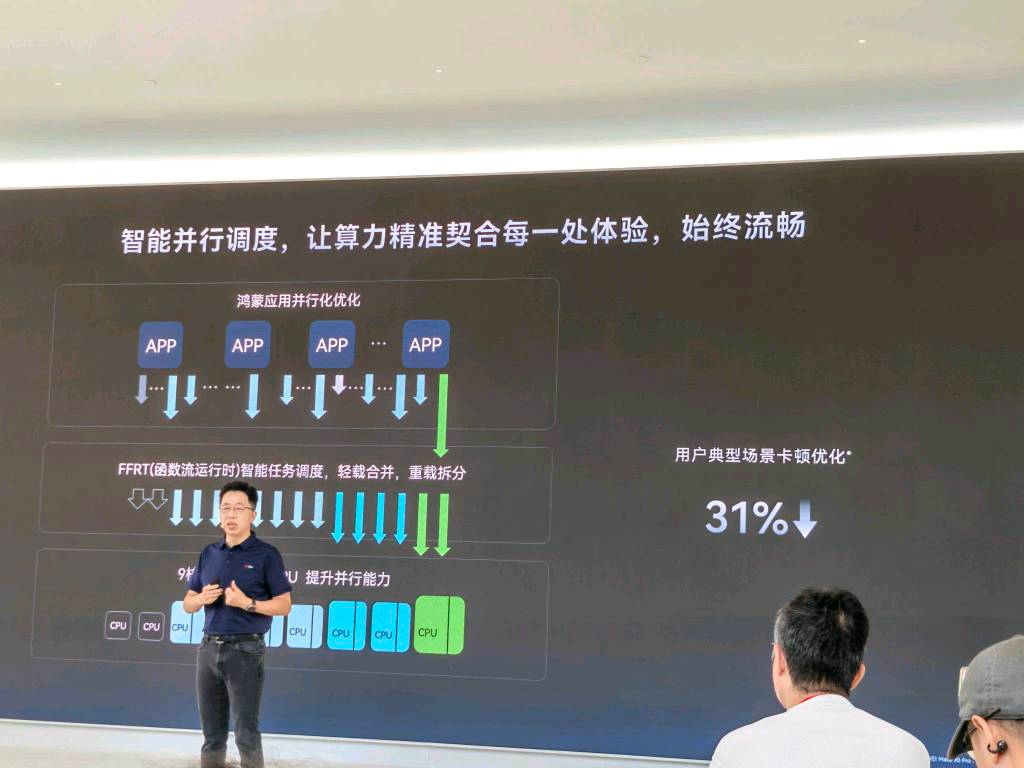
在多线程能力方面,麒麟9050 Pro支持9核16线程,提供超强并发能力,通过鸿蒙系统对应用进行并行优化,可将单线程的重载任务拆分,同时又能够将轻载任务合并,使得线程总数从5000多降低到1000多个,得益于系统级深度并行优化,Mate 90 Pro Max的整体卡顿相比上一代降低31%。
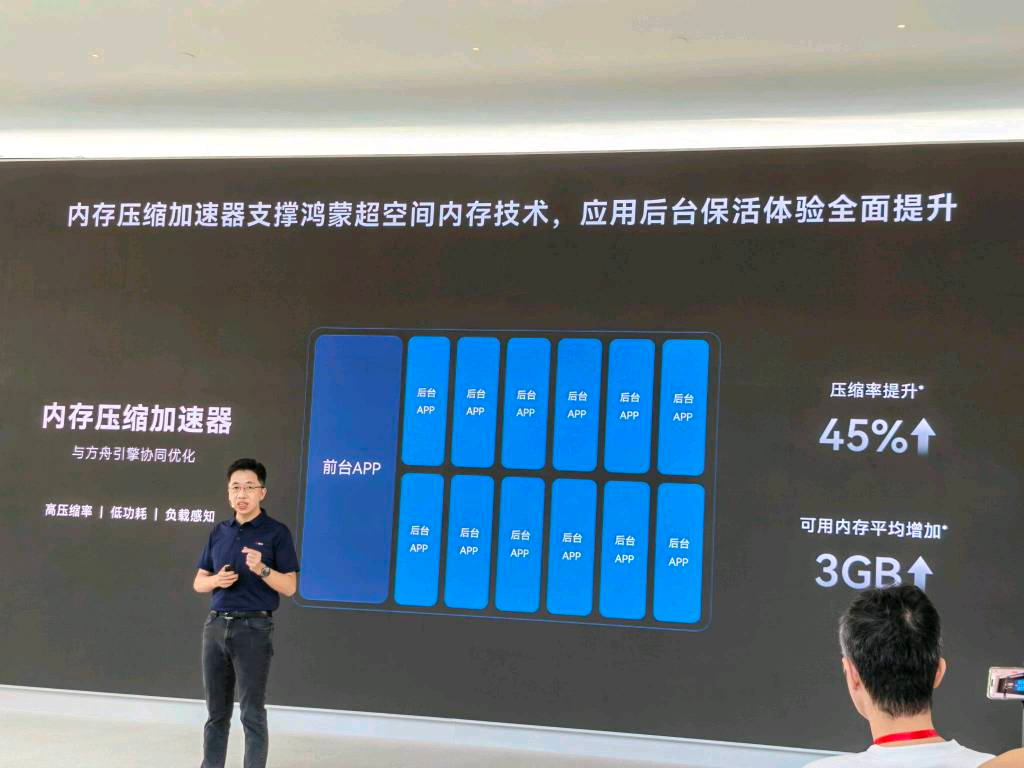
除CPU之外,基于对用户场景的理解,结合鸿蒙系统,华为在麒麟9050 Pro上设计了多种硬件加速器。比如内存压缩,通过与方舟引擎协同优化,麒麟支持了鸿蒙的超空间压缩技术,具备高压缩率、低功耗的特点,为用户提供更多有效的可用内存,让应用后台保活体验全面提升(演示数据:压缩率提升45%、可用内存平均增加3GB)。
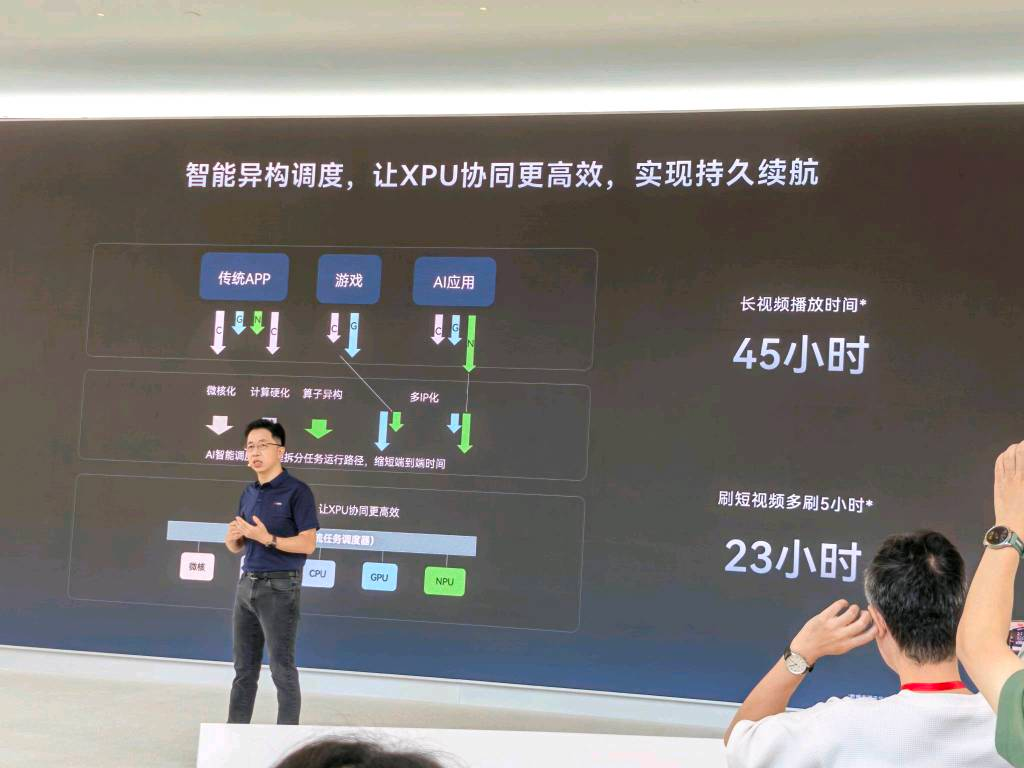
正是因为有了并行能力和硬件加速器,麒麟9050 Pro可以通过AI智能调度,把不同任务运行到最适合的硬件载体上——有的应用以CPU为主、有的以GPU为主、有的以NPU为主,甚至可以做任务类型转换。让XPU协同更高效,从而实现持久续航(长视频播放45小时,刷短视频多刷23小时)。
GPU性能暴涨40%,光追性能提升78%
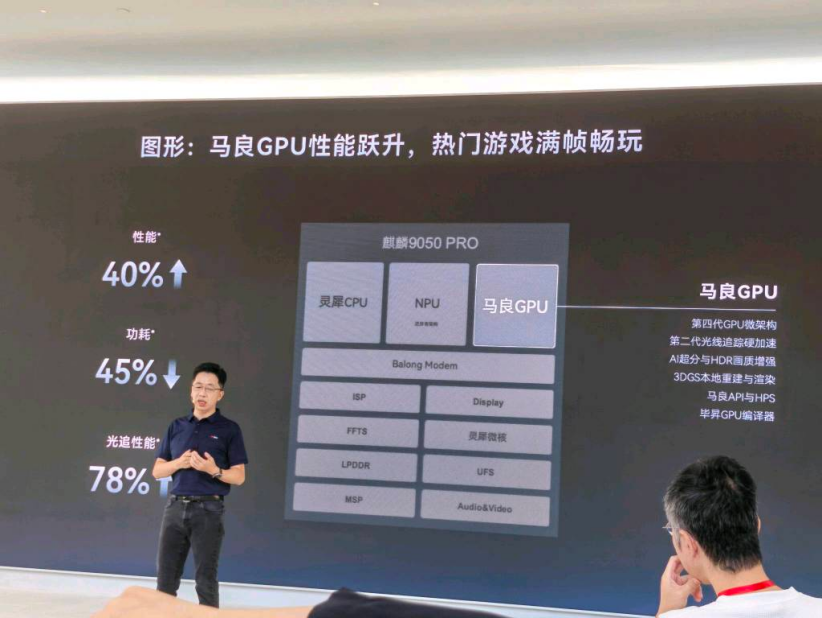
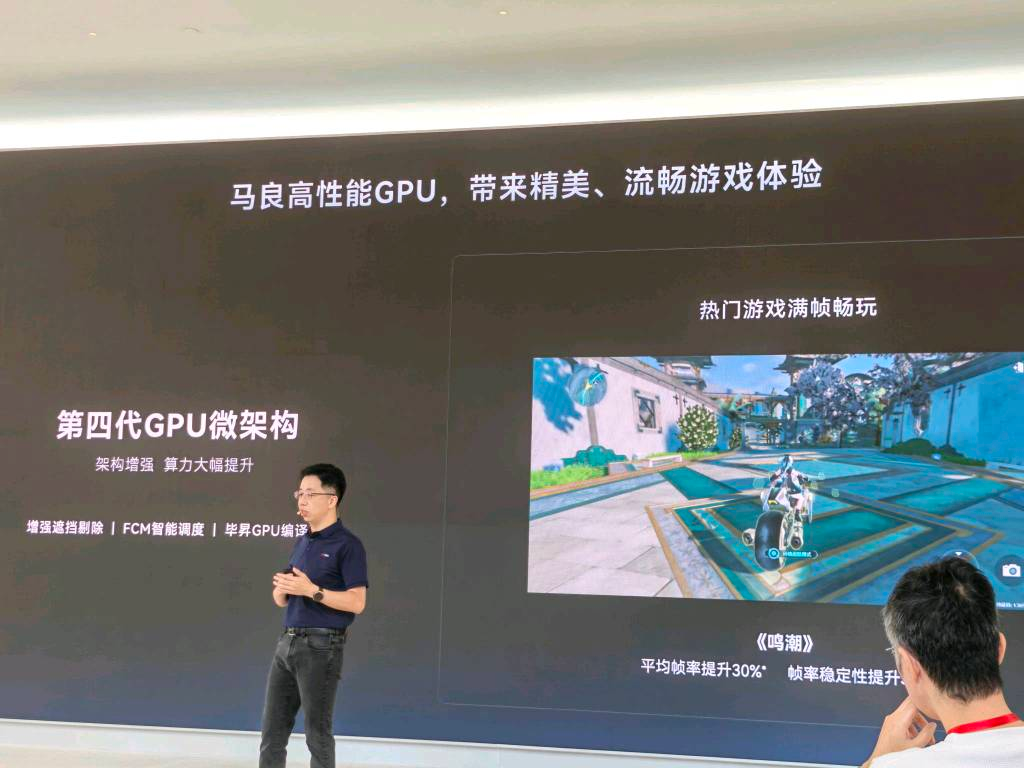
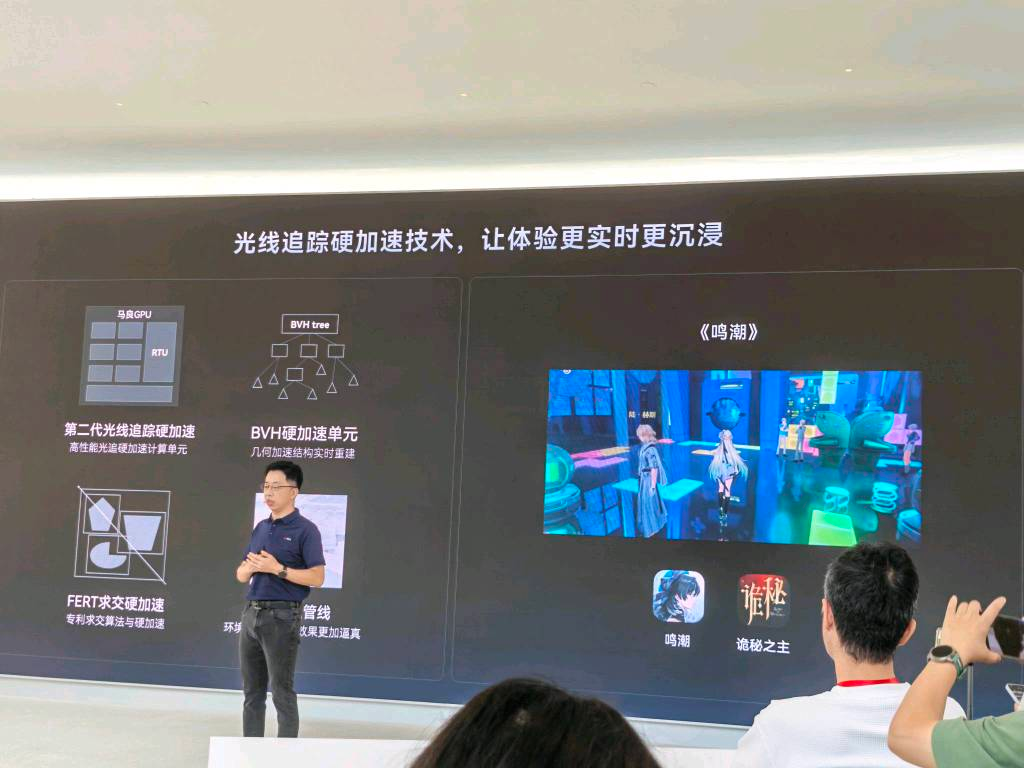
在GPU方面,新一代马良GPU在微架构、光追、画质增强上进行了一系列创新。性能提升40%,功耗降低45%,光追性能提升78%。
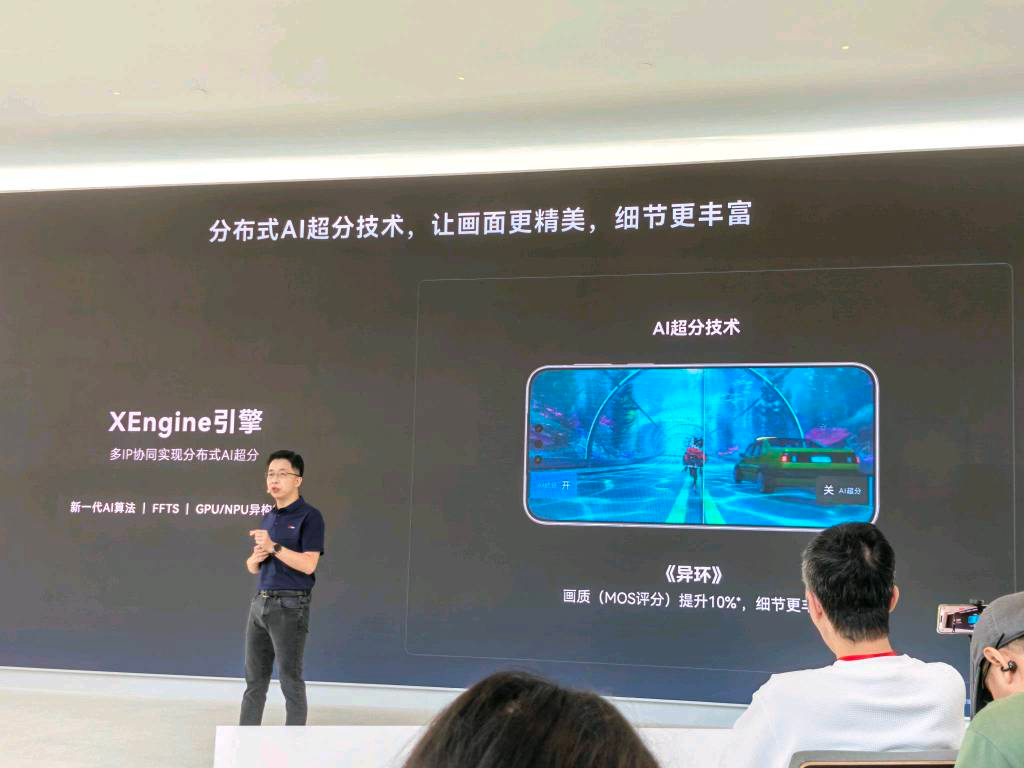
同时,XEngine智能图像增强依托GPU/NPU异构算力与FFTS调度,将AI算法融入渲染管线,实现AI超分和HDR增强,画质MOS评分提升10%。
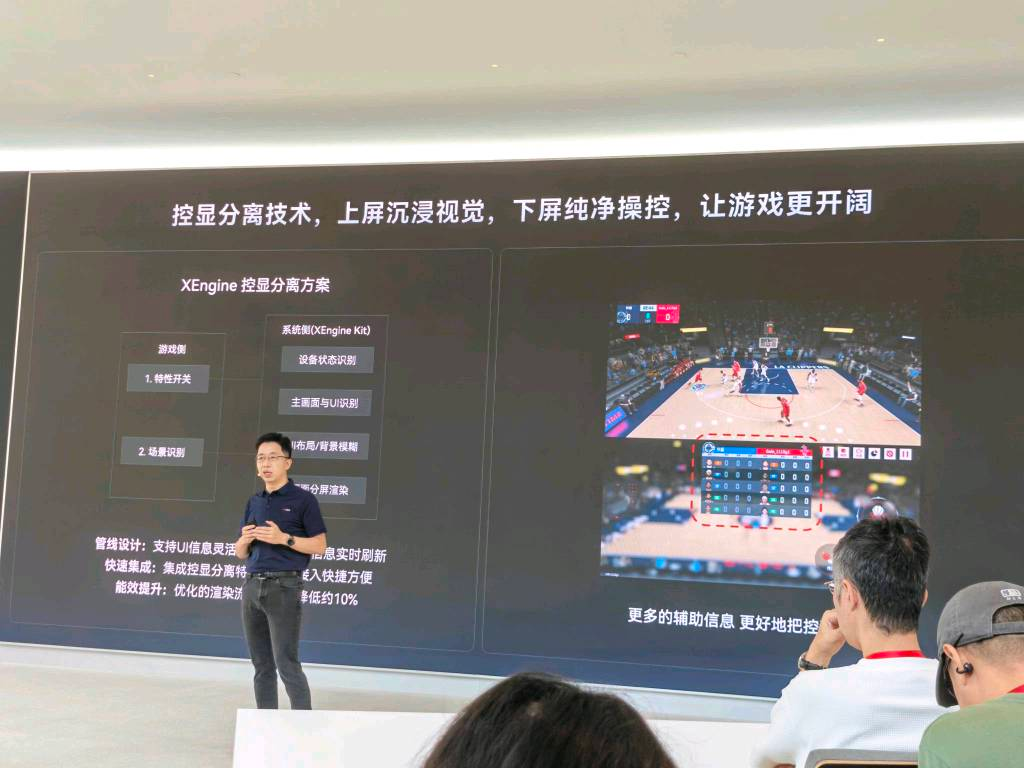
XEngine控显分离技术则实现游戏主画面与UI/操控层分层渲染,在提升沉浸感和操控体验的同时,功耗降低约10%。
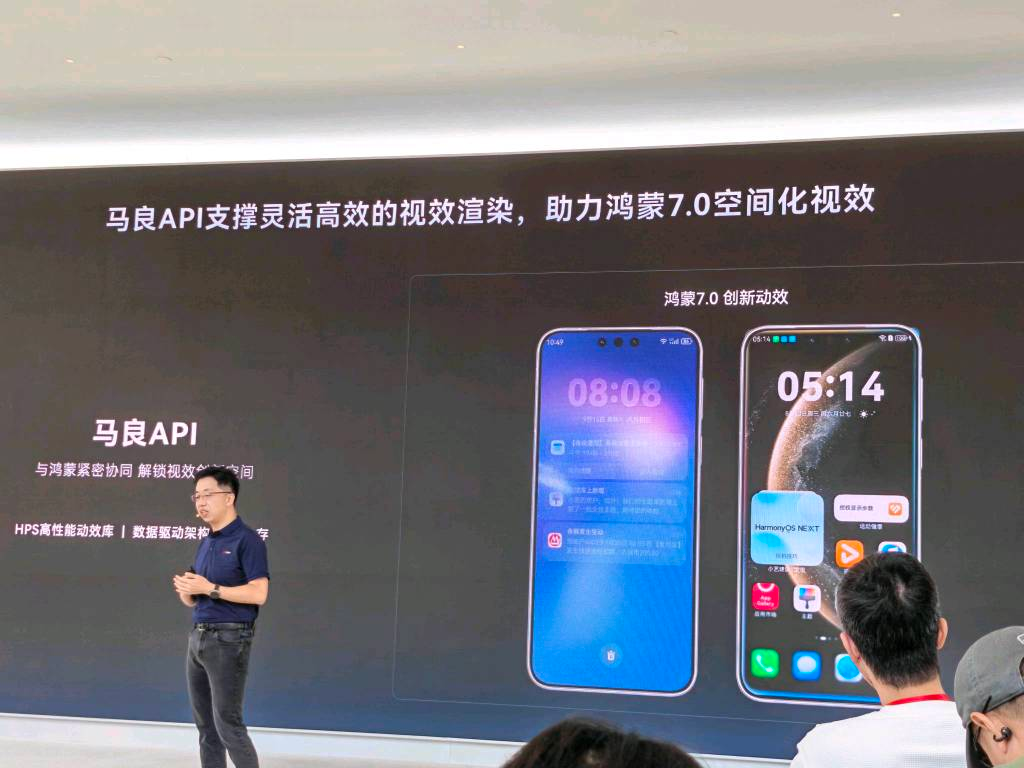
马良API是为马良GPU量身打造的图形接口,能更好地匹配硬件特征,并通过HPS高性能动效库等功能,为开发者提供更高效、灵活的底层渲染能力,也为为消费者带来了很多高性能、流畅度和炫酷的动效体验,
影像:业界首个2亿高像素融合ISP 视频画质大升级!
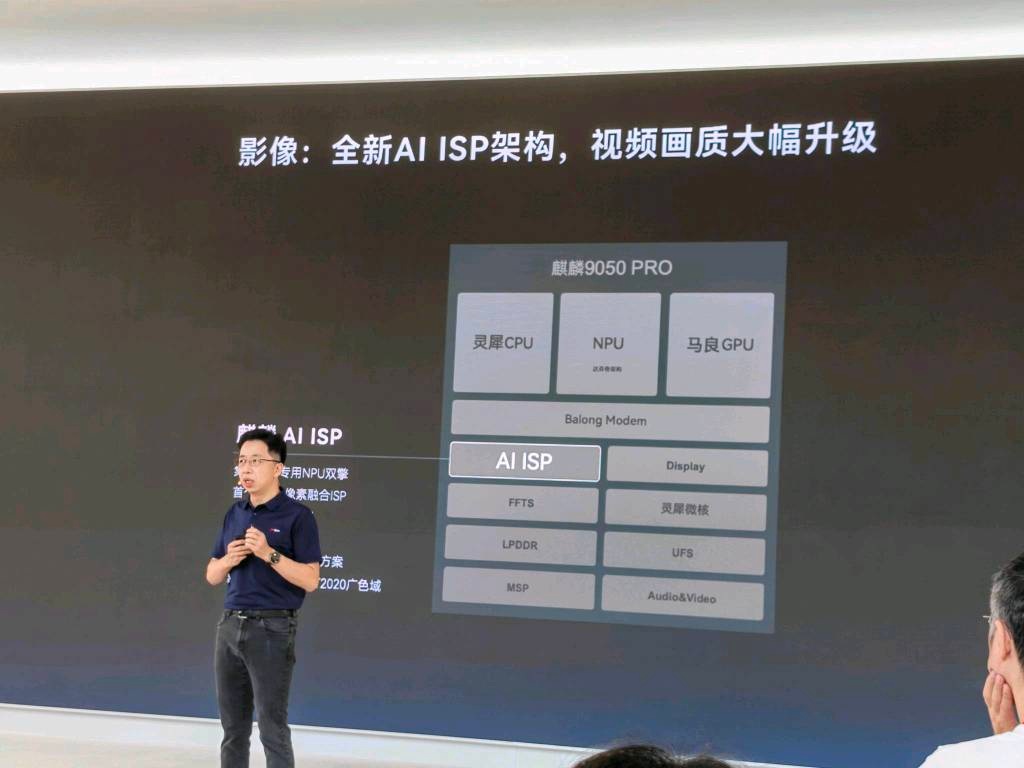
在影像方面,新一代ISP最大特点是集成了专用NPU,从而构成双NPU引擎架构。在拍照、视频、人像、颜色等等主要的场景都带来体验提升。
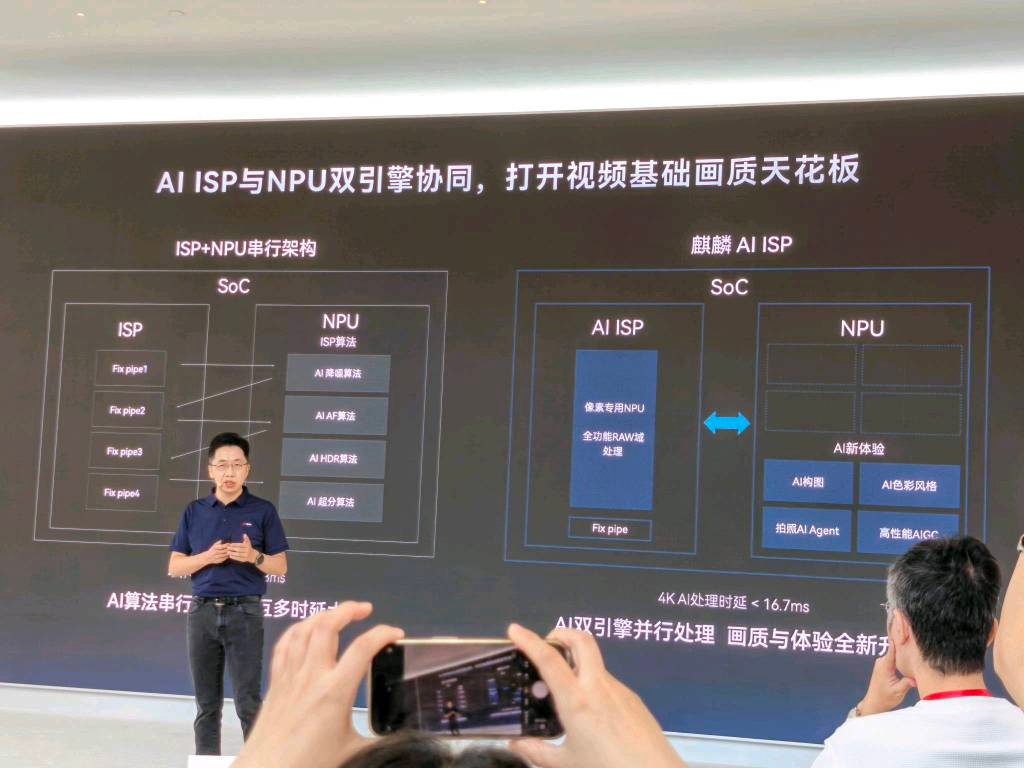
6年前,麒麟9000中率先将NPU引入视频拍摄增强处理。但相对ISP是两个独立模块,面对更高画质的处理,需要进行更多算法和交互,从而带来时延问题。
而在麒麟9050 Pro中,采用了新一代的ISP架构,AI ISP与NPU双引擎协同,带来视频画质的大幅升级。4K AI处理时延大幅降低至16.7毫秒以内,从而满足在拍摄4K 60帧时,最高画质的呈现。
从这个角度而言,麒麟9050 Pro的ISP已经不是传统意义的信号处理器,而是一个“像素级计算引擎加AI双引擎”的复合架构——拍照、视频、人像、颜色等主要场景都围绕它做体验提升,这也是“以用户体验为核心重构SoC”在影像侧的体现。
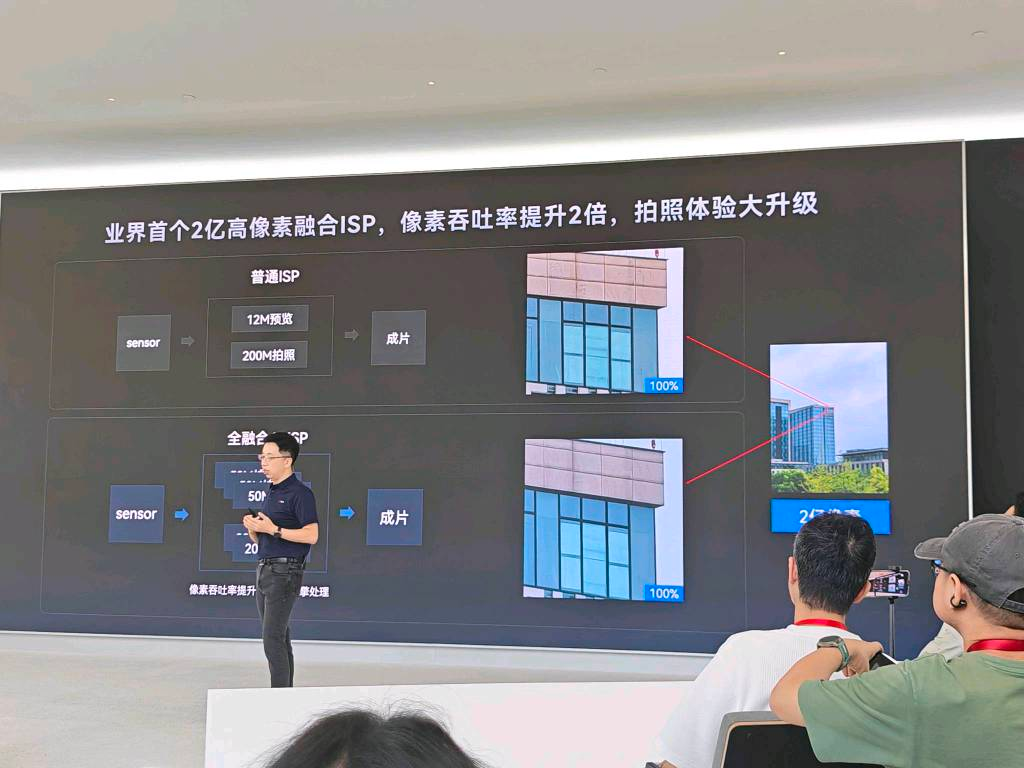
业界首个2亿像素融合ISP。过去高像素拍照更多只是一个“参数”,因为处理慢、预览卡、连拍不连贯。麒麟9050 Pro的ISP支持2亿像素拍照,像素毫秒级并行处理,在拍照的同时融合更多信息,让2亿像素拍照不再卡顿,预览与连拍体验大幅提升。
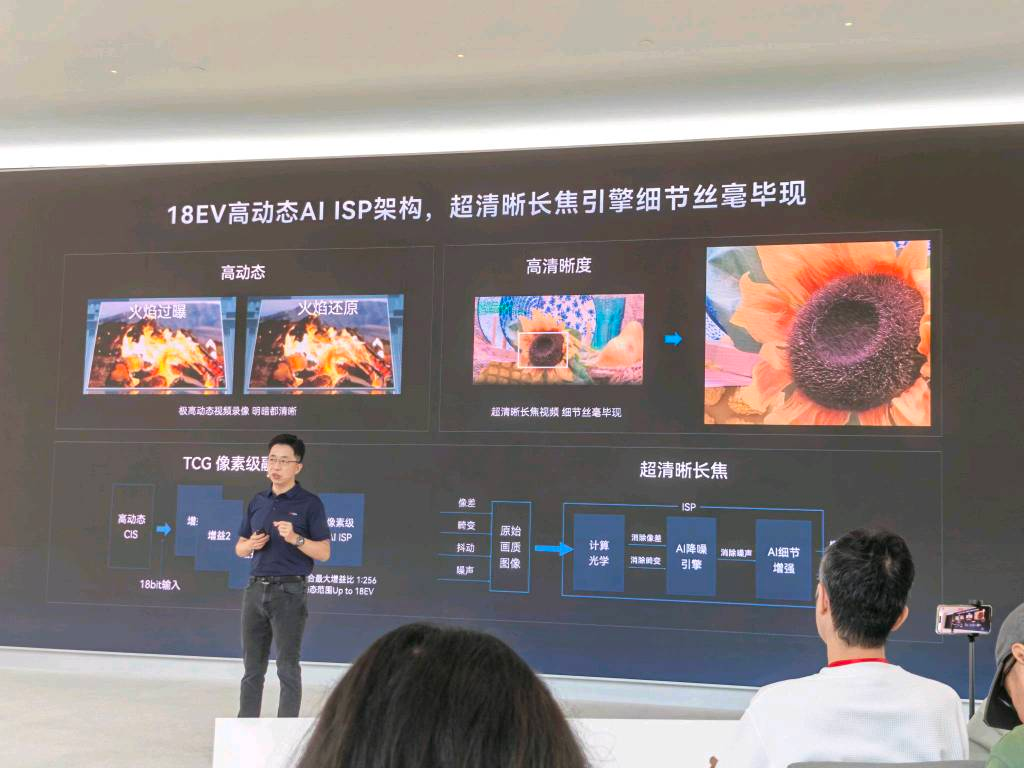
特别针对高动态场景,麒麟9050 Pro支持TCG像素级融合,将动态范围增强到18EV,避免像拍摄火焰,烟花等过曝场景,明暗都清晰。
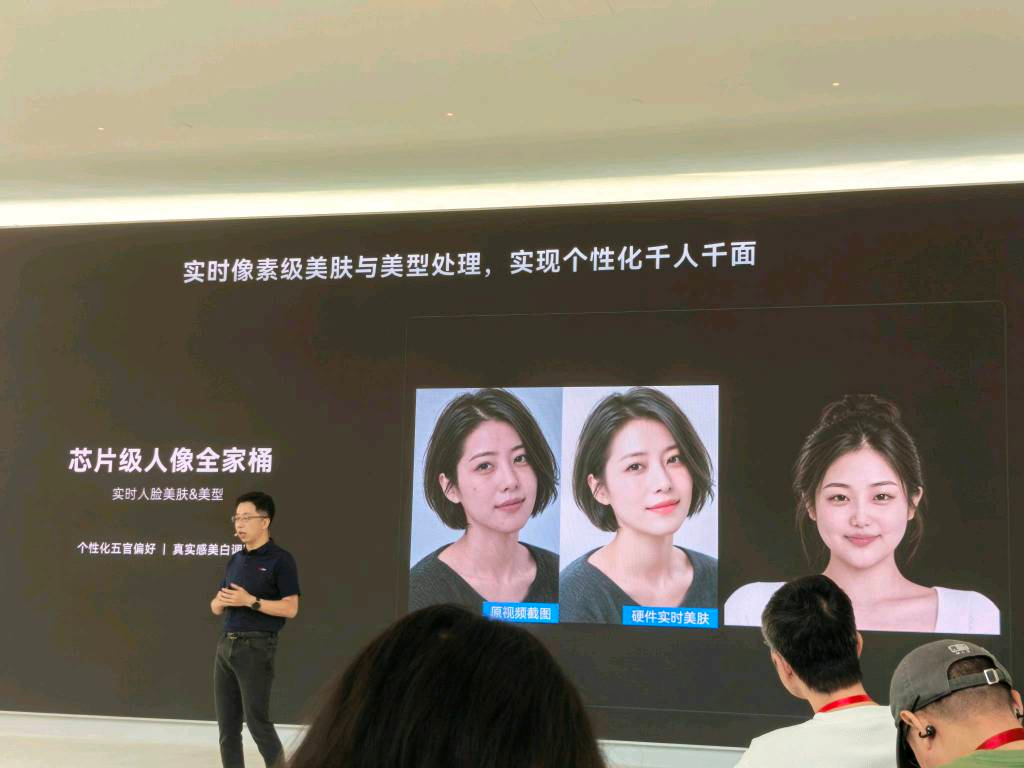
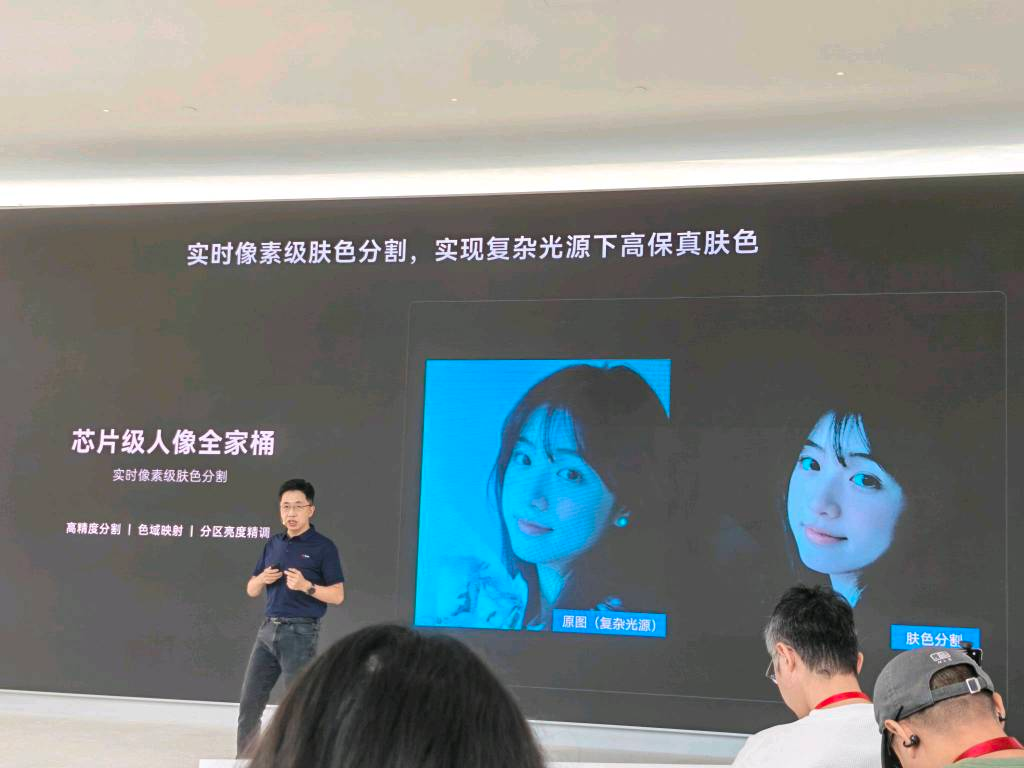
此外,ISP还支持硬件级的人像全家桶,实现硬件级的实时肤色分割。在复杂光源(比如夜景、舞台光)下,芯片通过硬件级的实时像素级分割,把肤色与背景精确分离,再做高保真还原。这背后是“芯片级人像全家桶”的完整能力:硬件级肤色分割加实时像素级美肤美型,让每一帧人像处理都发生在ISP内部,而不是依赖云端。
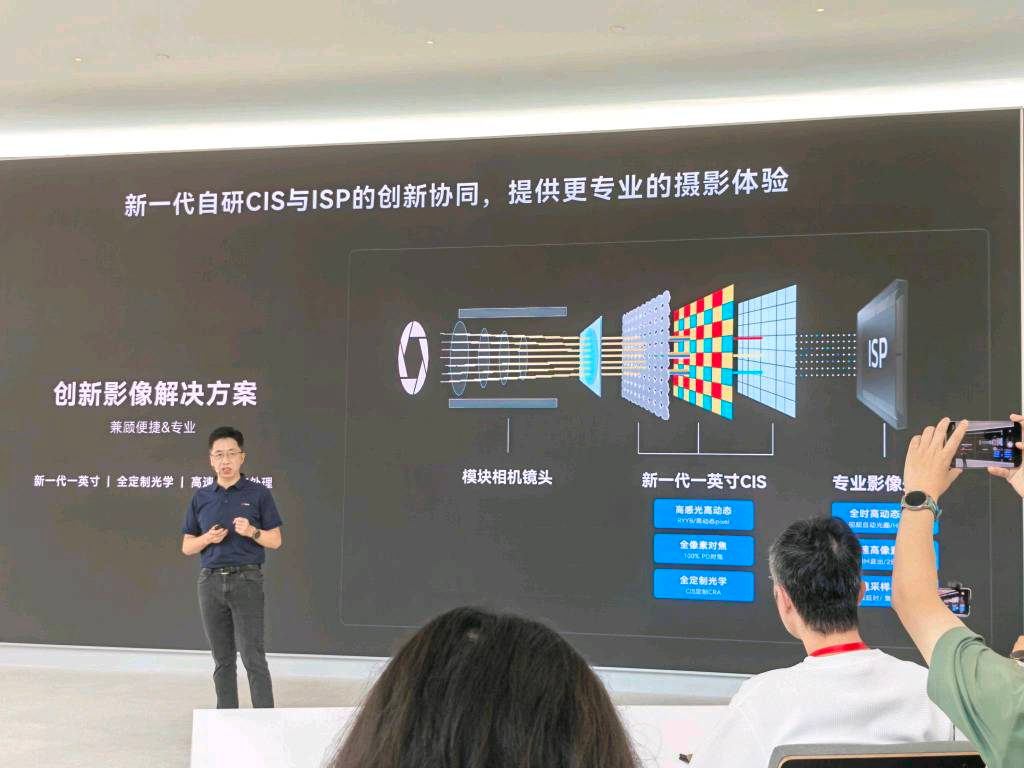
影像方面,通过新一代一英寸自研CIS(CMOS图像传感器)与ISP的创新协同,针对模组做了全光学定制,与高速采样和处理。通过从传感器、光学到芯片处理链路的端到端创新,带来移动影像新体验。也为华为睿影Z10等相机模组提供支持。
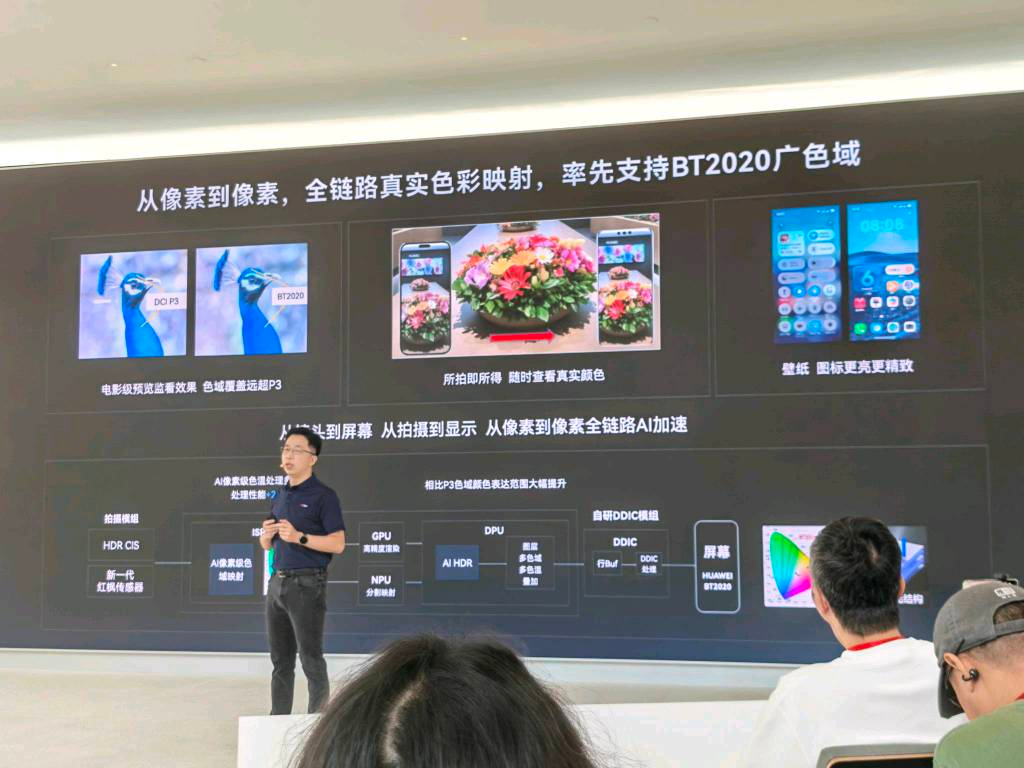
率先支持全链路BT.2020广色域处理。从镜头到显示端到端,麒麟9050 Pro都按BT.2020广色域标准处理,BT.2020的色域表达范围远超传统P3色域。这意味着照片和视频在拍摄、处理、显示全链路中都能保留更丰富的色彩信息,让“所见”更接近“所拍”。
通信:新一代巴龙基带 支持四卡三待
在通信能力方面,麒麟9050 Pro采用新一代巴龙基带,架构方面实现三个显著升级。
一是新一代Modem AI架构。跟以往不同之处在于闭环控制策略做了改变,从基于网络参数做闭环控制,到基于用户体验去实现控制。通过精准感知用户通信场景,经过AI推理,调用独有策略提升用户体验。达成QoE闭环。
二是多系统协同架构创新,有效协同天线互助,达成射频性能增强。
三是实现星地一体融合架构技术,围绕直播、高铁、多卡、卫星通信甚至无网场景等,提供更加稳定、安全的通信体验。
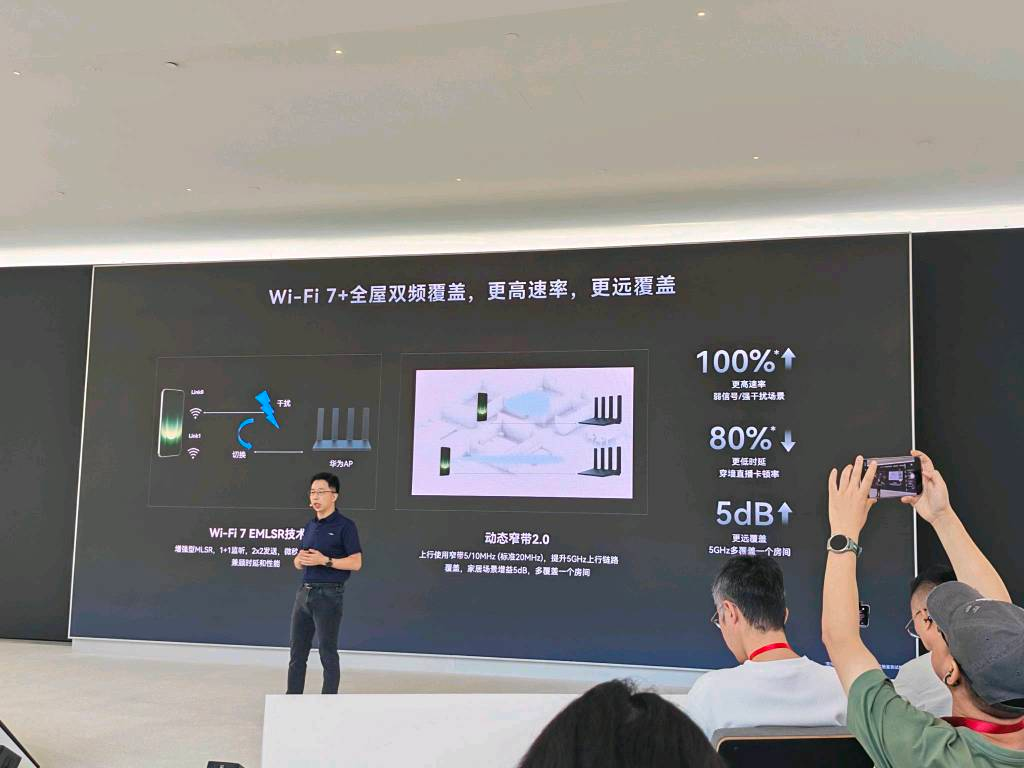
麒麟9050系列的套片支持Wi-Fi 7特性。其中两个技术值得关注:一是增强型多链路单射频(EMLSR),手机同时侦听两个信道,业务发生时微秒级切换到信号更好的信道,兼顾时延和性能;二是动态窄带2.0,上行使用5/10MHz窄带提升5GHz上行覆盖,家庭场景增益5dB,多覆盖一个房间。场景表现上,弱信号/强干扰场景速率提升100%,穿墙直播卡顿率降低80%。
双芯安全架构 率先支持芯片级抗量子安全方案
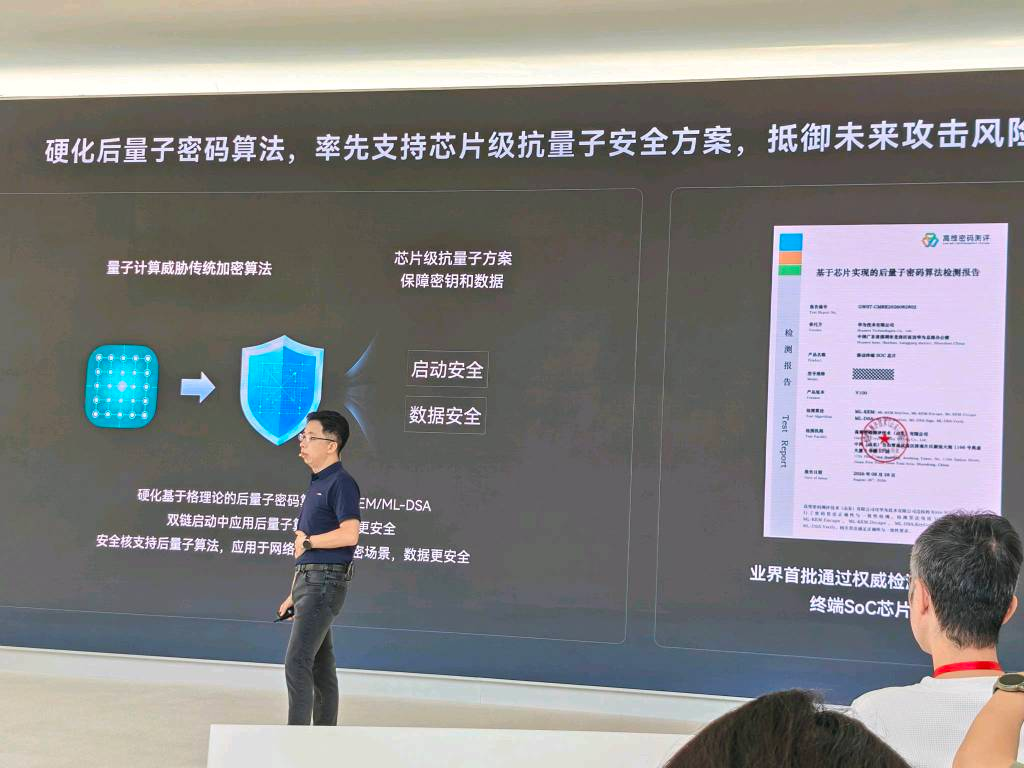
安全方面,麒麟9050 Pro基于芯片实现后量子密码算法,率先支持芯片级量子安全方案,以抵御未来量子计算机成熟之后的攻击风险。徐松余介绍,这是业界首款通过后量子密码算法检测的移动终端SoC手机芯片平台,并且华为已经将后量子算法应用到了手机的启动链上。保证启动安全。未来,华为还将用于网络和数据加密等产品。
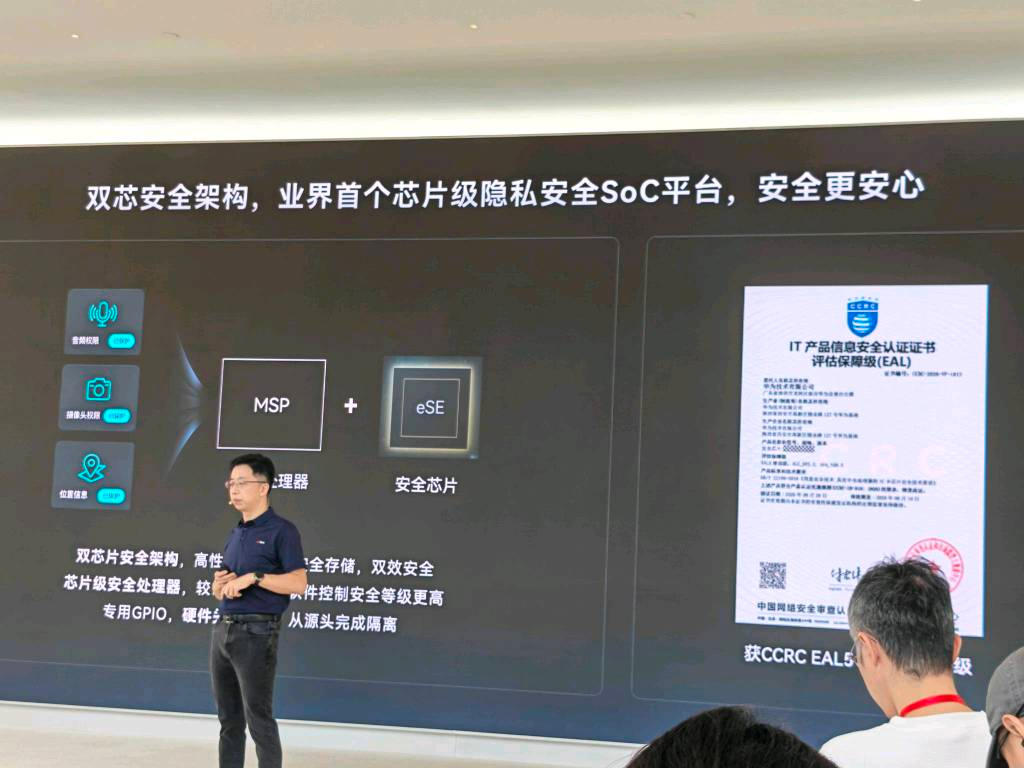
此外,麒麟9050 Pro还实现了双芯安全架构,一个移动安全处理器,加一个独立的安全芯片,提供了双重芯片级的安全保障。
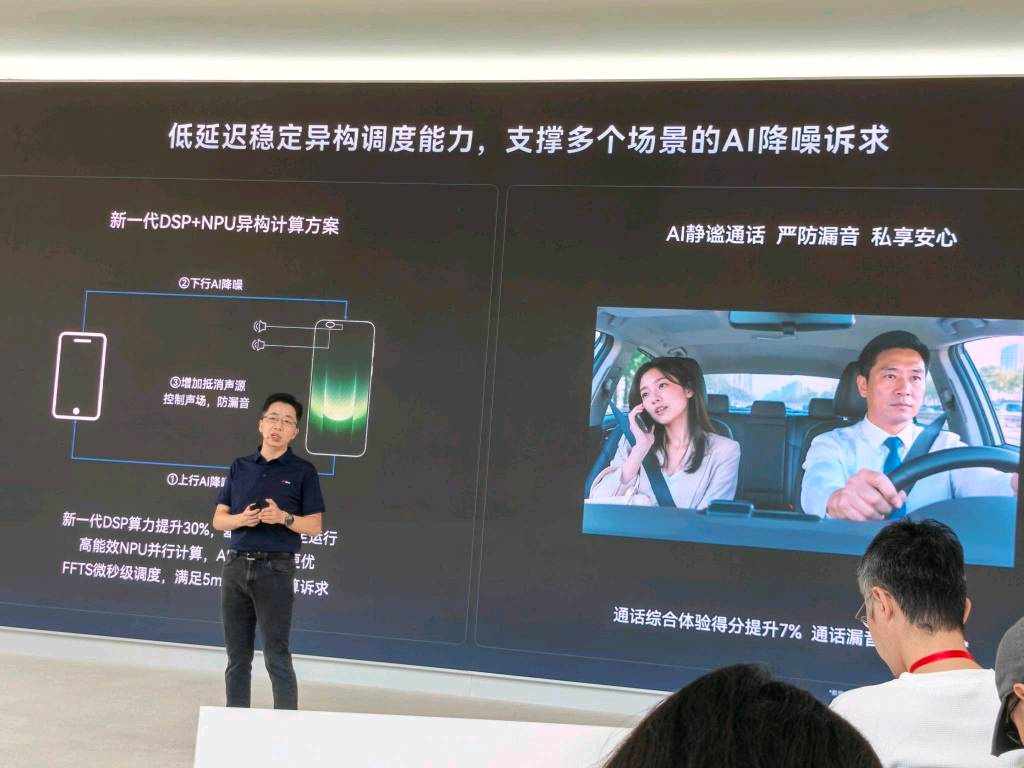
在音频方面,针对通话中降噪诉求,如上行降噪、下行降噪、防漏音等,都是非常挑战的场景。麒麟9050 Pro用新一代DSP加NPU的异构计算来支撑:新一代DSP算力提升30%,NPU高效并行运行,配合FFTS实现微秒级调度,满足低时延要求。效果是AI静谧通话严防漏音,通话综合体验提升7%。
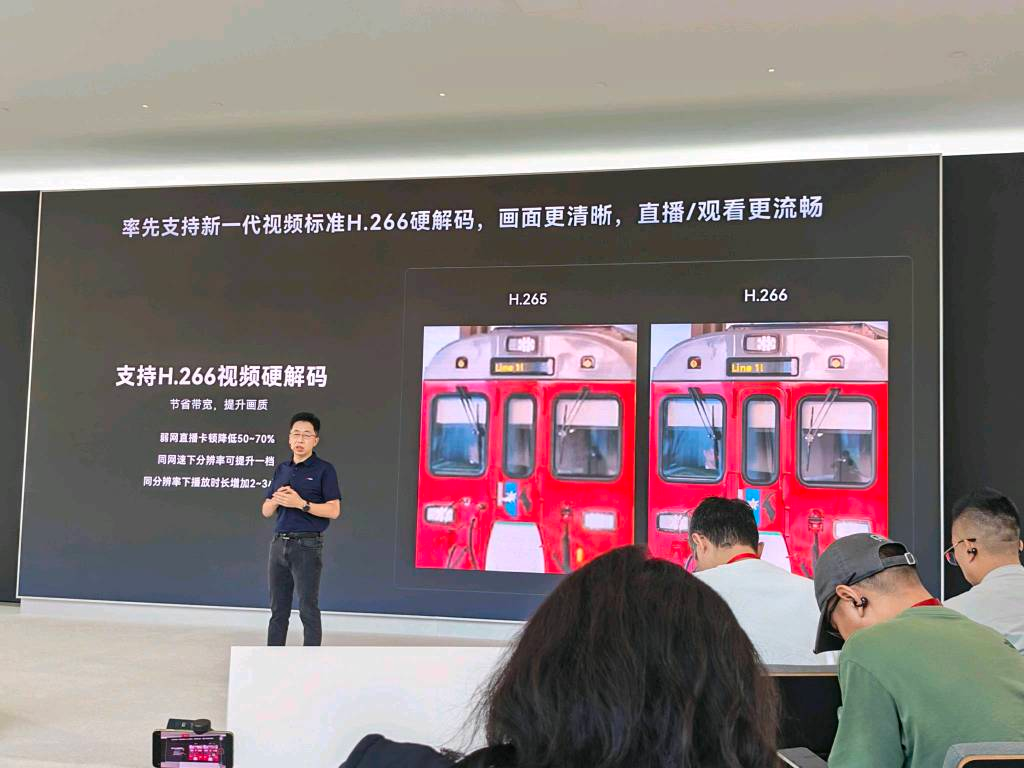
自9030系列起,麒麟芯片已经率先支持了H.266视频硬解码功能,可以消耗更低带宽,提供更高画质。
结语
从2020年因外部封锁而跌入深渊,到2023年麒麟9000S重新站在消费者面前,再到今天 9050 Pro 以“韬定律定义的首颗逻辑折叠芯片”量产落地——麒麟用六年时间证明了一件事:在外部封锁下,除了几何缩微外,高端芯片仍然存在可持续演进的路径。时间缩微带来的不是某一项参数的领先,而是整个SoC从 CPU、NPU 到 ISP、Modem 的系统性重构,合在一起,则是麒麟为AI智能体时代准备好的完整底座。
但这条路刚刚走完第一步。工具链、跨层优化、能耗控制、基准测试,一连串挑战还在前方,正如徐松余所说,未来属于开放合作,没有一家企业能独自解答所有答案。麒麟 2027 芯片样片测试中,全部符合预期。基于韬定律,麒麟9050系列开启的是未来十年 —— 以用户体验为中心,联合芯片、软件、硬件、整机、OS、算法的垂直创新,正在把“用时间换空间”写成中国半导体自己的答案。