Q Labs 发布零阶优化算法 Dust,仅靠前向传播完成 Transformer 预训练,效率较 EGGROLL 提升千倍至万倍,但整体计算开销仍高于反向传播。
反向传播(backpropagation)自二十世纪八十年代以来一直是训练神经网络的主流算法,深度学习的网络架构、优化器乃至GPU硬件生态,很大程度上都围绕可微分性与反向梯度计算构建。2026年10月,小型研究实验室Q Labs Research发布零阶优化算法Dust(论文题为《Dust: Pretraining Transformers Without Backpropagation》),仅依靠前向传播即可完成Transformer预训练,并自称是首个在预训练任务上可与反向传播正面竞争的零阶(zeroth-order)方法。该工作在零阶优化路线内部实现了代际跃迁——相较此前的进化策略方法EGGROLL,作者推算效率提升约一千倍至一万倍——但论文同时明确,其整体计算开销仍高于反向传播,距离工程替代尚有数量级差距。
事件与口径:Dust 发布的核心事实
据DoNews 10月27日报道,Q Labs Research团队推出零阶优化算法Dust,仅依靠前向传播即可完成Transformer预训练。Q Labs官方研究页显示,论文作者为Samip Dahal、Bishwas Mandal、Serdar Gülbahar与Akshay Vegesna四人,工作发布于2026年10月;该实验室官网披露其投资者包括知名计算机科学家Jeff Dean,研究方向聚焦数据效率与泛化能力。
从公开信息看,这项工作要回答的问题相当直接:训练大模型是否必须依赖反向传播。反向传播要求整个网络处处可微,不可微的模块、离散计算与外部程序都无法进入训练回路;而零阶优化不计算解析梯度,仅通过比较目标函数值来指导搜索方向。《华为天筹求解器技术白皮书》对这类方法的界定是:零阶(无梯度)搜索算法不依赖目标函数梯度信息,适用于不可导、无显式表达式的黑箱问题,与一阶方法相比对非平滑、含噪声的优化场景更为稳健——这一概念界定与论文所属技术路线的公开描述相互印证。
需要划清的是事实与宣称的边界:“首个可与反向传播正面竞争的预训练级零阶方法”是论文作者的自述定位;其核心实验基于FineWeb数据集,覆盖200万至2.43亿参数的GPT式Transformer、最高2000万Token的训练预算,与工业界动辄数千亿Token的预训练规模相去甚远。论文作者自己也明确表示,Dust当前并非可直接落地替代反向传播的工程方案。
围绕这项工作,本稿依次梳理其技术机制、在零阶路线中的代际位置、与反向传播及EGGROLL的量化对比、工程可用性、适用边界与产业影响。
机制拆解:虚拟种群如何绕开反向传播
传统零阶优化与进化策略(ES)的通用做法是扰动权重:生成多套略有差异的模型权重副本作为种群个体,逐个执行前向传播,再依据损失变化决定保留哪些扰动。这一路径的成本随模型规模爆炸式增长——每个种群成员都需要一次独立的前向计算,种群越大开销越高,因此业界长期认为零阶方法无法适配大型神经网络。
Dust的核心创新是把扰动从权重空间转移到激活空间,即所谓虚拟种群(Virtual Population)机制。具体而言,Dust不对模型权重加噪声,而是对每个线性层的输出激活独立施加高斯噪声(y→y+σa,其中a服从标准正态分布),且逐Token独立进行;每个Token由此等价于一个独立的“拟种群个体”,一条序列动辄数千个Token,单次前向传播即可并行评估数千个个体,无需复制任何权重副本。这种思路在学术谱系上属于节点扰动(node perturbation),可追溯至Widrow与Lehr在1990年的自适应神经网络研究。
梯度估计环节,Dust统计每一处噪声带来的损失变化,并按其贡献分配奖励:前序Token的扰动可能通过因果注意力影响后续多个Token的预测,因此算法引入带衰减系数的信用分配规则,让改善后续预测的扰动获得额外奖励;将奖励加权后的噪声做平均,即得到线性层输出端的误差估计,再与该层输入做外积,便得到用于更新权重的梯度估计。Q Labs论文页强调,这个外积形式与反向传播完全相同,差别只在误差信号的来源——反向传播用链式法则逐层计算,Dust用种群估计前向获得。
大规模并行扰动也带来信号干扰问题。对此Dust设计了三项针对性措施:不同类型的层分别执行扰动并缓存未扰动的中间结果,避免重复前向计算;注意力模块内部的查询、键、值等组件单独扰动,依据扰动引起的注意力输出变化来分配奖励;语言模型输出头则直接在缓存的Logits上扰动,仅重新计算交叉熵损失,以低成本扩大有效种群规模。除少数残差混合标量仍用普通权重空间进化策略训练外,模型全部权重均通过上述方式更新。
代际谱系:从 MeZO、EGGROLL 到 Dust 的三级跳
零阶方法在大模型上的应用并非始于Dust,理解这条路线需要回到两个先行的坐标。第一环是MeZO:普林斯顿大学团队在NeurIPS 2023发表的《Fine-Tuning Language Models with Just Forward Passes》证明,内存高效的零阶优化器可以让模型微调的显存占用降到推理级别——单张A100 80GB显卡可训练300亿参数模型,而同等显存预算下反向传播微调只能训练约27亿参数模型;实验规模最高覆盖660亿参数,最多实现12倍显存缩减,且兼容LoRA等参数高效微调技术。
第二环是EGGROLL。2025年11月挂载于arXiv的论文《Evolution Strategies at the Hyperscale》(论文编号2511.16652,Sarkar、Fellows、Letcher等,Foerster团队)提出用低秩矩阵扰动替代全秩噪声,将每层辅助存储从m×n降至r(m+n)、单次前向的计算代价从O(mn)降至O(r(m+n)),论文自述由此将进化策略的训练吞吐较朴素实现提升100倍、达到纯批量推理吞吐的91%,并将无反向传播优化扩展到140亿参数模型与超百万成员的种群,还实现了int8纯整数数据类型的语言模型预训练。
但EGGROLL仍在权重空间内运作:每个种群成员都需要占用序列批维度中的一个独立位置,种群规模受限于可负担的前向次数。Dust的跃迁在于彻底绕开权重空间,把种群维度建立在Token轴上,与EGGROLL的批轴正交,从而将单次前向可评估的个体数从“一个”放大到“数千个”。三代工作的递进逻辑清晰:MeZO证明零阶方法可微调大模型,EGGROLL把进化策略推进到预训练量级,Dust则把预训练场景下的采样效率提升了数个量级。
值得说明的是,Dust论文将上述效率对比的口径标注为作者外推:从100万Token训练预算起,Dust较EGGROLL的Transformer实现高效约10³至10⁴倍——Tessera Press在评论中提醒,外推不等于实测,论文本身也明确表示未尝试让Dust达到可替代反向传播的计算效率。
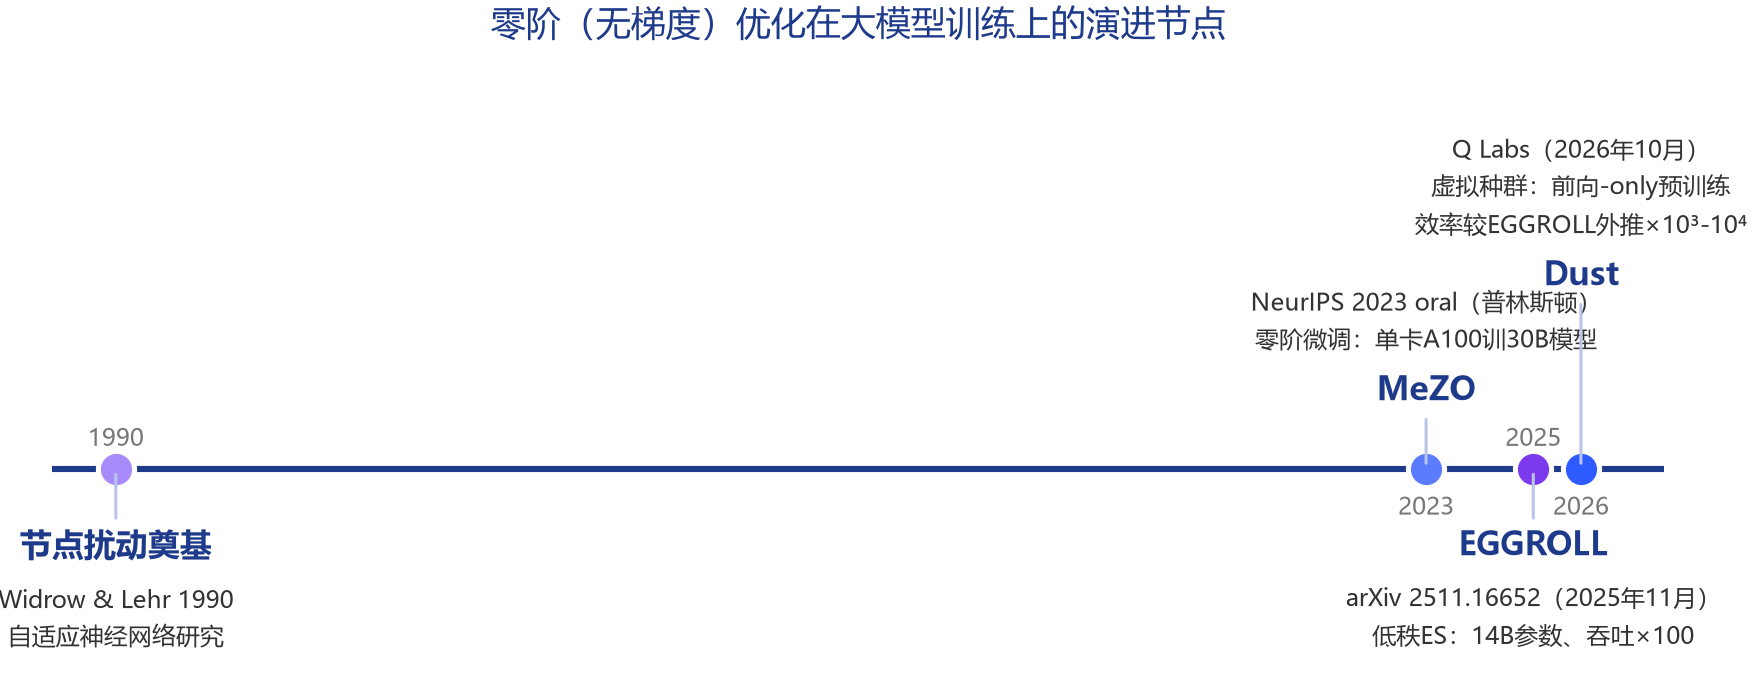
图1 零阶优化路线演进时间轴:从节点扰动、MeZO、EGGROLL到Dust(1990-2026)
数字说话:与 EGGROLL 的千倍对比及与反向传播的边界
Dust与EGGROLL-Transformer的直接对比结果相当悬殊。论文数据显示,EGGROLL-Transformer使用16384个种群成员——即Dust基准采样量64 draws的256倍——仍达不到Dust 64 draws的水平:在10万Token预算下两者差距在0.02以内,而在100万至2000万Token预算下EGGROLL高出0.4至0.6(测试损失);外推显示,从100万Token起Dust高效约10³至10⁴倍,且当种群规模达到256起,Dust的计算量已低于EGGROLL。
与反向传播的对比则需要更谨慎的表述。在10万Token与100万Token的小预算区间,Dust分别在数百draws与约1000 draws的种群规模下将测试损失降到调优后的反向传播之下;在1000万Token预算下,Dust的拟合极限略高于反向传播;在2000万Token预算下,幂律拟合极限为4.431(95%置信区间3.89至4.58),低于反向传播的4.633——但论文明确将此标注为宽松约束的趋势证据,而非直接训练实测。换言之,“Dust在部分配置下优于反向传播”成立的前提是充足算力与大种群,且部分结论来自曲线拟合推测。
另一个打破既往认知的发现是过参数化的正向作用。论文在200万、730万、3800万、2.43亿参数四个规模上对比后发现,更大模型的种群利用效率不降反升:243亿分之一——即比最小模型大120倍的243M参数模型——在绝大多数种群设置下表现优于2.0M小模型;大模型在超过1000 draws后比小模型多获得约30%的增益,而小模型更快进入性能饱和。这与“零阶方法无法扩展到大型网络”的传统判断相反。
梯度质量方面,随种群规模扩大,Dust估计梯度与反向传播梯度的余弦相似度持续走高,且该对齐特性在最高10亿Token的反向传播检查点上保持稳定;作为对照,EGGROLL在12.8万种群下除输出头外各层余弦相似度仍低于0.05。作者同时指出,Dust的估计方向接近但不完全收敛于反向传播梯度,并认为这可能是优点——不同的优化方向有机会形成不同甚至更优的优化轨迹。
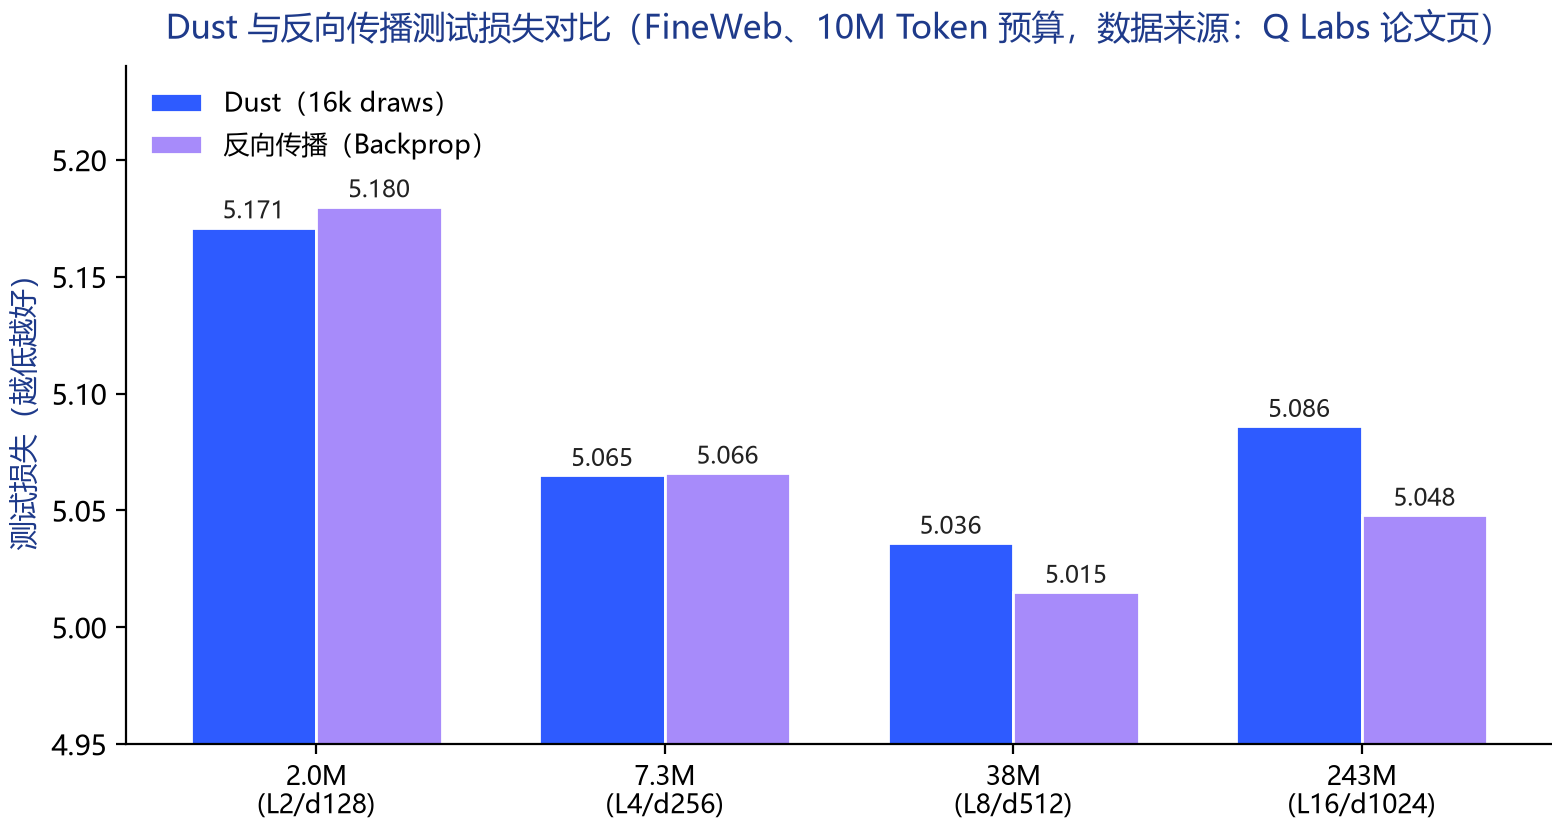
图2 四种参数规模下Dust与反向传播的测试损失对比(10M Token、16k draws)
工程现实:Adam 兼容的价值与开销上限
Dust可以直接兼容Adam等主流优化器,无需专门改造优化逻辑——这是其在工程生态中的关键加分项。论文的Adam对照实验(100万Token预算)显示,Adam同时改善了Dust与反向传播的表现,其中Dust结合Adam后的幂律拟合极限为5.248(95%置信区间5.17至5.30);反观EGGROLL,使用Adam后几乎没有提升,与SGD的结果差距不超过0.01。对研究社区而言,兼容主流优化器意味着现有训练框架的优化器组件可以复用,复现与试用的门槛显著降低。
开源与社区机制也在跟进。Dust代码以MIT许可发布于GitHub(qlabs-eng/dust仓库),提供最小实现与反向传播基线,默认种群规模16384,官方给出8卡GPU的运行配置;此前该实验室的q0工作曾在Slowrun数据固定设定下报告相对参考基线约12.9倍的数据效率;Dust发布后Q Labs还推出了禁用反向传播的“Noise speedrun”公开竞赛,让社区围绕同一基准继续改进算法,其训练用时在十天内从约1.76小时降至1.6秒、约提速4000倍——该成绩以1000万Token设定下达到验证损失4.2为门槛,1.6秒纪录的实际损失为4.186,且比较起点是早期Dust+Adam方案而非反向传播,团队同时提醒部分加速技巧无法扩展到更大规模。
但工程现实的另一面同样清晰:论文作者自述,Dust“必须有数量级更多的计算效率提升,才能在当前算力水平下成为反向传播的实用替代”。实验上限停留在2.43亿参数与2000万Token,与工业级预训练相差三个数量级以上;SOTAAZ Lab的第三方复现提供了更冷静的参照——在论文设定的一轮SGD比较下Dust结果基本可复现,但与反向传播的差距很小;一旦允许反向传播换用更合适的优化器或在同一数据上多训练几轮,反向传播便明显领先,且计算成本远低于Dust。
综合官方与第三方口径可以得出一个平衡的判断:Dust的价值在于验证可行性——证明不依赖链式求导与反向通路,Transformer可以从零完成预训练;而在性能与计算效率上同时超越反向传播,仍是尚未实现的目标。
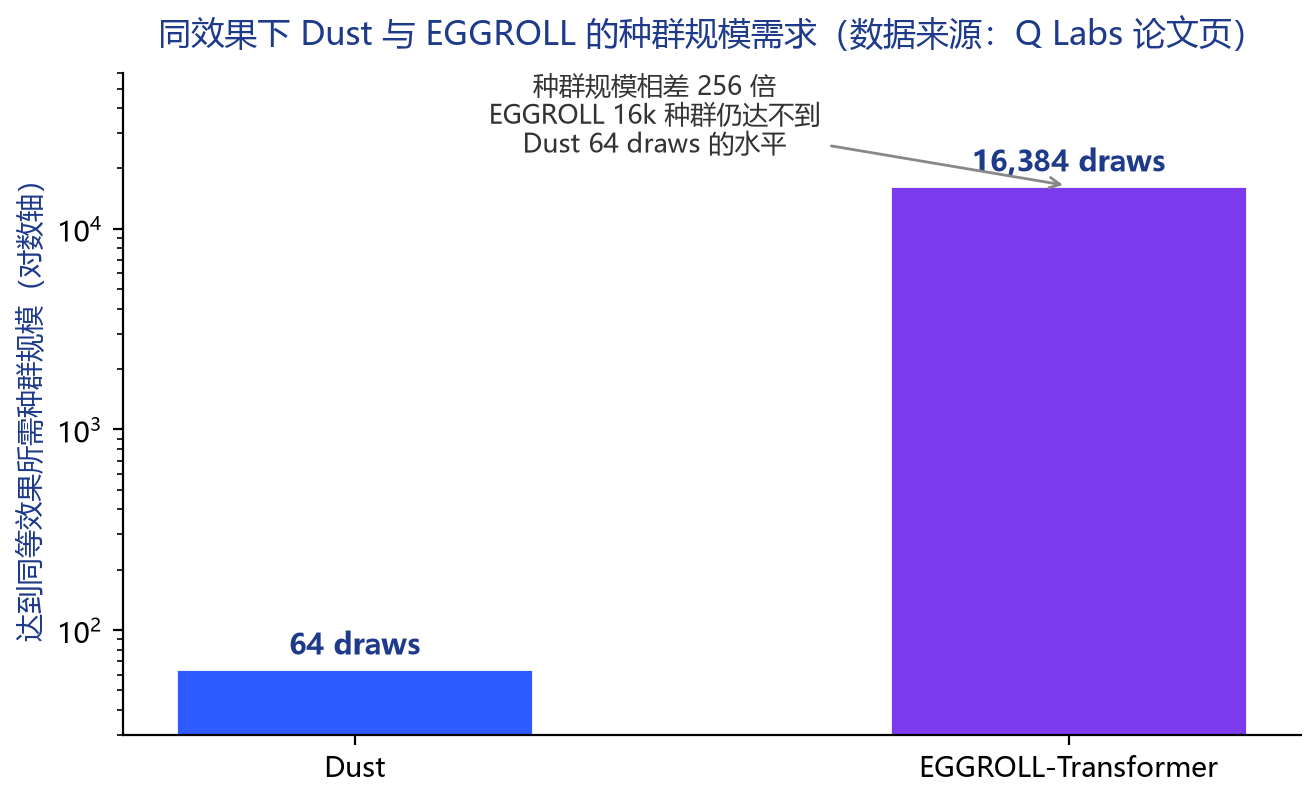
图3 达到同等效果所需种群规模对比:Dust 64 draws vs EGGROLL 16384 draws(256倍)
适用边界:零阶方法在哪里天然占优
即便计算开销更高,零阶方法也并非没有天然阵地。反向传播的前提是网络端到端可微,而真实系统中大量组件不满足这一约束:带外部程序循环的模型、多步循环推演系统、含离散决策或黑盒模块的架构,都无法进入反向传播的训练回路。零阶方法只依赖前向输出与目标函数值,天然适配这些场景——MeZO已证明其可优化准确率、F1等不可微目标,EGGROLL则实现了纯整数数据类型的语言模型预训练。
论文作者将此列为Dust的核心价值之一:验证“训练不一定依赖链式求导与反向通路,无需网络完全可微也能完成Transformer从零预训练”,这意味着未来有机会训练反向传播难以驾驭的网络结构,例如带外部程序循环、多步循环推演的模型。据机器之心报道,论文以Sutton的“苦涩的教训”与AlphaGo Zero的自举对比立论——可微性与反向传播是低算力区间的高效归纳偏置,而在高算力区间,它们反而限制了可训练架构的空间;论文团队同时坦承,Dust尚未实际训练这类非可微架构,相关优势目前仍是推断。
此外,论文自述一个尚未解释的机制现象:在部分充足算力的配置中,大种群的Dust找到了低于反向传播一阶梯度的优化方向,作者推测其可能隐式利用了损失曲面的高阶信息、偏向平坦区域,但机制尚不明确,已列为后续研究方向。对产业与研究者而言,当前可以确认的适用边界是:显存或可微性受限、且算力可大规模并行供给的场景,是零阶路线的合理试验田;而对算力预算敏感的主流预训练任务,反向传播在可预见的时间内仍是default选择。
产业观察:算力高增时代的路线冗余价值
把Dust放回算力产业的坐标系,有助于理解这类“算力换算法”研究的现实土壤。IDC全球AI基础设施追踪器数据显示,2026年第一季度全球AI基础设施支出达897亿美元,同比增长33%;IDC将2026年全年预测上调至4970亿美元,同比增幅约56%,并预计2029年达1.08万亿美元、2030年达1.21万亿美元,自2025年起五年复合增速约30%;2026年第一季度服务器相关支出占总支出的97.6%,ARM架构加速服务器(530亿美元)首次超越x86(346亿美元)。
在这一背景下,“用更暴力的搜索换取算法自由度”的研究逻辑值得认真对待,但影响传导有清晰的前提链条:只有当零阶方法的计算开销收敛到与反向传播可比的量级,它才可能改变训练侧的算力需求结构——例如缓解反向传播对显存(存储中间激活与梯度)与高带宽互联的依赖。论文给出的现状是:Dust在大种群下逼近反向传播,但整体开销仍高出后者,作者要求“数量级更多的效率提升”。因此短期内,Dust类方法对GPU需求结构、芯片设计或云厂商训练服务的影响属于远期情景推演,而非可验证的当期趋势。
更现实的短期影响发生在研究生态层面:其一,零阶路线为不可微架构打开了实验空间,如果带外部程序循环的模型被证明可行,可能催生新的模型架构方向;其二,MIT开源代码与公开竞赛机制降低了社区参与门槛,社区已将小规模基准的优化速度在十天内推高约4000倍,显示这一方向的改进空间仍然很大;其三,电力与电网容量被IDC列为算力扩张的首要约束,任何“以更多计算换取训练自由”的路线最终都要接受能效口径的检验。
需要保持克制的是:目前所有量化结果都来自论文作者及其外推,第三方复现对“明显优势”持保留态度;在独立实验室完成更大规模的复现之前,产业界将其视为一份“技术期权”而非范式切换信号,是更稳妥的定位。
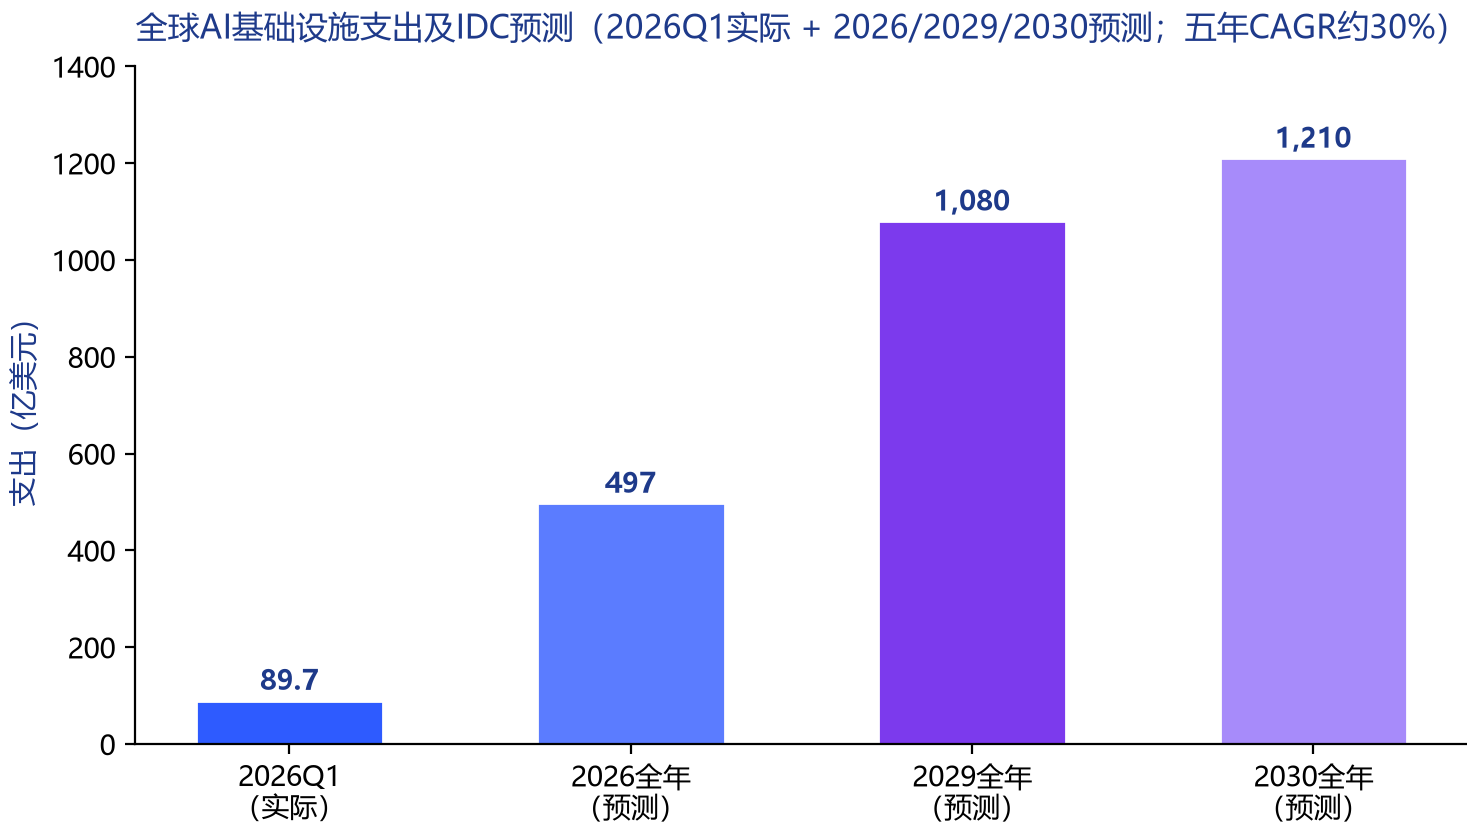
图4 全球AI基础设施支出及IDC预测(2026Q1-2030)
结语:一条并行路线的观察框架
回到事件本身,Dust的发布是零阶优化路线内部的一次代际跃迁,而非对反向传播的替代:它把前向传播预训练的采样效率较EGGROLL推高了千倍至万倍(外推口径),证明了不依赖链式求导的Transformer从零预训练在工程上可行,同时以作者自述的口径保留了“计算开销仍高于反向传播”的边界。论文的意义更接近于开辟一条并行路线,为不可微架构与高算力区间保留了一种可能性。
对后续跟踪,本稿提出三个观察刻度:一是开销差距的收敛速度——零阶方法与反向传播的计算开销比能否从“数量级差距”收敛到“可比区间”;二是规模化验证——是否有独立实验室在10亿参数级、千亿Token级复现其结果,以及SOTAAZ Lab式的冷静检验是否会持续成立;三是生态跟进——主流训练框架、优化器与硬件路线是否为前向-only训练提供原生支持。Q Labs后续计划挖掘损失曲面高阶信息、进一步压缩计算开销并适配特殊网络架构,Noise speedrun社区竞赛的演进亦值得持续关注。
反向传播的统治地位在短期内不会动摇,但大模型训练算法的探索版图上,零阶路线已从“理论不可行”走到“小规模可行”。这条路线最终能走多宽,取决于接下来每一轮复现与规模化的实验结果,而非任何一方的宣称。