近日,我校光电信息学院王超教授团队的研究成果“SALUT: Signed-Digit Attention with Unified LUT-Based Compute for Ternary LLM Inference”被计算机体系结构领域国际会议IEEE国际高性能计算机体系结构研讨会(HPCA 2027)录用。该成果提出面向三值大语言模型(LLM)的统一查表计算架构,使压缩后的注意力缓存直接参与计算,实现线性层与注意力计算的硬件资源共享,为低比特大模型推理提供了兼顾存储压缩与计算效率的新型硬件架构。这篇数字AI芯片计算架构HPCA论文,标志着我校在高能效AI芯片计算架构领域取得重要突破。
我院三年级硕士研究生段子昂与我院王超教授团队本科校友、香港智能晶片与系统研发中心(ACCESS)博士后研究员吴加隽博士为论文共同第一作者,我院王超教授、深圳陆兮科技有限公司首席技术官(CTO)周芃为论文共同通讯作者。华中科技大学、深圳陆兮科技有限公司、香港智能晶片与系统研发中心(ACCESS)等单位共同参与该项工作。
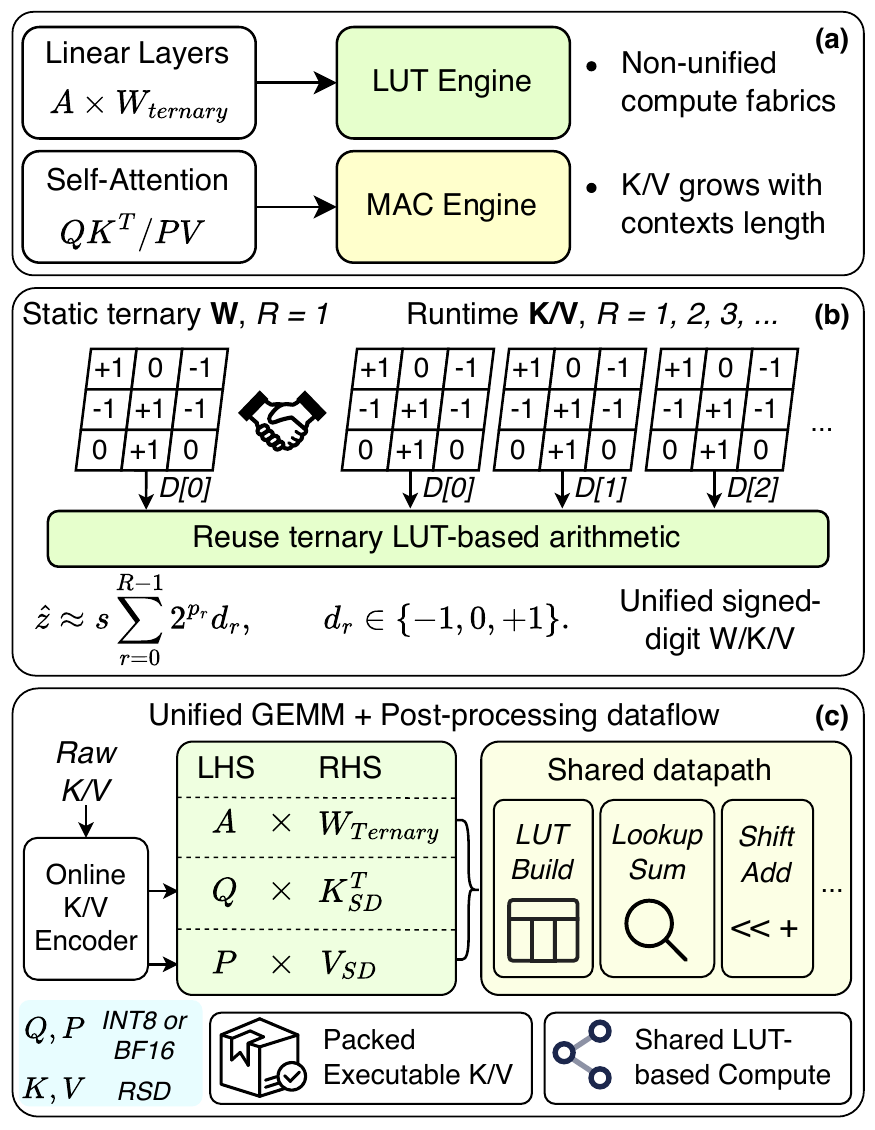
图1 SALUT的核心思路:通过统一的数据表示,让线性层与注意力共享查表计算硬件
面向大语言模型在边缘设备部署中对低功耗、低时延的需求,针对现有三值模型加速器中线性层与注意力计算依赖不同硬件、难以充分共享资源的问题,团队提出基于有符号数字表示的统一查表计算架构SALUT。通过将动态生成的注意力缓存编码为多个三值平面,SALUT使压缩后的数据能够直接参与查表计算,减少高精度数据还原和独立计算引擎带来的开销。在硬件设计层面,团队进一步提出在线编码与统一多流计算机制,并结合硬件感知的混合精度优化,在控制模型质量损失的同时提高计算效率。
该设计基于40 nm工艺开展ASIC芯片综合与硬件评估。在同工艺、固定精度并匹配注意力吞吐的对比中,两种SALUT实现的注意力计算单元能效分别达到低比特浮点(FP4)乘加方案的1.72倍和1.38倍。在4096词元上下文、单请求设置下,计入元数据与尾部工作区后,BitNet-2B和Falcon-E-3B的K/V缓存总存储开销较BF16方案减少约71.4%。研究还在270亿参数三值模型上开展了六项任务评估,无需额外训练即可较好保持参考配置的任务表现,验证了该方法在更大规模模型上的适用性。
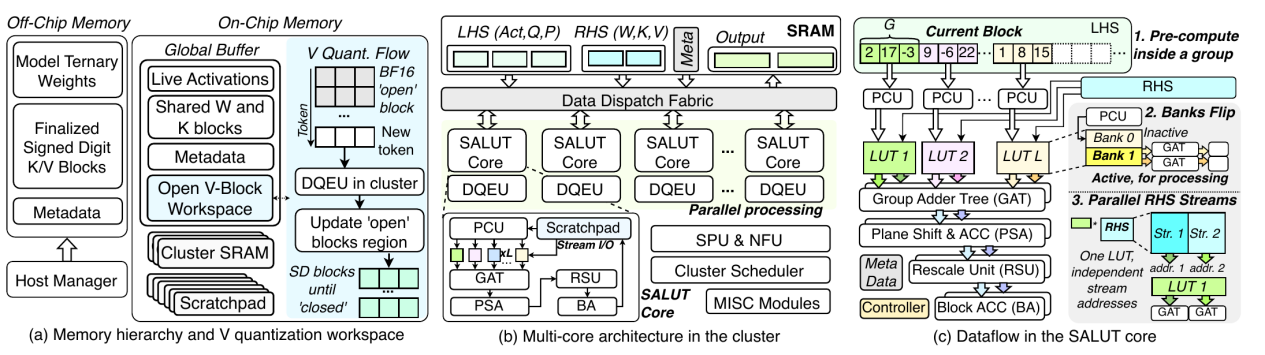
图2 SALUT统一计算架构与数据流
该研究将注意力缓存压缩从存储优化拓展为可直接执行的计算表示,实现数据表示、在线更新与统一计算架构的协同设计,为低功耗大模型硬件加速器及端侧智能应用提供了新的技术路径。
论文相关工作得到华中科技大学交叉研究支持计划(2024JCYJ036)、武汉市科技重大技术攻关项目(2022010402020045)和香港特别行政区政府创新科技署InnoHK创新香港研发平台相关支持,深圳陆兮科技有限公司提供开发与实验资源支持。
IEEE国际高性能计算机体系结构研讨会(HPCA)是计算机体系结构领域的国际顶级学术会议,也是中国计算机学会(CCF)推荐的A类国际学术会议。第33届会议将于2027年3月20日至24日在美国盐湖城举行。根据程序委员会的录用通知,本届HPCA在剔除初审退稿后的1113篇投稿中,录用190篇,另有9篇有条件录用,整体录用率为17.9%。