9月17日,上海。在华为全联接大会2026期间,华为副董事长、轮值董事长汪涛在“智启新未来,打造智能世界的硅基黑土地”主题演讲中,正式推出OceanStor M900 AI记忆存储。这款面向超大规模数据中心AI推理场景的新品,为超节点提供PB级大容量、TB/s级高性能的全共享记忆空间,推动AI基础设施从以计算为中心,迈向计算、网络与存储深度协同的新阶段,进一步释放超节点算力潜能。
1 事件与产品定位
1.1 一场发布背后的时代命题
华为选择在此时点推出“AI记忆存储”,并非偶然。按照华为在发布稿中的判断,2026年,人工智能正加速从技术突破走向规模应用:AI应用从Chatbot对话进一步演进为能够自主完成复杂任务的智能体(Agent),并加速进入科研、医疗、金融和公共服务等关系国计民生的重要领域——人类社会由此进入Agentic AI时代。
本届华为全联接大会于2026年9月17—19日在上海世博展览馆及世博中心举办,以“智启新未来”为主题。在“智能世界的硅基黑土地”这一演讲主题之下,存储被置于与计算同等重要的基础位置:OceanStor M900的官方定语是“AI记忆存储”(英文版新闻稿称Context Memory Storage,即“上下文记忆存储”),它处理的不是普通业务数据,而是大模型推理过程中产生的“记忆”数据——KV Cache。
1.2 什么是“AI记忆存储”
按照华为官方FAQ的定义,华为AI记忆存储是面向超大规模数据中心超节点的新型数据基础设施,以OceanStor M900为代表,为超节点提供PB级全共享记忆空间,支持KV Cache跨显存、内存和SSD分级存储与高效调度。
这一产品类别的出现,意味着存储第一次被明确地纳入大模型推理的主路径——过去以“存数据”为目标的存储系统,如今要以“供记忆”的方式直接参与推理过程。华为在发布稿中将其定性为:推动AI基础设施从以计算为中心,迈向计算、网络与存储深度协同的新阶段。
2 技术原理深潜:KV Cache为何需要一块“全共享记忆”
2.1 KV Cache:大模型推理中最重要的“记忆”数据
要理解OceanStor M900的产品逻辑,先要理解KV Cache。按照华为官方FAQ的解释,KV Cache是大模型推理过程中缓存已计算的Key和Value,并在后续推理过程中复用,以避免重复计算的数据。随着长上下文、多轮推理和复杂任务的发展,KV Cache规模持续增长,成为AI推理过程中重要的“记忆”数据。
换句话说,模型每生成一段回答,都不必从头重算此前已处理过的上下文——这份“免于重算”的代价,就是KV Cache占用的存储容量。上下文越长、对话轮次越多,KV Cache的体积就越大。
2.2 容量与性价比的双重天花板
压力正在从两端同时到来。华为在发布稿中给出了两个关键背景:其一,随着大模型迈向10T级参数规模,超节点成为AI基础设施建设的必然选择;其二,业界主流大模型的上下文窗口已突破百万词元,多轮推理和复杂任务成为常态,推理过程中产生的KV Cache数据规模持续增长。
KV Cache的承载介质由此成为瓶颈:显存和内存的容量与性价比,均已无法满足需求。英文版新闻稿的表述更为直接——这些趋势已经把显存与DRAM在容量和成本效益上推向极限。正因如此,华为判断:构建显存、内存与SSD协同的多级存储体系,打造大容量的全共享记忆空间,已成为行业共识。
2.3 M900的解法:全局池化共享 + 分级存储
OceanStor M900给出的第一项核心能力,是“打破容量边界”:依托灵衢高速互联网络,实现KV Cache的全局池化共享和分级存储,将超节点的KV Cache从显存与内存扩展至SSD。
两个官方数字勾勒出扩展的幅度:单集群可提供64PB容量;单NPU可用KV Cache容量从GB级提升至TB级。对推理集群而言,这意味着更多上下文得以保存、共享和复用,从而大幅提升KV Cache缓存命中率——命中率越高,需要重复计算的部分就越少,算力的有效利用率随之提高。
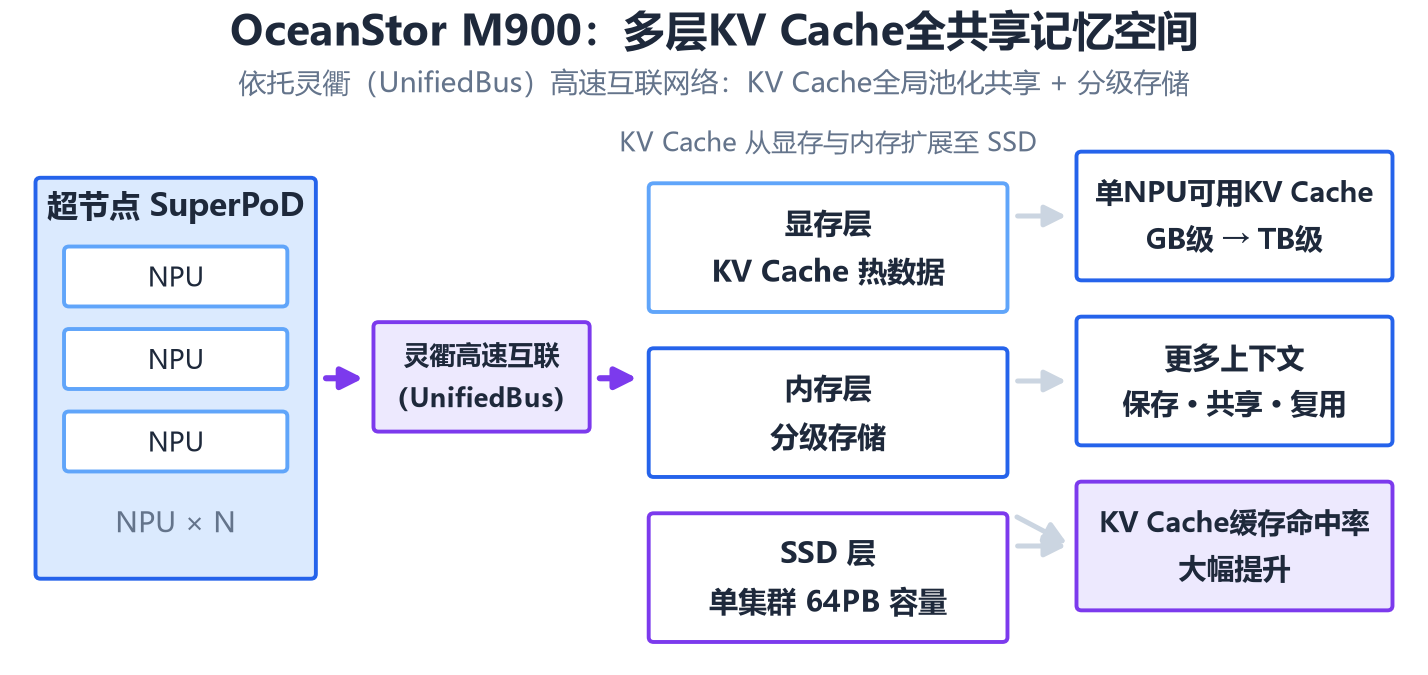
图1|OceanStor M900多层KV Cache全共享记忆空间示意
3 关键技术拆解:三芯合一与“一跳直通”
3.1 把三条数据通路收进一颗芯片
容量问题解决之后,第二个问题是速度:KV Cache存到SSD之后,读取路径会不会变慢?OceanStor M900的第二项核心能力“跃升推理性能”,针对的正是这一点。
其技术底座是业界首创的CPU、网络、盘控三芯合一架构——英文版新闻稿将其表述为业界首个将CPU、网络控制器单元(network controller unit)与NAND控制器单元(NAND controller unit)整合于一体的架构。三芯合一带来的直接收益,是产品可以提供原生KV语义(native KV semantics),让数据以KV Cache自身的语义被存取,而不必在多种协议之间来回转换。
3.2 从ms级到60μs:一跳直通的路径压缩
在传统路径下,NPU访问SSD上的数据,需要经历协议转换和CPU转发。OceanStor M900依托三芯合一架构,实现了超节点的NPU一跳直通到SSD,避免了协议转换和CPU转发。
路径压缩的效果直接体现在时延上:访问时延由ms级降至60μs,缩短90%。聚合带宽方面,单集群可提供40TB/s的访问带宽,相比业界方案提升1.5倍。
表1 OceanStor M900关键参数一览(官方发布口径)
关键指标 | 官方数值 |
单集群KV Cache容量 | 64PB |
单NPU可用KV Cache容量 | GB级→TB级 |
NPU→SSD访问时延 | ms级→60μs,缩短90% |
单集群聚合访问带宽 | 40TB/s,较业界方案提升1.5倍 |
SSD介质寿命 | 提升16倍(最高24 DWPD) |
稳定运行周期 | 三年 |
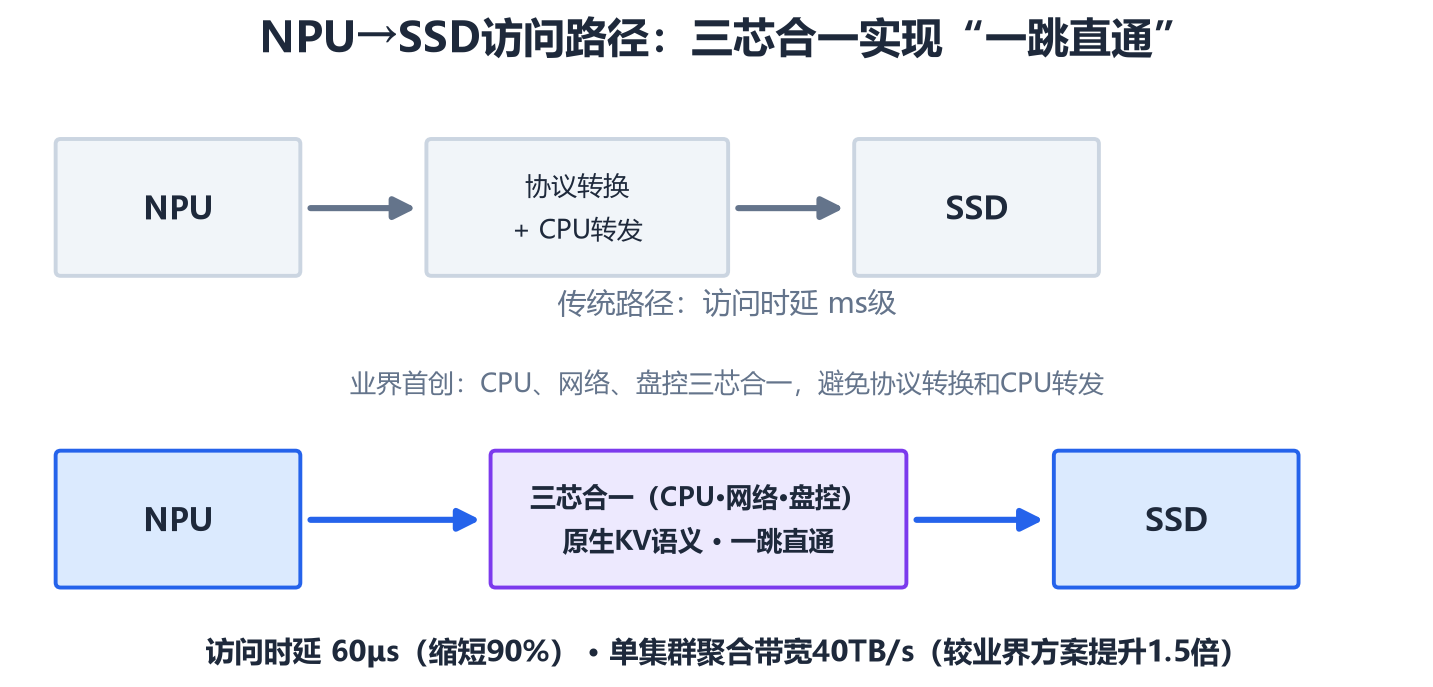
图2|传统访问路径与“一跳直通”对比示意
4 混合介质上的生命周期管理:SSD介质寿命提升16倍
4.1 KV-Aware自适应存储:让数据的“去处”跟着“价值”走
KV Cache大规模下沉到SSD之后,还留下一个工程难题:写入强度。SSD的写入寿命是有限的,业界通常用DWPD(drive writes per day,每日全盘写入次数)衡量一块盘每天可以被整体写多少遍——这个数字越高,对介质耐久度的要求越苛刻。
OceanStor M900的第三项核心能力“降低Token成本”,靠的是业界首创的KV-Aware自适应存储技术:根据KV Cache数据价值预测生命周期,对多模介质上的数据排布进行智能调度,实现最高24 DWPD,使得SSD介质寿命提升16倍,支撑三年稳定运行。英文版新闻稿同样确认:该技术基于数据价值预测KV Cache生命周期,并将数据在存储介质间智能分布,可实现最高每日24次全盘写入(24 DWPD),将SSD耐久度延长16倍,并保障三年稳定运行。
4.2 从介质寿命到Token成本
介质寿命的经济含义,最终落在“成本”上。华为的表述是:通过减少介质更换和运维投入,降低大规模AI推理基础设施的长期成本,加速人工智能规模化普及。
在超大规模推理集群中,SSD介质的更换节奏与运维投入,正是官方所言“长期成本”的直接构成。SSD介质寿命提升16倍、支撑三年稳定运行,意味着介质更换与相应运维的频次被显著压低,AI推理的“单Token成本”随之下降。这也是华为将这一能力概括为“让AI规模化应用更经济”的原因。
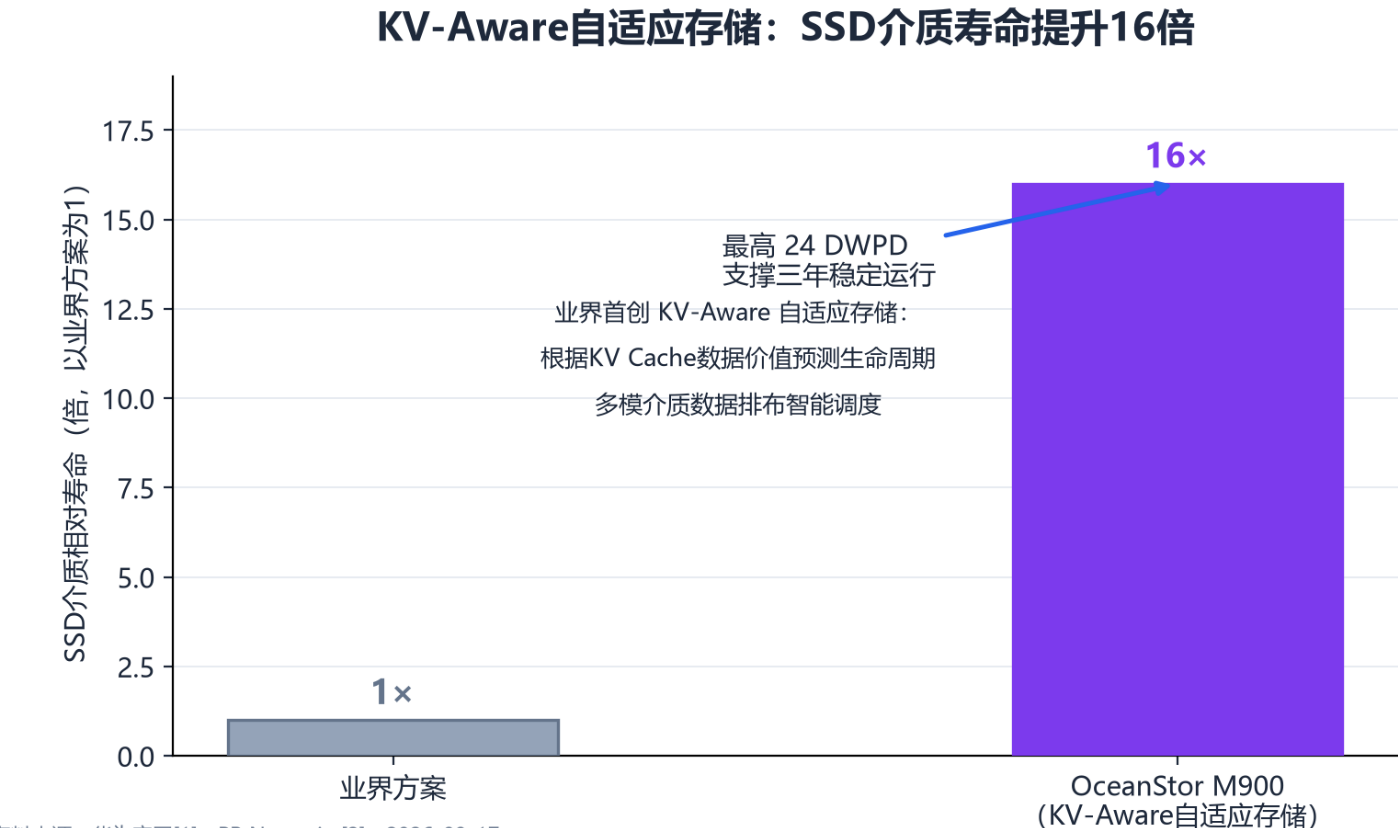
图3|KV-Aware自适应存储与SSD介质寿命提升16倍
5 场景落地:超长上下文、多轮推理与超节点
5.1 直指超长上下文与多轮推理的容量瓶颈
华为推出OceanStor M900的直接动因,是突破超长上下文、多轮推理场景的内存容量瓶颈。当主流大模型的上下文窗口突破百万词元、多轮推理和复杂任务成为常态,推理系统需要的不再是“更大的显存”,而是一层可以按需扩展、全局共享的记忆:KV Cache从显存与内存延伸到SSD,单NPU可用容量从GB级跃升至TB级,让更多上下文得以保存、共享和复用。
对以Agent为代表的智能体应用而言,这一机制尤为重要。智能体需要自主完成复杂任务,其推理过程天然伴随长上下文与多轮交互;上下文保存得越完整、复用得越充分,KV Cache缓存命中率就越高。
5.2 超节点算力潜能的“释放阀”
OceanStor M900的另一重场景价值在于与超节点的配合。产品定位即为超节点提供全共享记忆空间,官方在发布稿中两次强调其与算力释放的关系:“充分释放超节点的算力潜能,加速超大规模数据中心AI推理”,以及“让算力更快转化为生产力”。
量化收益落在典型AI编程场景中:推理集群Token吞吐率翻倍、首Token时延缩短一半。对于以Token为产出计量单位的推理业务而言,这两项指标分别对应产能上限与用户体验的响应起点——也是衡量“记忆—算力”协同是否奏效的最直接标尺。
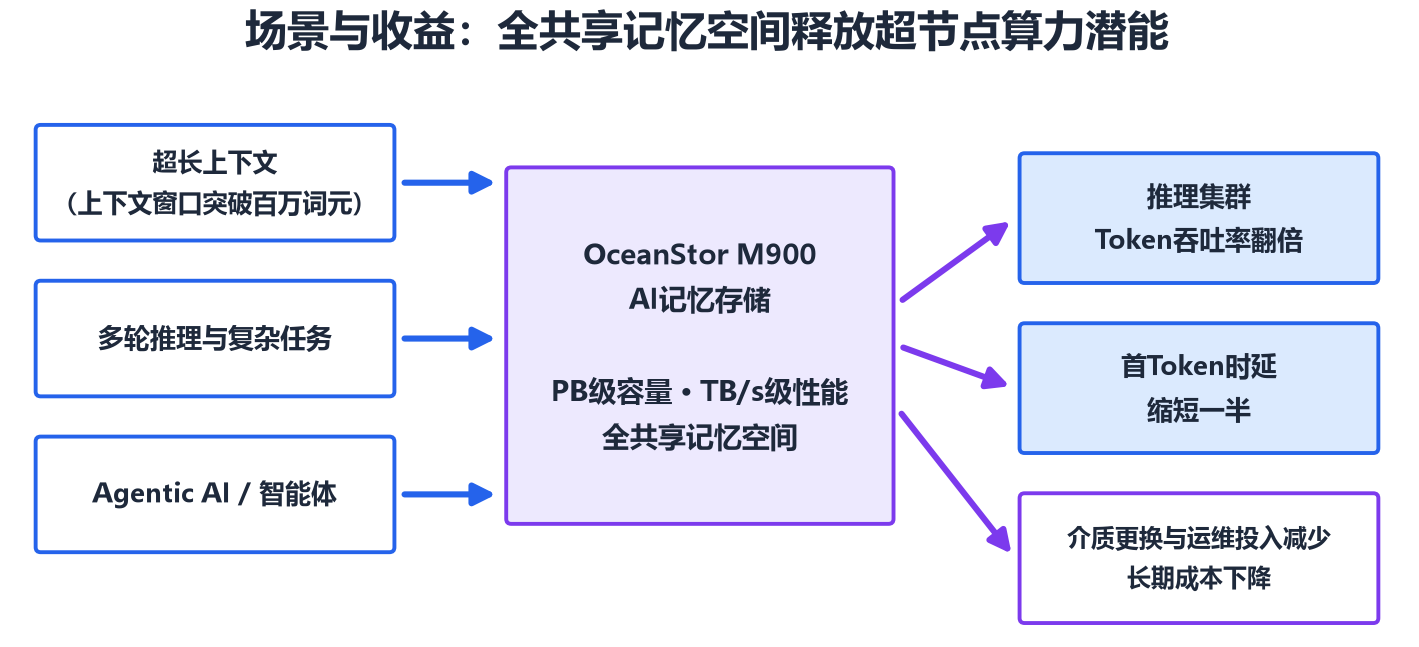
图4|OceanStor M900场景与收益链条
6 影响判断:从“以计算为中心”到算力、网络与存力协同
6.1 AI基础设施的下一程
华为在发布稿的结尾,给出了一段明确的趋势判断:随着人工智能加速进入各行业核心生产系统,AI基础设施将由单纯追求算力规模,进一步迈向算力、网络与存力的系统协同;AI记忆存储将成为持续提升超大规模推理KV Cache容量与访问效率的必然选择。
回看这次发布,OceanStor M900的意义不止于一款新品:它把KV Cache——大模型推理中最重要的“记忆”数据——正式纳入独立存储系统的管辖范围,并依托灵衢(UnifiedBus)互联、业界首创的三芯合一架构与业界首创的KV-Aware自适应存储,给出了“记忆层”的工程化答案。
6.2 观察
从产品命名到技术架构,华为都在传递同一个信号:在Agentic AI时代,推理系统的竞争维度正在从单一的算力密度,扩展为算力、网络与存力的系统协同。存储不再是推理系统的“外挂仓库”,而是与算力并列的生产要素。华为同时表示,将不断推进软硬件协同和系统级创新,打造开放、高效、可持续的AI基础设施,为人工智能技术进步、产业智能化升级提供坚实支撑。
这一判断能否兑现,取决于超大规模数据中心的实际部署效果——64PB容量、60μs时延、16倍介质寿命这些发布数字,最终都要在真实推理负载中接受检验。但至少从华为的判断与布局看,方向已然清晰:AI基础设施的竞争,正在进入“记忆”的竞争。