作者:老王
主要观点:
•初步结论:摩尔定律仍会延续,先进封装与三维集成将分担一部分工作。密度增长正从“单位面积”转向“单位体积”,器件微缩放缓、供电协同补位、封装与三维集成的分量持续上升;约束也从“物理极限”转向“成本极限”。
•“2nm”早已不是2纳米。节点名与栅长、金属间距的对应关系在32nm前后就已断开,2009年版ITRS取消了“技术节点”一词。今天讨论“逼近物理极限”,应看栅极间距、金属间距和成本,而不是节点名本身。
•1.4nm不是终点,而是2028–2029年的集中量产点。台积电A14定于2028年,英特尔14A计划2028年进入大规模量产,三星SF1.4推迟到2029年。imec的路线图则一直延伸到2040年代的A2(0.2nm级)。
•光刻路线出现分叉,换代明显放缓。英特尔以14A率先在量产中导入High-NA EUV,台积电到2029年仍不需要;A16推迟到2027年,三星SF1.4推迟两年,“光学微缩”和同代多版本成为常态。
•器件结构还有两次大换代,但节奏拉长。纳米片→forksheet→CFET→二维沟道是主线;imec预计CFET约2034年导入,进入A级以下后每代间隔拉长到二至四年。
•先进封装与三维集成在2027–2029年多线共振。CoWoS中介层从5.5×光罩(2026)走向14×(2028),混合键合间距从约9µm缩到4.5µm,HBM、面板/玻璃载体与光电共封集中落地;单封装BGA焊球数(估算)2026→2030年约翻一倍。
一、“2nm”不是2纳米:从ITRS取消“技术节点”说起
讨论“2nm逼近物理极限”之前,需要先厘清一个口径问题:今天的节点名称,已经不对应芯片上任何一个物理尺寸。这一点,行业路线图组织在十几年前就已正式承认。
(一)节点名曾经是真实尺寸
在早期,节点名与器件尺寸基本一致。0.5μm、0.35μm工艺的金属半节距和栅长大体相等,节点名就是这两个尺寸。ITRS的传统定义,是工艺允许的接触型第一层金属(M1)的最小半节距(WikiChip)。
(二)脱钩:先是栅长跑得太快,后是栅长不再缩
脱钩分两个阶段,方向恰好相反。
第一阶段是栅长缩得比节点名更快。从1990年代中后期起,处理器厂商为提高主频,激进地缩小栅长,而业界仍沿用旧的命名习惯(3D InCites)。到英特尔2005年的“65nm”工艺,栅长约32nm,M1半节距却约为105nm,三个数字已互不相干(SemiEngineering)。
第二阶段是栅长几乎停止缩小。32nm节点之后,栅长继续缩小的收益变差,甚至反而有所增加,而其他尺寸仍在缩小(WikiChip)。厂商转而通过缩小金属间距和栅极间距来提高密度,节点名与栅长的关联被进一步稀释。
(三)2009年:ITRS取消“技术节点”
在这一背景下,2009年版ITRS取消了“技术节点”一词的相关表述(Design & Reuse)。实际上,在此前的2007年定义中,ITRS已不再给出单一产品的“节点”标识,而是分别跟踪DRAM半节距、MPU/ASIC的M1半节距、闪存多晶硅半节距与栅长等具体指标(STRJ,ITRS 2008概要)。
换言之,路线图组织从此只追踪可测量的尺寸,不再为“节点”背书。14/10/7nm这些名称,只是一代工艺的商业名称,与栅长、金属间距或栅极间距都无对应关系(Design & Reuse)。节点名之所以仍按约0.7倍递减,是因为每代要实现密度翻倍,接触栅极间距(CPP)和最小金属间距(MMP)各需缩小约0.7倍——名称成了摩尔定律的“自我实现”(WikiChip)。图1展示了这两个尺寸在标准单元中的位置。
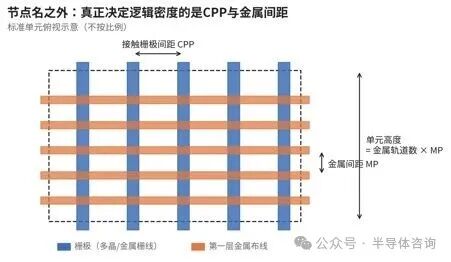
图1 标准单元中的接触栅极间距(CPP)、金属间距(MP)与单元高度
(四)替代方案:用间距和层数说话
ITRS之后,IEEE的IRDS于2017年接替其职能(HPCwire)。IRDS主席Paolo Gargini提出用三项指标替代节点名:接触栅极间距(G)、金属间距(M)和器件层数(T)。按这一记法,“5nm”芯片约为G48M36T1,即栅极间距48nm、金属间距36nm、单层器件(IEEE Spectrum)。imec的最新路线图也在每个节点旁标注CPP与单元高度,最小金属间距从N2的约22nm缩至A3的12–16nm(Always Be Curious)。
表1 节点名与实际关键尺寸
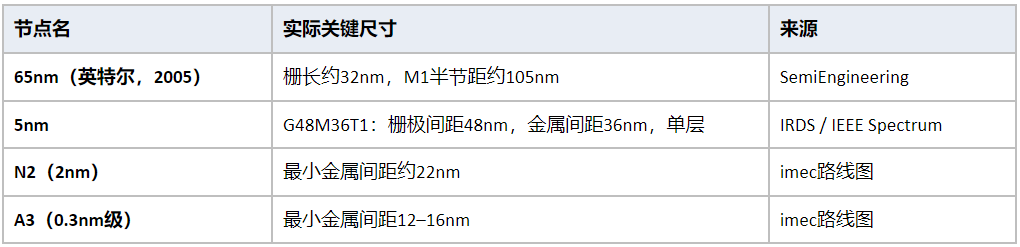
由此看,“2nm已逼近物理极限”的说法并不准确。真正逼近极限的,是栅极间距受制造波动和静电控制的约束,以及金属间距受电阻、电容和可靠性的约束。T(层数)这一项被写进新指标,本身就说明了行业对下一阶段的判断:平面微缩之后,增长主要来自向上堆叠。
二、台积电:不急上High-NA,两条产品线加“光学微缩”
台积电的策略可以概括为“稳节奏、分场景、慢换设备”。2026年4月北美技术论坛公布的路线图一直延伸到2029年,核心是A14的两个衍生工艺A13和A12,以及2nm的延伸版N2U(GIGAZINE)。
第一,按应用拆成两条产品线。N2、N2P、N2U、A14、A13面向手机和终端,优先考虑成本、能效、IP复用与设计兼容性;A16与A12面向数据中心,带背面供电(TrendForce)。A16采用名为Super Power Rail(SPR)的背面供电,基于第一代纳米片GAA;A12于2029年接替A16,作为数据中心级的完整一代升级。背面供电的原理见图2。
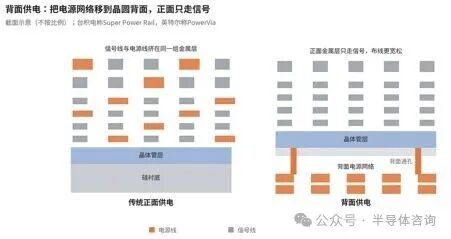
图2 传统正面供电与背面供电结构对比(示意)
第二,A14是第二代纳米片,2028年量产。按台积电高管的说法,A14是其第二代纳米片技术;A13与A12都在A14基础上做了显著的几何微缩,均计划2029年量产(Tom’s Hardware)。
第三,用“光学微缩”换取低成本的密度提升。A13是A14的光学缩版,线性尺寸缩小约3%,晶体管密度提高约6%,同时完全兼容A14的设计规则与电气特性(TrendForce)。6%的密度增益不大,但客户几乎无需重新设计,这是“节点换代”向“同代迭代”转变的典型做法。
第四,到2029年不用High-NA EUV。A13与A12预计都不需要High-NA光刻机(TrendForce)。这与英特尔、三星的选择形成对照。
值得注意的是,A16的量产时间已从2026年推迟到2027年(TrendForce)。在器件之外,台积电把3D堆叠当作另一条增长曲线:A14-to-A14 SoIC计划2029年量产,芯片间I/O密度是N2-on-N2 SoIC的1.8倍(EE Times Asia)。混合键合与传统微凸块的区别见图3。
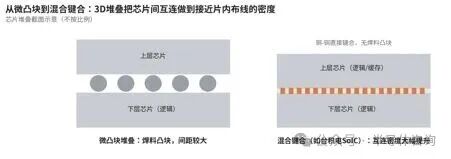
图3 微凸块堆叠与混合键合(SoIC)结构对比(示意)
三、英特尔:押注High-NA,14A成败系于外部客户
英特尔的路线最激进,风险也最集中:技术上率先导入High-NA,商业上必须拿到外部客户。
技术路线。18A于2025年底进入大规模量产,是英特尔目前最先进的节点;下一代14A被设计为业内首个在逻辑量产中使用High-NA EUV的工艺,也是英特尔第一个从立项之初就面向外部客户设计的节点(英特尔2026年报)。按英特尔晶圆代工的材料,14A同时包含High-NA EUV、改进的RibbonFET、背面供电和Turbo Cells(AnySilicon)。更远的10A和7A已经启动研发,预计将沿用14A首次引入的High-NA设备(Tom’s Hardware)。
时间表。2026年二季度,英特尔决定全面投入2028年的量产爬坡;内部产品的风险试产仍按计划在2027年下半年进行(Benzinga)。
商业约束。这是14A真正的分水岭。2025年起,英特尔多次表示,如果拿不到重要外部客户、达不到关键客户里程碑,14A及后续节点将不再经济(TechSpot)。截至目前尚无客户公开承诺,Piper Sandler认为英特尔需要在2026年底或2027年初签下锚定客户。但9月的口风明显转暖:CFO表示,客户讨论已从评估工艺转向能提供多少产能,公司对拿下14A外部客户有了“把握”(Bits&Chips)。
需要同时看到的是,High-NA的导入不只是一台新光刻机,还意味着新的光刻胶、掩模、保护膜、量测工具、设计规则和计算光刻流程(Tom’s Hardware)。对英特尔而言,14A是设备风险与商业风险叠加的一代。
四、三星:放慢节点,先稳良率
三星是三家中调整幅度最大的一家,路线从“抢纳米数”转向“拼稳定性”。
1.4nm推迟两年。三星把SF1.4从2027年推迟到2029年,未来几年集中打磨2nm系列SF2、SF2P、SF2X、SF2A、SF2Z,其中包括带背面供电的版本;首个1nm级工艺SF1A定在2030年前后(Guru3D)。第二代SF1.4+已启动开发,计划2030年量产(TweakTown)。
同代迭代。三星在SAFE论坛上推出2nm的第三个版本SF2P+,同样采用光学微缩,并把推迟1.4nm定性为“战略决定而非挫折”(Digit)。据The Bell报道,推迟的原因是把重心转向SF2与SF2P的良率稳定和工艺优化(TrendForce)。
High-NA的口径不一。The Bell报道称,三星将从1.4nm起在部分层使用High-NA EUV(TrendForce);而三星在2026年下一代光刻与图形化会议上的路线图则显示,目前不计划在2nm和1.4nm量产中使用High-NA,High-NA指向1nm级节点(Guru3D)。两种说法尚待三星正式澄清,本文按“1.4nm部分层或1nm级起导入”的区间理解。
五、研究机构与学术界:结构还有两次换代,但节奏明显放慢
与厂商路线图相比,研究机构看得更远,结论也更一致:摩尔定律不会终止,但推动它的不再是单一的平面微缩。imec CEO的表述是,摩尔定律不会停,但会由多种方法共同推动(Passive Components)。
(一)imec:纳米片→forksheet→CFET→二维沟道
imec的最新逻辑路线图把纳米片时代延伸到A10,以外壁式forksheet过渡,从A7起转入CFET(imec)。CFET把N型与P型晶体管上下堆叠,在纳米片基础上带来约1.6–1.8倍的密度增益(Wccftech)。从平面晶体管到二维沟道,各代结构的差异见图4。
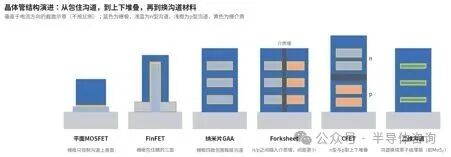
图4 晶体管结构演进:平面MOSFET→FinFET→纳米片GAA→Forksheet→CFET→二维沟道(示意)
时间表比几年前明显保守。2022年时,imec还预计A7在2030年前后到来(Profesional Review);最新版本则把A7推至约2034年,A5约2036年,A3约2040年,二维沟道器件约2043年首次用于A2节点,2046年进入A2以下(Wccftech)。互连也要同步换代:1nm及以下节点将转向半大马士革或减法金属化工艺。
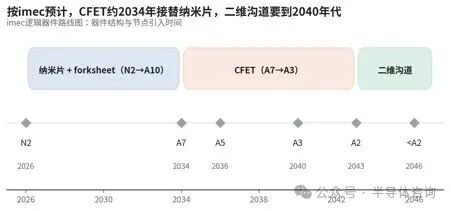
图5imec逻辑器件路线图:纳米片→CFET→二维沟道(2026–2046)
从图中可以看到,纳米片时代还有约八年,而进入A级以下之后,每一代的间隔拉长到二至四年。
(二)IRDS:从“等效微缩”进入“3D功率微缩”
IRDS把芯片微缩划分为三个时代:几何微缩(1975–2002)、等效微缩(2003–2024)和3D功率微缩(2025–2040),并配合异构集成(Gargini,IRDS)。背后的逻辑是:当接触栅极间距因制造波动和静电控制达到极限,二维密度微缩就会停止;即使新型晶体管突破了这一点,互连线的电阻、电容和可靠性问题也会限制布线密度,3D集成因此被视为延续微缩的主要路径(USPTO专利说明)。
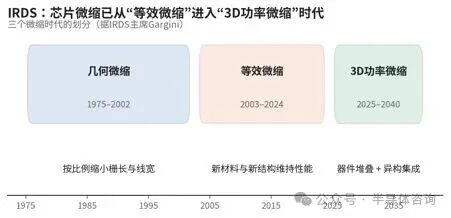
图6IRDS划分的三个微缩时代
(三)二维材料:中国高校进展突出,但距量产仍远
二维半导体只有几个原子厚,被视为CFET之后的沟道材料候选。中国高校在这一方向上的成果较为集中:
•复旦大学:用5900个二硫化钼(MoS₂)晶体管做出32位RISC-V处理器“无极”,2025年4月发表于《自然》;团队认为其器件水平与2022年版IRDS目标相符(Semiconductor Today)。但该芯片在1kHz时钟下运行,功耗0.43mW,与商用逻辑仍差多个数量级。
•北京大学:用硒氧化铋(Bi₂O₂Se)做出晶圆级多层堆叠的二维GAA晶体管,团队称其速度与能效优于英特尔和台积电的最新硅基设计,并把这条路线称为“换道”而非“抄近路”(Tom’s Hardware)。
也有观点指出,二维GAA晶体管能否成为未来主流制造方向仍不确定(TrendForce)。从实验室器件到量产工艺,需要解决晶圆级材料生长、接触电阻、良率与可靠性等一系列问题;按imec的时间表,这一过程以“十年”计。
六、路线图汇总:2028–2029年多线交汇
把三家厂商的量产路线与imec的研究路线图画在同一张曲线图上(图7),可以看到两段明显不同的斜率。2022–2030年,厂商从3nm推进到1nm级,节点名平均每两到三年前进一档,且三家曲线高度贴合;2030年之后,路线图只剩imec一条线,从A7到A2跨越近十年,每一代间隔拉长到二至四年,背后是晶体管结构从纳米片向CFET、再向二维沟道的切换。
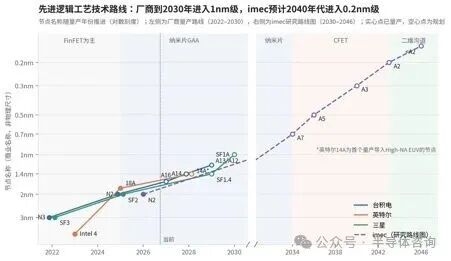
图7 先进逻辑工艺技术路线曲线图:台积电、英特尔、三星与imec(2022–2046)
注:节点名称为各公司商业名称,纵轴位置仅示代际,不代表物理尺寸,也不可在厂商之间直接比较密度。台积电N3、三星SF3(3nm GAA)2022年量产与英特尔Intel 4 2023年量产为已公开的历史节点;imec 2030年后的时间点取自其最新逻辑器件路线图。
再看2025–2030年的细节:1.4nm级工艺集中在2028–2029年量产,而High-NA EUV只在英特尔一侧明确落地(图8)。
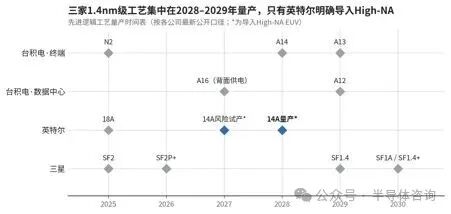
图8 台积电、英特尔、三星先进逻辑工艺量产时间表(2025–2030)
注:英特尔10A、7A已启动研发,尚无公开量产时间;三星SF1.4是否使用High-NA存在报道分歧,图中按“常规EUV或口径未定”处理。
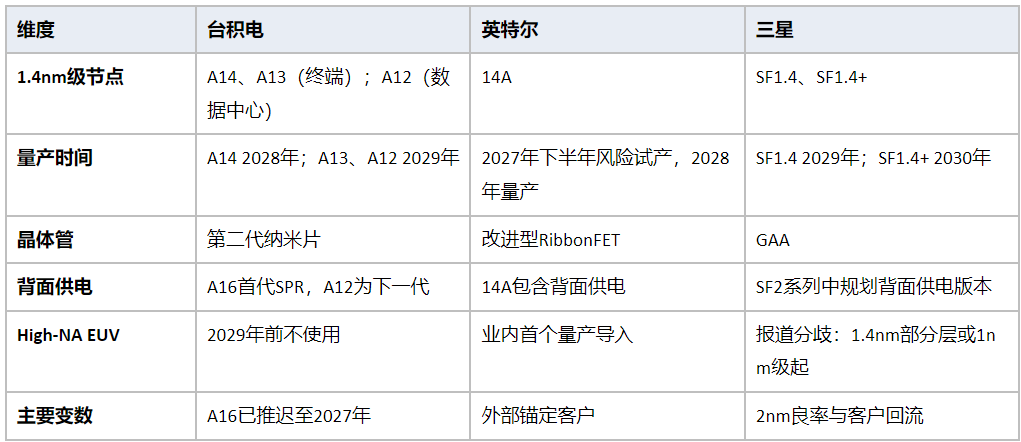
表2 三大厂1.4nm级工艺对比
七、先进封装与三维集成:2027–2029年多线共振
当平面微缩每一步都更难、更贵,算力增长的一部分正转移到封装层面。AI把封装从“后道工序”变成了算力主战场:一颗AI加速器的性能,越来越取决于一个封装里能放下多少颗计算芯片和HBM、彼此之间的互连有多密。
(一)四类主要结构
目前的先进封装可以归为四类结构(图9)。2.5D大中介层把逻辑芯片与HBM并排放在硅中介层上,经微凸块互连,量产微凸块间距约40µm(Chip Scale Review);3D混合键合以铜-铜直接键合取代焊料凸块,间距可做到10µm以下(Onto Innovation);HBM通过TSV把多层DRAM垂直堆叠在基底逻辑芯片上;光电共封(CPO)把光引擎放进封装,缩短电互连距离。
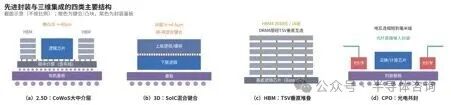
图9 先进封装与三维集成的四类主要结构(示意)
(二)路线图:规模、密度、载体与光互连同步推进
第一,中介层面积两年约2.5倍。台积电5.5×光罩的CoWoS已量产,良率超过98%;14×光罩版本计划2028年量产,可集成约20颗HBM,2029年超过14×光罩、最多24颗HBM(TrendForce)。晶圆级的SoW则超过40×光罩,可集成最多64颗HBM和16个CoWoS模块。英特尔的EMIB-T路线是今年超过8×光罩、2028年超过12×(TrendForce),Foveros-B与Foveros-R目标2027年大规模量产(英特尔2026年报)。
第二,互连密度跨越式提升。据台积电口径,SoIC的互连密度约为2015年代CoWoS的56倍、能效为5倍(TrendForce);混合键合间距预计从约9µm(2025)缩到6µm(2026)、4.5µm(2029),A14-to-A14 SoIC计划2029年量产,芯片间I/O密度较N2-on-N2提升1.8倍(EE Times Asia)。
第三,载体与光互连换代。CoPoS(面板级)预计2027年试产、2028年下半年量产;玻璃基板首家量产已推迟到2027年。台积电COUPE共封光学2026年量产,相比可插拔光模块能效提升一倍、延迟降至十分之一(GIGAZINE),CPO交换机预计2027–2028年规模放量。
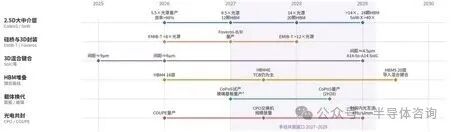
图10 先进封装与三维集成路线图(2025–2030)
注:混合键合间距、HBM键合路线、CoPoS与玻璃基板时点取自作者整理的《全球先进封装技术路线图(2026)》,原始来源为台积电技术论坛、SK海力士Hot Chips 2026、TrendForce与Yole,部分为机构估计;HBM5约2029–2030年。
(三)互连与引脚:从片间到板级同步膨胀
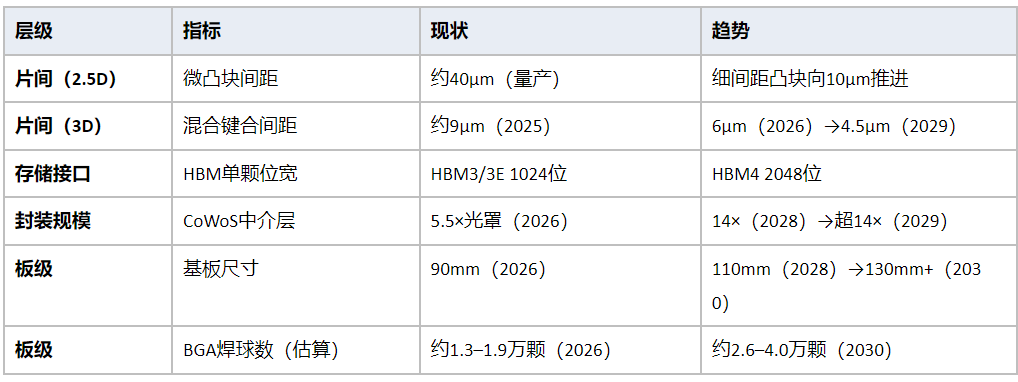
封装放大的直接结果,是各层级的互连数量同步膨胀。片间层面,HBM4把单颗位宽从HBM3/3E的1024位翻倍到2048位(JEDEC JESD270-4);板级层面,封装底部的BGA焊球数随基板尺寸放大。
厂商并未公开单颗芯片的BGA焊球数。公开资料给出的区间是:AI GPU封装通常有5,000至15,000颗以上焊球,球距0.65–0.8mm,H100 SXM5封装约66mm见方(NextPCB)。本文据此按“(基板边长÷球距)²”做满阵列上限估算,基板尺寸取Ibiden路线图:2026年90mm、2028年110mm、2030年130mm以上(Tom’s Hardware)。H100级的估算值约6,800–10,300颗,落在公开区间之内,可作旁证(图11)。
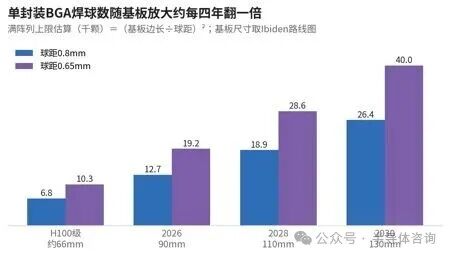
图11 单封装BGA焊球数估算(满阵列上限,千颗)
表3 先进封装互连与引脚指标
(四)瓶颈与分歧
基板是最先吃紧的一环。Ibiden路线图的积层结构从2026年的10-X-10增至2028年的12-X-12、2030年起的14-X-14;有机基板超过约120mm后平整度难以保证,玻璃芯被视为后续方向(Tom’s Hardware)。多方测算ABF供需缺口2026年下半年约10%,2027年约21%,2028年可能超过40%(据Tom’s Hardware整理)。
HBM键合路线存在分歧。SK海力士在Hot Chips 2026上表示HBM4E不用混合键合、全面导入推至HBM5;三星此前的路线图则称最早在HBM4E导入混合键合(36氪)。这一分歧决定了TCB键合机与混合键合设备的需求节奏,值得持续跟踪。
八、初步结论:摩尔定律仍会延续,先进封装与三维集成分担一部分工作
综合三大厂、研究机构与封装路线图,本文的初步结论是:摩尔定律仍会延续,但推动它的不再是单一的平面微缩。imec CEO的判断是,摩尔定律不会停,但会由多种方法共同推动(Passive Components);IRDS则把2025–2040年定义为“3D功率微缩”时代。密度增长正从“单位面积”转向“单位体积”,三股力量分工接力(图12)。
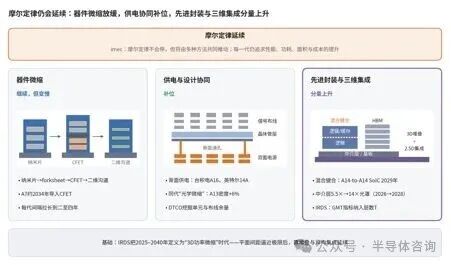
图12 摩尔定律延续的三根支柱(示意)
第一,器件微缩继续,但变慢。“物理极限”需要换一种问法:节点名自2009年起已不再被路线图组织背书,真正受限的是栅极间距和金属间距。按imec的预计,最小金属间距从N2的约22nm缩到A3的12–16nm,还有一段距离可走;但CFET的导入已从“2030年前后”推迟到“2034年前后”,进入A级以下后每代间隔拉长到二至四年。
第二,供电与设计协同补位。2028–2029年三家同时进入第二代纳米片与背面供电,但在光刻上分道扬镳。2030年前的密度提升,将更多来自同代迭代、背面供电和设计-工艺协同优化(DTCO),单代增益会进一步变小。这一轮的胜负,更可能取决于良率与成本,而不是谁先换设备。
第三,先进封装与三维集成的分量上升。中介层两年约2.5倍、混合键合间距四年减半、HBM位宽翻倍、BGA焊球数约四年翻倍,指向的是同一个方向:单个封装正在替代单颗芯片,成为算力的基本单元。对半导体产业链而言,混合键合设备、ABF与玻璃基板、量测检测的重要性,会随先进制程的放缓而上升。
第四,二维材料是2040年代的选项,而不是2030年代的答案。中国高校在这一方向上已有《自然》级成果,可视为一条“换道”的长期储备;但从千赫兹级演示芯片到商用逻辑,中间隔着材料、接触、良率和整套设备生态。
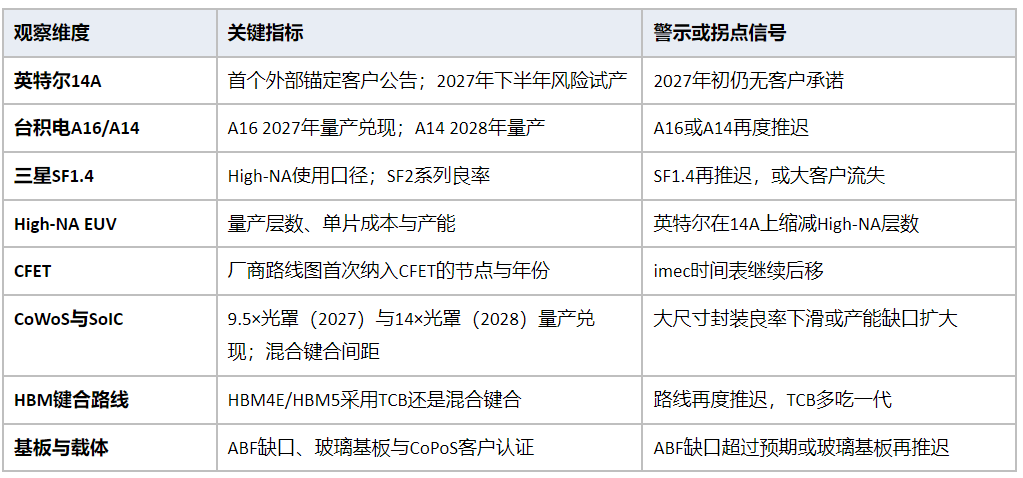
后续值得持续跟踪的指标如下: