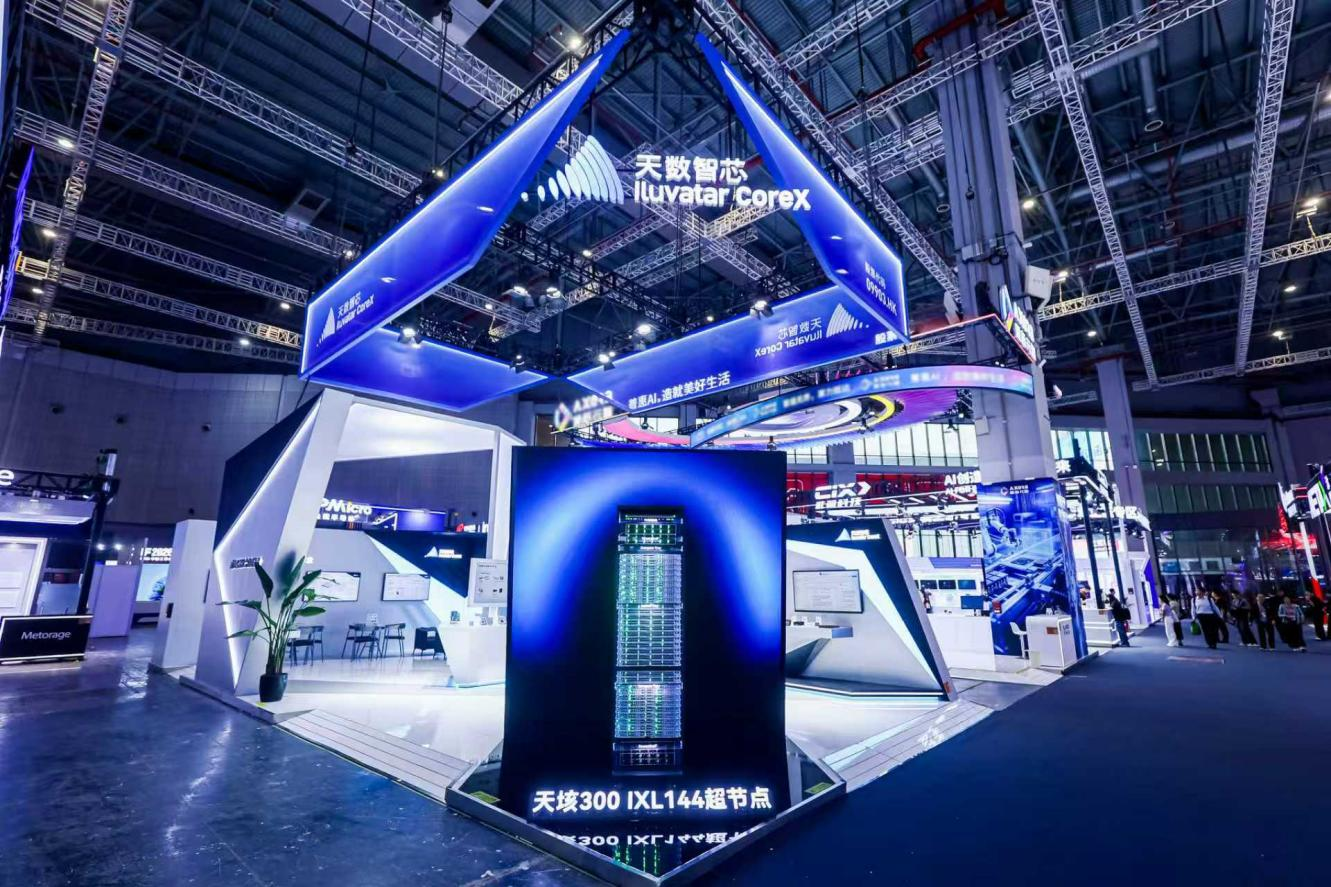
上海,10月12日——10月12日至16日,2026中国国际工业博览会在上海举行。天数智芯系统化超节点布局中的首个方案——天垓300 IXL144首次亮相。作为业界最高密度的单机柜GPU超节点,该方案单柜可集成144颗GPU;公司同步展示天垓、智铠、彤央云边端产品矩阵,以及金融、能源、城市治理、医疗等领域的落地实践。
工博会开幕前夕,中共中央、国务院印发《关于发展新质生产力的意见》,将全面实施“人工智能+”行动、强化算力算法数据高效供给作为重要部署。算力是发展新质生产力的关键底座,其供给质量与系统效能,直接关系数智技术与实体经济融合的深度。天数智芯此次带来的系统级方案与行业实践,以提升系统经济效能为核心,致力于为新质生产力发展提供高质量算力支撑。
超节点规模落地,考题从“造得出”转向“用得起”
大模型与智能体(Agent)加速进入生产,超节点正成为AI基础设施的主力单元。IDC报告显示,智能体进一步拉陡了算力需求曲线,2026年中国智能算力规模预计达2576.5 EFLOPS,同比增长87.9%。需求真实放量,超节点的规模部署随之展开。
从技术验证走向规模采购,客户需要算清三笔账:一是迁移账,已有的模型与代码是否需要推倒重写;二是机房账,是否要为整机柜专门改造供电、承重与散热,乃至新建机房;三是运营账,每百万有效Token的成本能否下降,算力能否按需扩展而不形成闲置。
迁移、机房与运营三笔账合在一起,衡量的正是超节点的系统经济效能——在真实部署条件下,单位投入能够持续产出多少有效算力,这也是全要素生产率在算力基础设施层面的具体体现。天数智芯认为,能够规模铺开的超节点,需要同时具备更高的集成密度、对现有机房更友好、对已有代码更兼容,天垓300 IXL144即沿这一方向设计。
144芯装进单机柜,在系统层面回应规模部署
天垓300 IXL144方案在单柜内集成144颗GPU与18颗CPU,配备约10.1TB 显存。其价值不止于密度,更在于系统经济效能的整体改善。
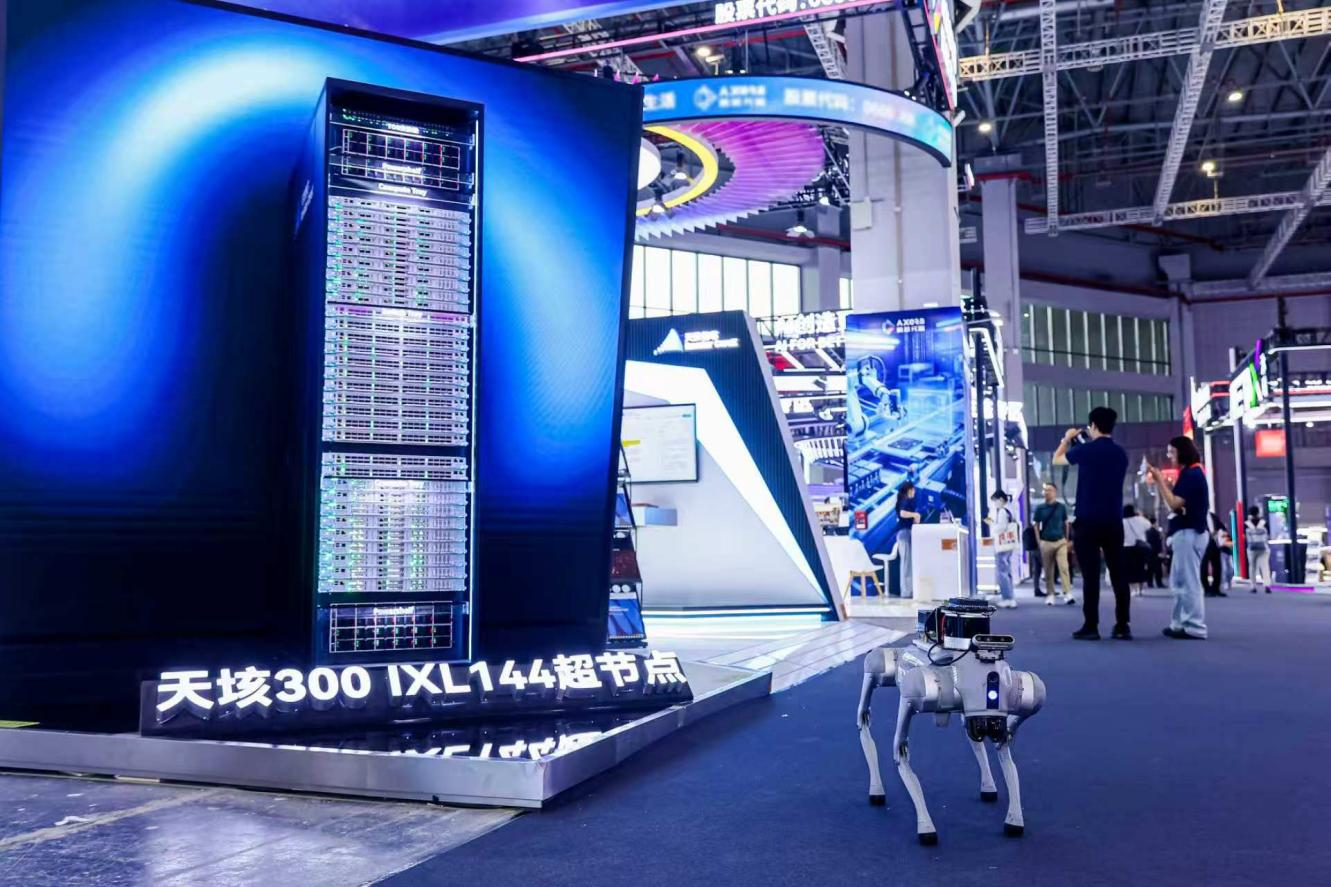
其一,单机柜形态,贴近常规机柜标准。主流整机柜超节点多采用专用整机柜形态,配套专属液冷与供电,往往要求专门机房,即“先建房、再上柜”,改造投入大、周期长。IXL144采用贴近常规机柜标准的单机柜形态,在供配电、承重与散热条件匹配时即可进入现有机房;结合灵活组网拓扑,可一次规划、分步扩展,避免一次性过度投入。
其二,通用GPU兼容主流生态,降低迁移上线成本。自主通用GPU架构与自研软件栈兼容CUDA生态,支持客户复用已有模型、主流框架及开发经验,降低迁移工作量与上线成本。作为通用GPU,同一底座既承载大模型训练与推理,也支撑金融估值、科学智能等任务,区别于仅适配特定AI负载的专用芯片,迁移成本与上线周期相应下降。
其三,整柜互联,144颗GPU协同如一。高带宽整柜P2P互联、100ns级单跳时延、原生Load/Store与跨节点显存直访,将144颗GPU组成统一内存语义的高带宽域;约10.1TB显存为模型权重、MoE专家和长上下文KV Cache留出空间。模型所需并行资源更多在单柜内协同,高频All-to-All交互留在柜内、减少跨柜等待;互联参考设计在特定MoE All-to-All场景实现有效带宽提升15%,资源利用率与单柜业务承载随之改善。
面向大规模在线推理业务,IXL144围绕高并发请求、多业务并行与流量波动等运行特点,以吞吐能力、响应时延和资源利用率为系统优化重点,兼顾业务高峰期的服务承载与低谷期的算力利用,着力提升多业务协同承载能力和长期运营效率。
天数智芯同时关注算力全生命周期的使用效率。在交付与服务环节,本地化团队可提供必要的部署、运维与扩容支持,为大型算力投入提供长期保障;更核心的是系统经济效能的提升——通过计算、互联与调度的协同,让同等投入转化为更多有效算力。据测算,每百万有效Token的成本较国际主流方案可降低40%。
天垓系列已实现万卡级规模部署,天数智芯由此具备系统级交付与运维经验。从今年1月公布四代架构路线图,7月WAIC发布天垓300、效能对标并超越Hopper架构国际主流方案,到此次展示天垓300 IXL144,旗舰GPU能力正从单芯片延伸至整机柜,并在真实机房中持续迭代。
“超节点不是单一产品,而是一项系统工程,最终比拼的是系统经济效能。”天数智芯副总裁邹翾表示,“天垓300 IXL144只是一个开始,是天数智芯整套系统化超节点方案中率先推出的第一个;面向不同算力规模、不同机房条件的完整产品布局已经形成,后续将在合适场合逐一呈现,系统展示我们对超节点的整体思考与技术布局。”
算力需求走向分层,端侧将是独立且庞大的一层
展会现场,天数智芯同步展示了云-边-端完整产品布局。随着AI从云端走向现场,算力需求正在分层:大规模训练与复杂复判集中在云端,而大量要求实时响应、涉及数据安全、需要现场闭环的任务,须在本地、在端侧完成。端侧不是云端能力的简单下放,而是一层独立且规模可观的需求。
长期以来,端侧算力多由专用设备承载,工具链与算子支持有限,模型一旦更新或规模增大,就可能难以移植,设备也容易成为算力孤岛,难以承接持续演进的模型与现场任务。
由云端GPU厂商来做端侧,其优势恰恰来自云端能力的下沉。一是把云端成熟的通用GPU架构与完整软件栈——包括编译器、算子库与性能工具——带到端侧,使端侧能够持续运行更新、更大的模型,而不受制于薄弱的端侧工具链;二是云端与端侧同源,模型在云端训练、端侧部署、云端复判之间顺畅流转、精度对齐,现场场景中“边缘初检、中心复判”的协同正建立于此;三是端侧产品跟随云端同代路线图演进,叠加本地化交付,客户的端侧投入同样具备长期延续性。
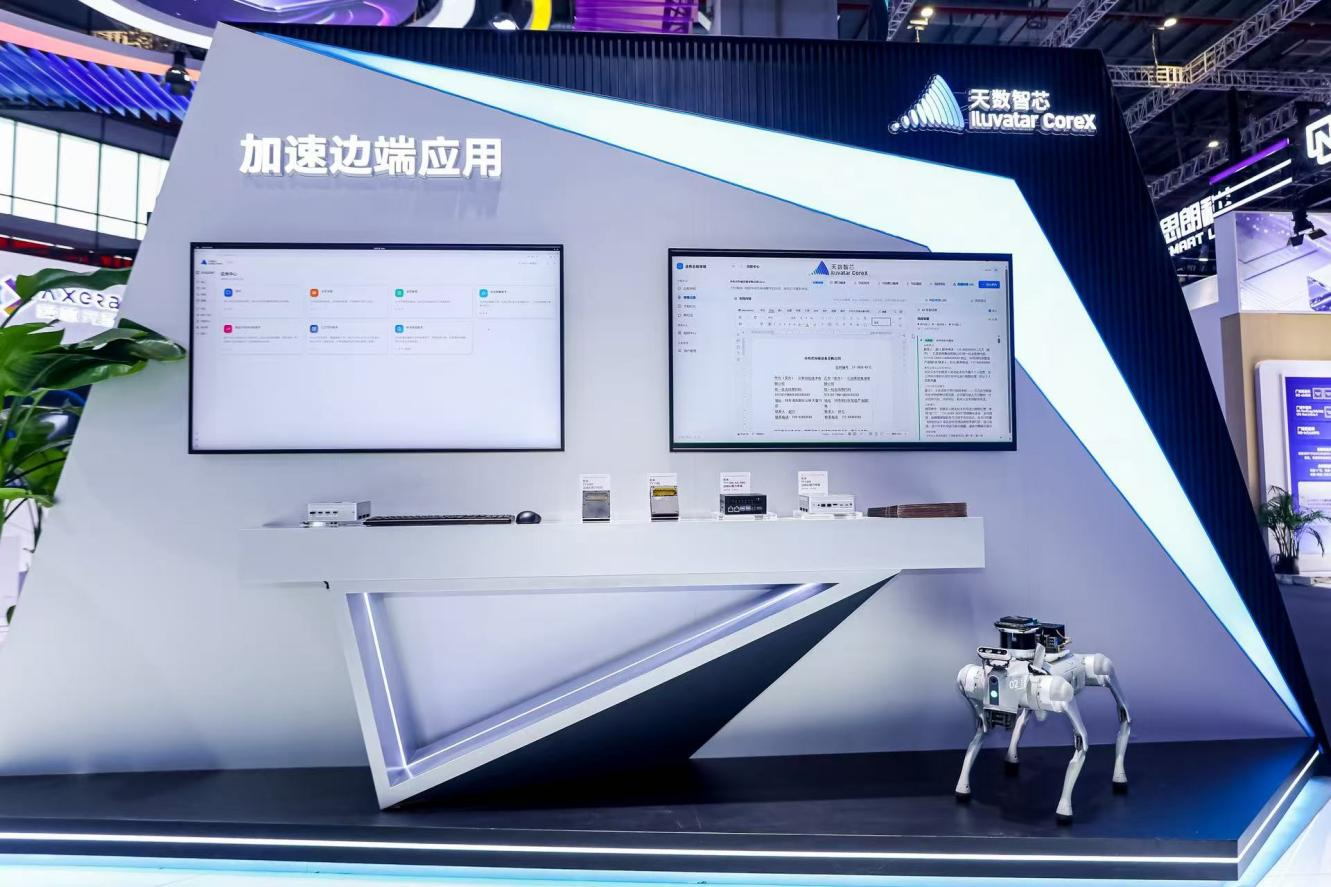
围绕分层需求,智铠系列承接云端及边缘推理,对时延、吞吐与能效进行优化;今年新发布的彤央系列,则以算力模组、算力终端等形态服务端侧,可广泛覆盖物理AI等未来产业以及智能终端、现场作业等多元场景。
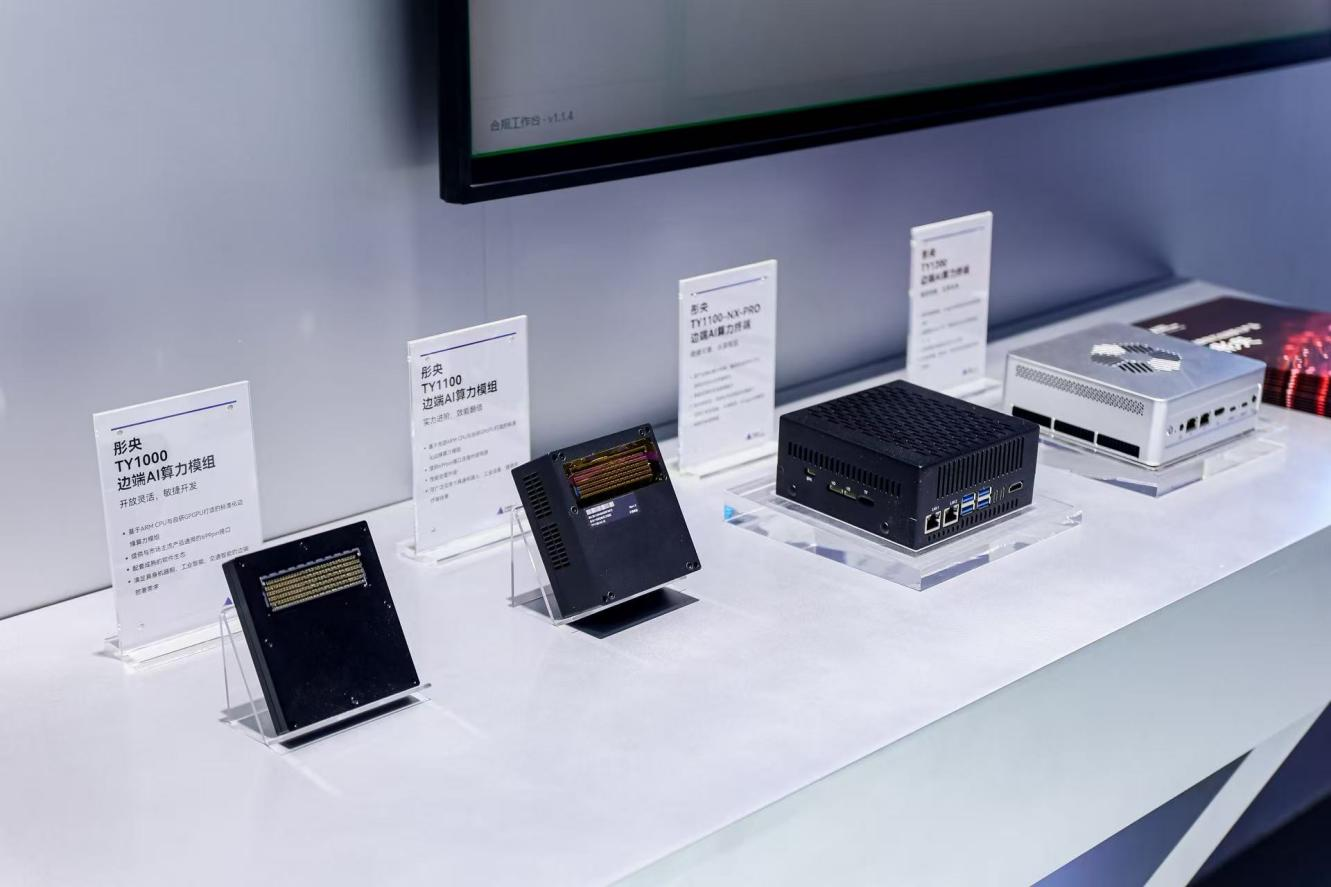
本次现场展示了彤央的一类典型应用——作为物理AI载体的“外挂大脑”,为具身智能设备提供模型运行与实时推理能力、显著提升其智能水平;投资材料分析、合同内容审核等数据敏感场景演示,也同步呈现了同源架构在端侧的模型运行能力,可以基于本地部署的大模型进行离线处理,通过设定业务规则,结合大模型自身强大的理解与泛化能力,在彤央TY1200算力终端上流畅运行,使得本地AI具备投入真实业务场景使用的能力。
规模落地,在千行百业的现场作答
算力的价值,最终由生产环境中的实际成效检验。落实“人工智能+”行动,天数智芯依托“通用GPU+自研软件栈”,推动数智技术进入传统产业改造、新兴产业培育与民生服务,已在一批重点行业形成可复制的落地经验。
工业:让通用GPU进入生产工艺优化。围绕中控技术TPT时序大模型应用一体机,天数智芯基于天垓系列产品接入客户自研工业计算引擎,开展TPT训练与微调测试及自研算法全量性能验证,并基于vLLM完成双卡27B通用大模型推理部署、验证KV Cache三级缓存优化方案。通过时序大模型、通用大模型与工业计算协同,为生产工艺优化、运行状态预测与操作辅助等应用提供算力支撑,体现同一通用GPU底座承载工业AI与传统工艺计算的能力。
金融:同时支撑大模型推理与科学智能。针对多模态大模型在图文混合场景下面临的高并发响应延迟与迁移适配复杂等挑战,天数智芯依托国产GPU算力平台,为银联云提供主流多模态大模型的高效部署与适配支持,实现图文混合负载下的快速首字响应与高并发稳定吞吐,兼顾性能表现与部署便捷性,为金融行业多模态AI应用的规模化落地提供可靠的国产算力支撑。在头部银行案例中,软件栈支持蒙特卡洛模拟算法,并且兼容CuPy、PyTorch异构编程框架,在期权定价场景下最大程度发挥GPU计算性能优势;另外还提供SciPy、NumPy的GPU加速等效方案,在金融产品估值场景下大幅释放并行计算潜能,100万行数据下曲线插值较CPU方案加速约4倍,显著提升运算效率。
能源与矿业:以数智技术改造提升传统产业。在物探领域,处理、建模、成像、解释多轮迭代、算法持续演进,且要求迁移后结果一致,天数智芯以统一GPU资源池贯通数据处理、速度建模、偏移成像与智能解释全流程,适配GeoEast平台、自研算法与AI负载,天垓系列已实现千卡级部署,计算精度与全球领先方案对齐。在智慧矿山,针对井下风险点多、解码识别编码链路割裂、多矿点难集中核验,天数智芯以单卡贯通视频解码、AI识别与编码回传,单机4张智铠100X可实时处理50路1080P视频,告警带画面、跨矿点集中核验;联合百度一见平台,覆盖6类48种作业技能,违规行为识别准确率约85%。
城市治理:让海量摄像头“会思考”,让长尾事件“被发现”。在交通领域,面对抛洒物、事故等长尾事件样本少、全量复核人力负担重,天数智芯联合开云智联,以边缘小模型初检、多模态大模型复判,大模型核心事件阶段测试准确率达90%以上,事件覆盖由7类扩展至16类以上,目标平均发现时间<1分钟。在园区与物业,针对存量摄像头“只看回放”、人工巡查存在空窗、告警与工单脱节,天数智芯联合四格互联,利旧存量摄像头、以边侧算力承载轮巡识别并打通派单闭环,单设备30分钟可轮巡500路,告警准确率提升90%以上,星通大厦巡检间隔由4小时缩至30分钟、缩短83%。
医疗:将AI嵌入医生桌面与医院业务系统。针对临床信息查阅负担重、病历质控与医保审核占用人力、AI难以接入业务流程,天数智芯携手卫宁健康,以国产GPU承载WiNGPT医疗大模型并连接WiNEX业务系统,实现病历缺陷边写边提示、9大类医保规则实时审查,以及7×24小时ICU辅助临床决策。
截至目前,天数智芯已服务30多个行业的380多家商业化客户,落地部署超过1000个项目。客户积累正在形成一条可延续的升级路径:通用软件栈持续演进并承接CUDA生态,客户既有的模型与开发成果得以复用、迁移工作量显著降低;在此基础上,客户能够以熟悉的真实业务负载评估天垓300及超节点性能,验证结果更贴近生产,也更有把握推进后续的验证、采购与扩容。
让Agent参与“造AI”:开发者生态与软件栈升级
随着Agent融入开发流程,人机协同正成为新的开发方式。开发者可在现场体验Iluvatar SkillHub,通过Agent调用Skills,基于天数智算软件栈完成模型适配、精度调优等工作。近期,天数智算软件栈还将迎来版本更新,进一步构建面向Agent协同的智能开发套件,将AI引入模型适配、部署与性能优化等环节,推动开发由人工操作为主向人机协同演进。
未来,天数智芯将持续推进“通用GPU+自研软件栈”体系建设,携手上下游生态伙伴,使高质量算力从单卡走向整柜、从云端延伸至端侧,服务更多产业场景。