美东时间10月12日,Meta发布首批前沿模型Muse Wonder与Muse Wonder Full,官方定位为公司迄今最强的模型产品,面向个人与专业智能体的长时程任务,覆盖保险理赔、合同解读、应用构建等场景,模型在位于俄亥俄州的Prometheus数据中心完成训练。第三方评测显示,在编码基准DeepSWE 1.1上,Muse Wonder Full以79.0%的成绩登顶;Artificial Analysis智能指数中,Muse Wonder Full以56分追平Claude Sonnet 5.5(max)、仅落后Claude Opus 5.5(max)2分。Meta首席执行官马克·扎克伯格同日向《金融时报》表示,Meta已经追平处于人工智能前沿的竞争对手,并拒绝行业放缓呼吁。
一、"西瓜"破土:Meta首款真正意义上的前沿模型
据《华尔街日报》报道,新模型内部代号"西瓜"(Watermelon),是扎克伯格重组AI业务、引入新人才执掌AI部门以来,Meta推出的性能最强模型。Meta首席AI官、Scale AI创始人亚历山大·王(Alexandr Wang)在发布当日接受采访时表示:"这些是真正的前沿模型。我们真的认为,它们足以与市面上最好的模型相竞争,尤其是在个人和专业智能体工作方面处于业界顶尖水平。"
行业观察人士指出,这是Meta超级智能实验室成立以来首次尝试开发前沿模型。与Meta此前在AI领域主推的开源策略不同,Muse Wonder将采取闭源模式,其最强版本将直接向企业销售。消息公布后,Meta股价一度上涨4.7%,截至上周五收盘,该股今年以来累计上涨近9%。
扎克伯格表示,随着新模型发布,Meta已经追上处于AI前沿的竞争对手,新系统将能够完成复杂得多的任务;他同时暗示Meta将进一步增加支出,公司已经在研究下一阶段的技术,模型开发有望大幅加快。
二、基准表现:智能指数追平Sonnet 5.5,编码基准登顶
第三方评测机构Artificial Analysis的智能指数显示,Claude Opus 5.5(max)以58分位居榜首,Muse Wonder Full(max)以56分追平Claude Sonnet 5.5(max)、领先GPT-6 Astra(53分),超过Gemini 4 Argon;Muse Wonder得分52分,与GPT-6.1 Sol持平。
【图表:Artificial Analysis 智能指数对比图】
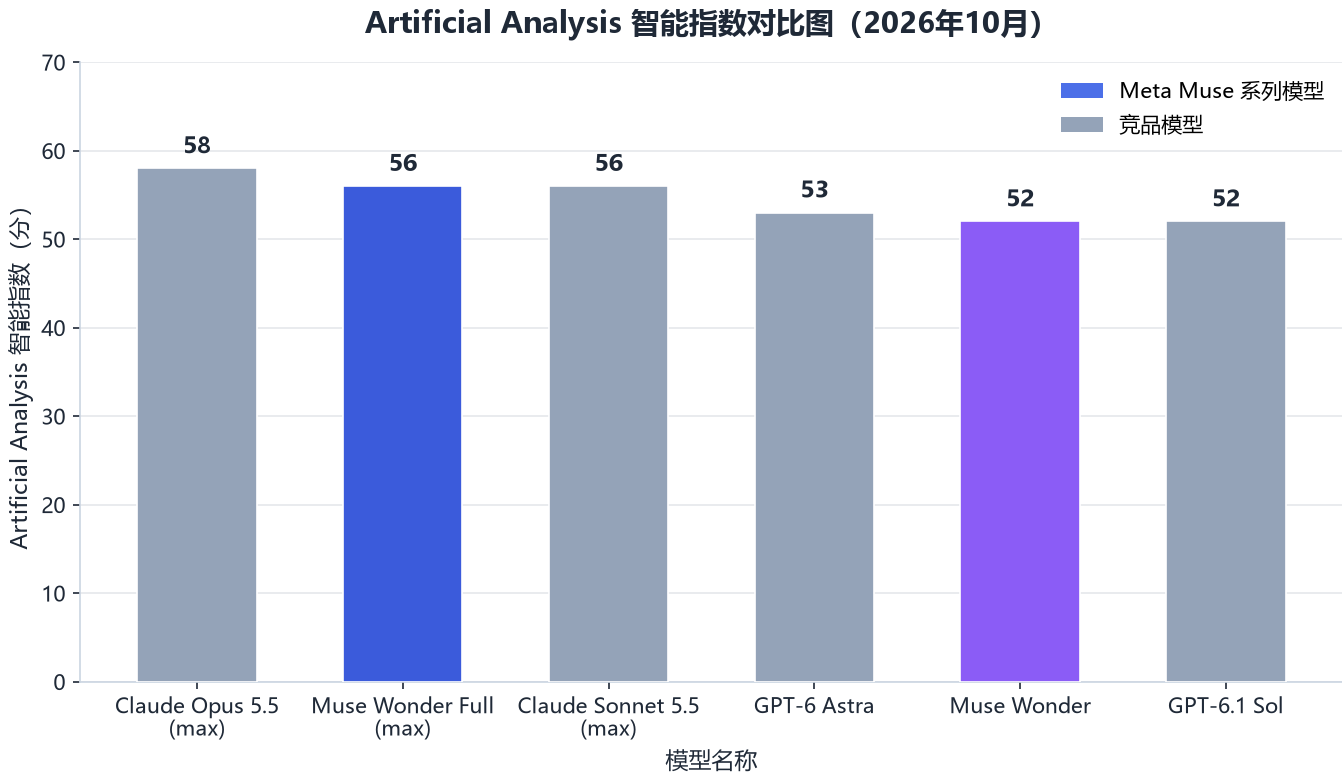
从智能指数看,Muse Wonder Full(max)以56分追平Claude Sonnet 5.5(max),与榜首Claude Opus 5.5(max)仅差2分,标志着Meta模型首次跻身一线阵营;Muse Wonder以52分与GPT-6.1 Sol持平,为不同成本预算的用户提供了梯队化选择。需要说明的是,Gemini 4 Argon的具体得分未在检索素材中披露,故未在图中呈现。
编码能力是本次发布的一大亮点。在编码基准DeepSWE 1.1上,Muse Wonder Full得分79.0%、Muse Wonder得分78.8%,均领先Claude Opus 5.5(74.2%)与GPT-6 Astra(74.1%)。值得注意的是,今年7月发布的Muse Spark 1.1在同一基准上的得分仅为53.3%,三个多月内提升超过25个百分点。在任务周期更长、需要模型持续修改和维护软件项目的SWE-Marathon测试中,Wonder Full的成功率达到57.5%,同样高于Claude Opus 5.5(46.3%)与GPT-6 Astra(42.5%)。
【图表:DeepSWE 1.1 编码基准对比图】
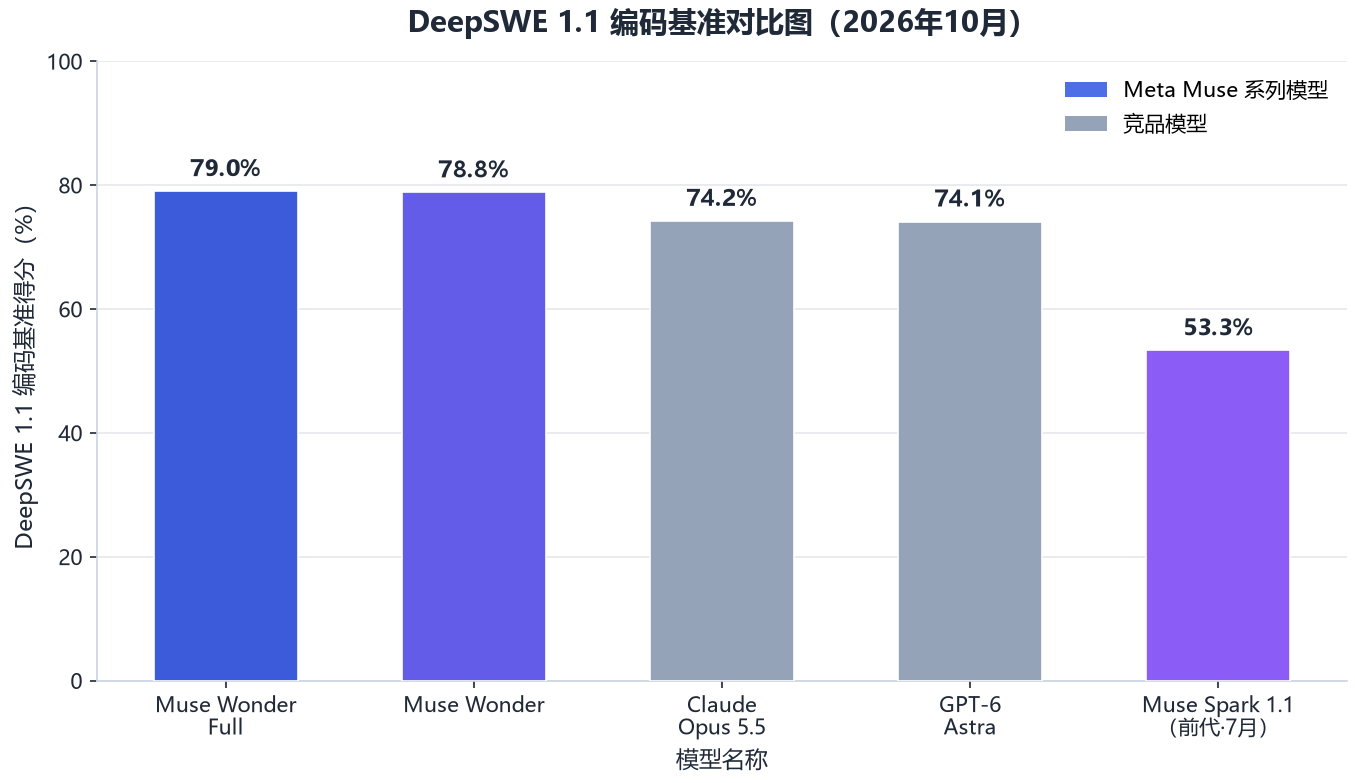
DeepSWE 1.1编码基准上,Muse Wonder Full与Muse Wonder分别以79.0%和78.8%包揽前两位,领先Claude Opus 5.5(74.2%)与GPT-6 Astra(74.1%);与今年7月Muse Spark 1.1的53.3%相比,Meta编码能力在三个多月内大幅跃升,印证了其针对编码短板集中投入后的成效。
此外,Meta强调新模型的"主动记忆"(active memory)特性。在考察模型能否从包含大量干扰和信息更新的长对话中准确找回关键内容的MemoryBench测试中,Muse Wonder以85.6%略微超过Wonder Full的85.5%,Claude Opus 5.5与GPT-6 Astra分别为81.5%和81.4%,第三方报道亦称其在MemoryBench上的得分高于Fable、Opus和Astra。亚历山大·王解释称,该模型经过专门训练,在执行现实世界任务遇到障碍时,能够"尝试其他方法,而不是停滞不前,然后随时再与用户确认"。
三、商业化:订阅与API双轨并行,寻找广告之外的第二曲线
Muse Wonder的商业化路径清晰。消费者侧,Muse个人代理应用的用户需注册每月20美元或100美元的订阅服务方可使用新模型;开发者侧,Muse Wonder即日起通过Meta Model API与Muse Code开放。更强大的Muse Wonder Full仅面向订阅Muse Code(Meta旗下专注于软件工程的AI编程代理)的开发者提供,订阅计划为每月50美元或200美元。
API定价方面,不同渠道口径存在差异:科技媒体Mad Robot报道称,Muse Wonder的API定价与Claude Opus 5.5相同,即每百万token输入4美元、输出20美元;而据《华尔街日报》报道,亚历山大·王表示API服务价格将高于面向普通消费者的标准订阅,但Meta计划将其定价维持在明显低于OpenAI和Anthropic领先模型的水平。两者口径的差异可能与对比基准不同有关,具体以Meta官方公布为准。
财经媒体报道指出,此次发布凸显了Meta在核心在线广告业务之外创造新的AI衍生收入来源的努力。
四、模型家族演进:从Muse Spark到Muse Wonder的能力跃迁
Muse Wonder并非凭空出现。回顾Meta模型家族的演进路径:今年4月9日,Meta发布首款自研高性能AI模型Muse Spark,由亚历山大·王领衔研发,并集成至Meta AI服务中。彼时独立评测机构Vals AI曾指出,"该模型在编码方面仍然表现不佳",预计这将是Meta未来加倍投入的领域。
7月9日,Meta推出首个向开发者收费的模型Muse Spark 1.1,配备100万token上下文视窗,API定价为每百万token输入1.25美元、输出4.25美元,在DeepSWE 1.1榜单获得53.3%的成绩。9月8日,Meta发布C端个人AI智能体Muse,底层由旗舰模型Muse Spark 1.3驱动,运行于配备浏览器的独立虚拟机Muse Secure VM,可跨应用执行发送邮件、预订旅行、在线购物等全流程任务。Muse上线后迅速升至美国App Store免费榜第二名,仅次于ChatGPT,三周内下载量突破500万次并登顶免费榜、连续12天保持榜首位置。
不过,截至10月中旬,Muse全球下载量接近900万次的同时,市场研究机构Sensor Tower的数据显示其下载量增长已开始放缓,发布14天后的用户留存率低于ChatGPT。Muse Wonder能在多大程度上提高Muse的用户留存率、加快产品普及速度,被视为其面临的重要考验。
差异化打法方面,亚历山大·王表示:"其他公司一直非常专注于擅长编程的智能体。而我们采取了差异化的重点方向,努力把个人智能体这一应用场景真正做好。"过去14个月,扎克伯格重新调整公司AI战略,承诺投入数千亿美元建设AI基础设施,并通过向Scale AI投资140亿美元将亚历山大·王纳入麾下。
五、安全与信任:能力开放之后的必答题
伴随模型能力开放,安全与用户信任问题同样受到关注。Meta在官方博客中表示,Muse Wonder配备了"至今为止最强大的防护机制",以降低模型被用于恶意网络活动的风险,但目前这些安全保护措施仅随付费模型提供。
此前,部分用户在社交媒体上投诉称,Muse智能体未经授权访问了个人消息,Meta对此予以否认。亚历山大·王回应称,某些情况下用户可能在对话早期授权AI访问特定通信内容、随后忘记授权,Meta正在加强用户教育,帮助消费者更清楚地了解应用的操作方式及授权机制,以建立用户信任。
在AI安全治理上,扎克伯格表示,相关安全责任应由各个实验室自行承担;相比将AI拟人化、认为它会自行其是的观点,他更倾向于相信AI是一项可以通过常规防护措施进行工程设计并以负责任方式开发的技术。
结语
从4月的Muse Spark到10月的Muse Wonder系列,Meta用半年时间完成了从"追赶者"到"前沿玩家"的身份切换,行业竞争焦点也进一步从训练端向应用端扩散。凭借"个人智能体+专业智能体"的差异化定位与梯次化的订阅、API定价体系,Meta试图在OpenAI与Anthropic主导的前沿竞争中开辟自己的赛道。不过,基准跑分上的领先最终能否转化为Muse的用户留存与真金白银的商业化收入,将决定这场"翻身仗"的成色。