智能体AI的爆发,正在让沿用多年的CPU性能评估体系失效。
在智能体AI出现之前,AI领域的性能衡量高度依赖Token生成指标——每秒Token数、每瓦Token数和每美元Token数。但智能体AI改变了这一逻辑:一个智能体完成任务,不是简单的一次模型调用,而是反复的模型推理、上下文检索、工具调用、状态管理和验证循环串联而成的工作流。衡量标准不再只是每秒生成多少Token,而是这些Token能否转化为真实世界中完成的任务。
这正是Arm近期发布CPU评估方法论的背景。这套方法论获得富士通、Meta和OpenAI的支持,并经由独立技术分析机构Signal65验证了Arm AGI CPU的实测表现。10月22日,Arm举办“智能体AI重新定义CPU性能评估标准”线上媒体说明会,Arm云AI解决方案架构总监Ravi Malhotra围绕智能体AI时代CPU性能评估方法的变革、Arm AGI CPU的实测表现以及评测方法论等话题,与媒体进行了深入交流。
智能体带来的评估之变
当前,智能体AI的规模化速度惊人。根据美国知名风险投资机构a16z援引的OpenRouter数据,自2026年2月以来,智能体的Token使用量增长约14倍。从基础设施的角度来看,AI智能体就像拥有持久计算环境的虚拟用户,能够持久保持状态、检索上下文、调用工具和服务、执行任务,并持续评估执行结果,直至任务完成。
Ravi Malhotra介绍,当前行业中涌现出五类热门智能体AI用例:软件工程、企业自动化、科学研究(如金融分析)、个人助理和机器人技术。这些用例对CPU的要求各不相同——软件开发中编译和测试代码等动作耗时较长、消耗大量CPU周期,单个智能体的性能就显得非常重要;而个人助理或企业运营中的单次操作往往持续时间较短,但由于操作数量庞大,反而对吞吐量和运行效率提出更高要求。
从基础设施的角度看,智能体任务可以分为两部分。第一部分是Token生成,即推理与规划,这类工作通常运行在AI机架上,重点是大规模生成Token,并为智能体所需的上下文和数据解读提供足够的内存与存储空间。第二部分是基于这些Token采取行动,即工具调用与编排,通常运行在纯CPU服务器上。因此,什么样的CPU能更好地承载智能体工作负载,成为数据中心新的核心命题。
“持续性能” 才是关键
针对智能体AI的CPU性能评估,Arm近期发布了一份白皮书,提出了一套新的评估方法论,并获得富士通、Meta和OpenAI的支持。
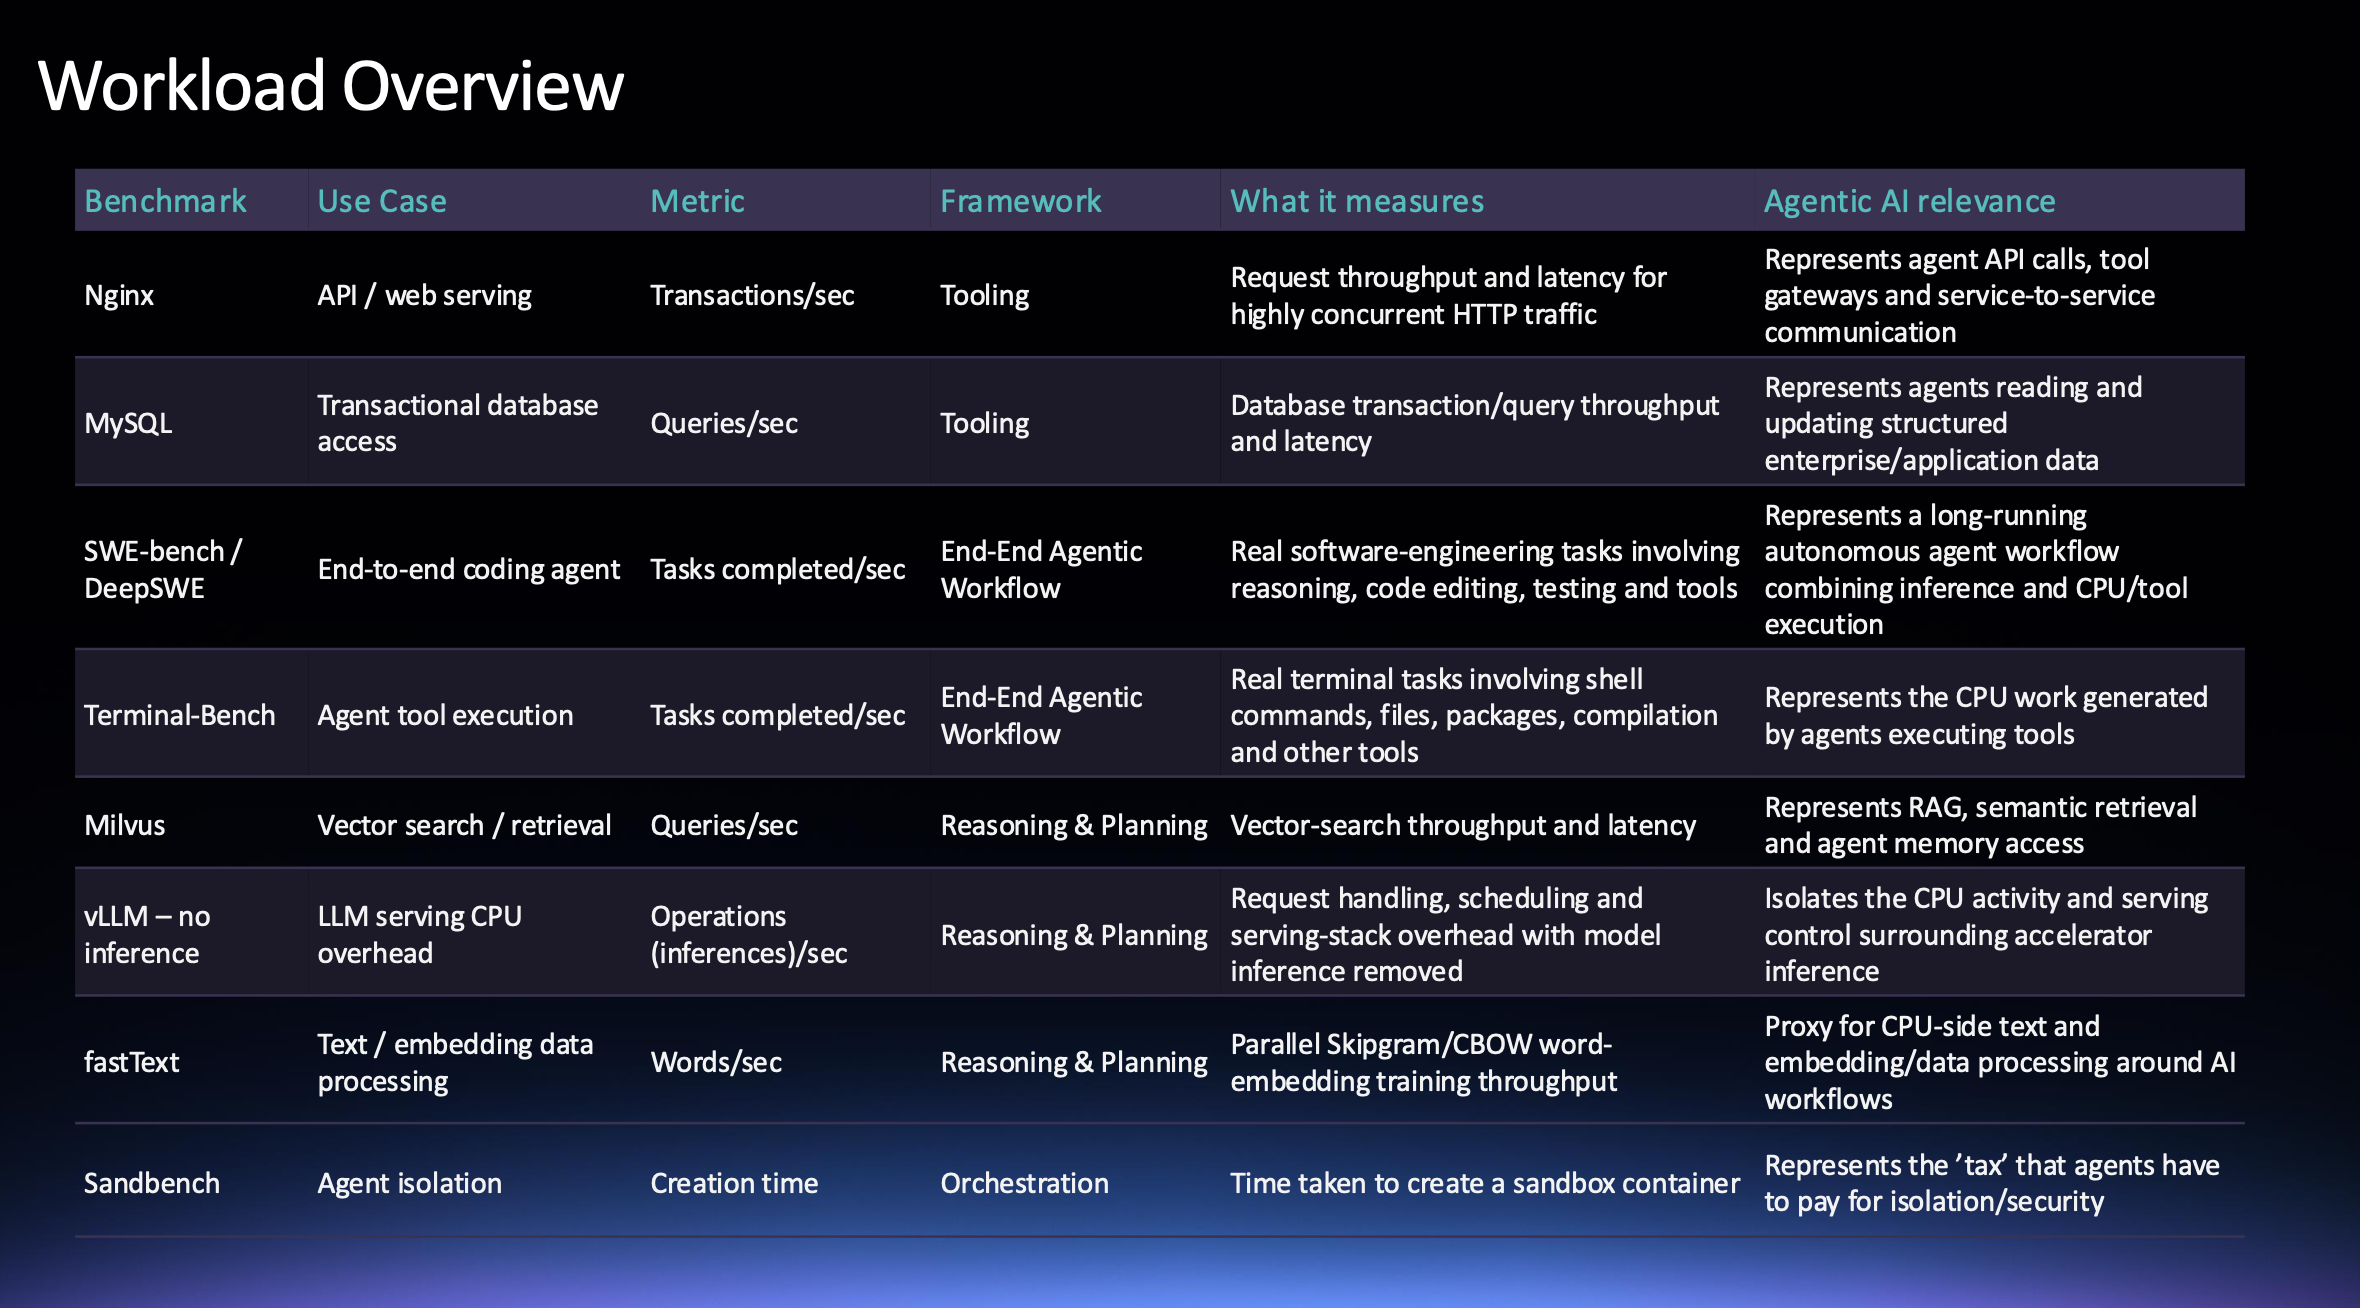
这套方法论主要包括两个部分。首先是组件级基准测试。测试Web服务器、数据库或模型服务的开销,可以精确了解单个组件的表现,但它无法反映这些组件在智能体工作流中是如何连接并协同运行的。组件级基准对CPU的考察各有侧重:工具调用类组件侧重于IPC(每周期指令数)、I/O和并发;编排环节更强调CPU并发和利用率;推理与规划中CPU充当头节点,重点测试单线程性能,包括分支预测、缓存、内存延迟和内存带宽。
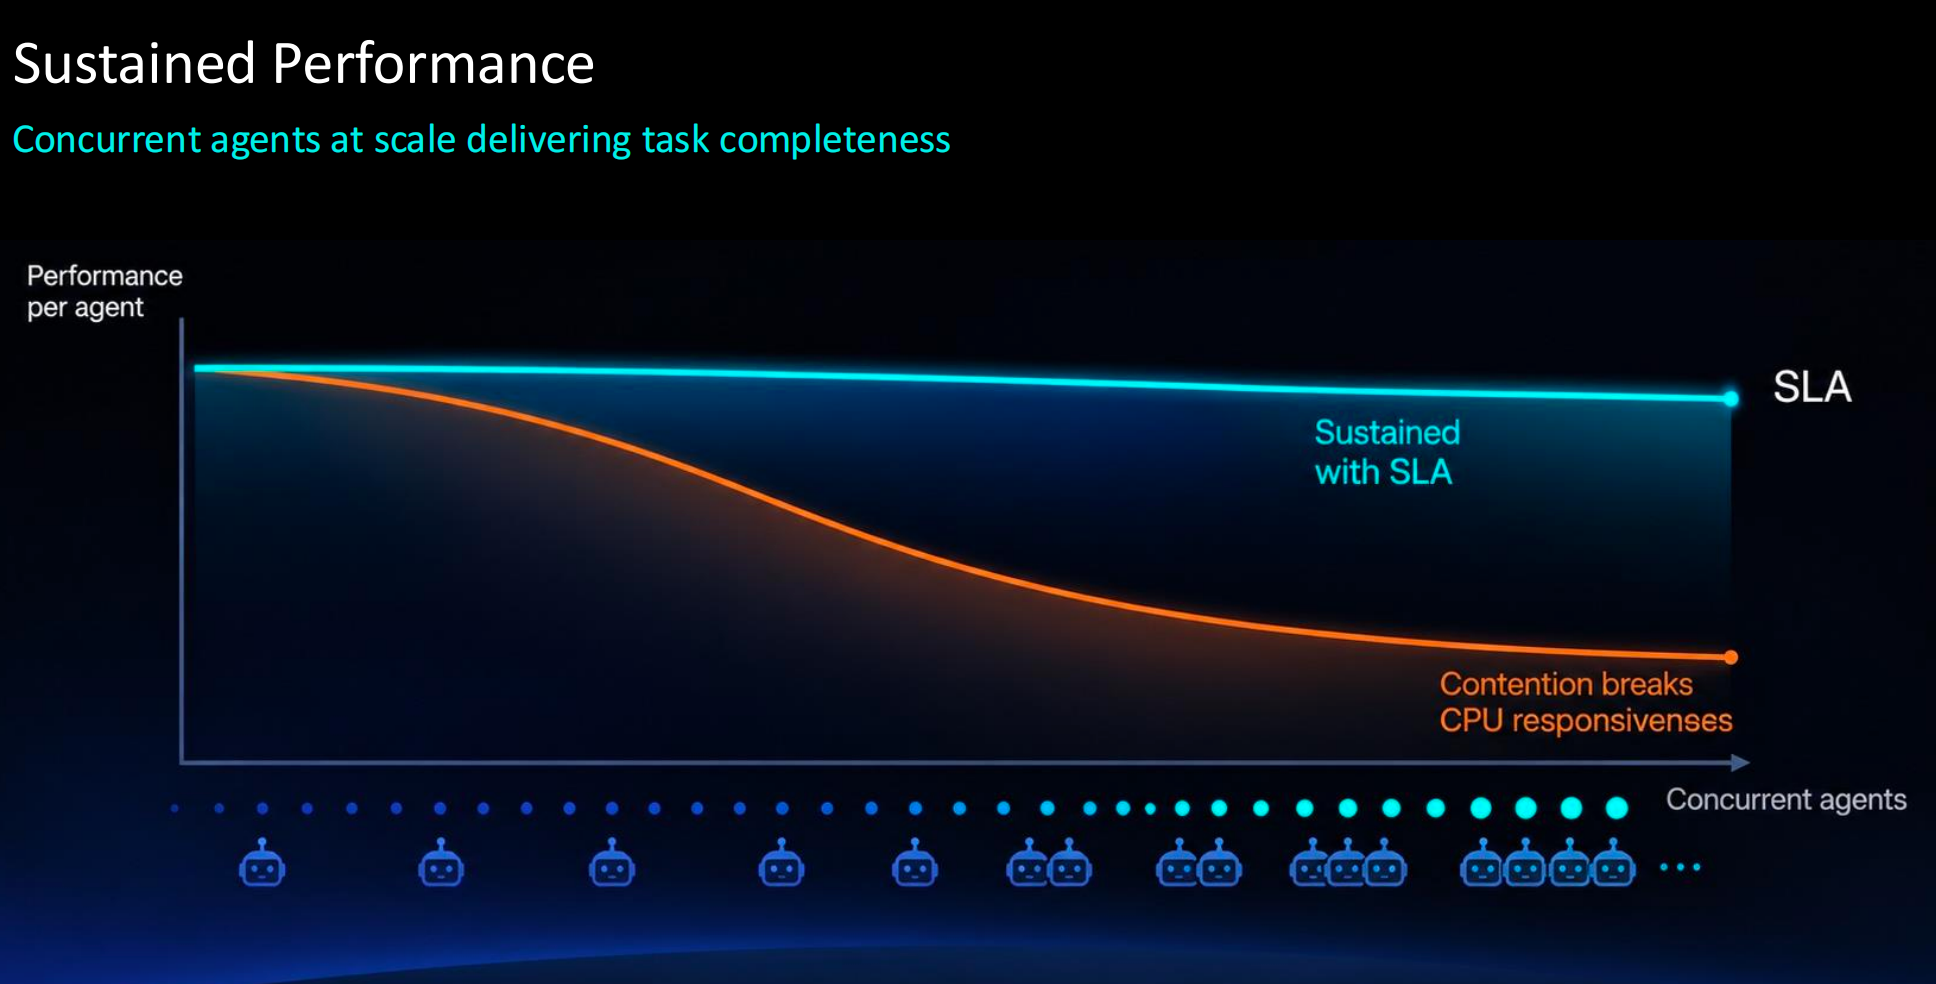
其次是端到端智能体基准测试,这部分更关注可扩展性和并发性。性能评估不能只看单颗CPU能够承载多少智能体,也不能单纯追求最高吞吐量,还需要在吞吐量与SLA(服务等级协议)要求之间取得平衡——这正是Arm强调的“持续性能”概念:如果吞吐量随着系统资源利用率上升而下降,那么拥有更多的理论算力并不意味着能够完成更多任务。
Ravi Malhotra强调,这套方法论是Arm提出的评测思路,而非正式的行业标准或单一基准测试,旨在为业界提供一个切实可行的起点。他建议客户和应用开发者不要只关注单一分数,而应综合考察各个组件的表现,并判断这些结果是否与自身用例相关。
而机架,正是这种“持续性能”的最终检验单位。数据中心始终受到功耗、散热和物理空间的固定限制,当更多智能体和任务并发运行时,基础设施运营商最终需要知道的,是系统在这些限制内能够持续完成多少有效工作。因此,可扩展性与持续性能的评估,最终都要落到机架层面来验证。
机架级视角:性能超X86两倍
为什么评估智能体算力要按整个机架来看,而不是单看单芯片性能?Ravi Malhotra解释,客户在数据中心里部署和使用的是整个机架,而不仅仅是单颗CPU。如果只把一颗CPU与另一颗CPU对比,就无法衡量其他因素的优劣,包括CPU的能效、内存利用效率、服务器成本和功耗,以及单个机架能够容纳多少台服务器或多少颗CPU。
在Ravi Malhotra看来,AGI CPU的优势不在于打造规格最高的CPU,而在于兼顾核心层面的性能、服务器层面的可扩展性和机架层面的效率。由于每个核心的功耗更低,在相同的机架功耗预算下可以部署更多核心,将每核及每颗CPU的性能与每机架更多的核心数量结合起来,就带来了显著的机架级性能优势。
Signal65在与Arm合作开展的测试中发布了独立验证报告,对比了Arm AGI CPU与第五代AMD EPYC处理器(代号“Turin”)在智能体工作负载上的表现。两个平台均采用相同的基准测试脚本,并基于实测的服务器级性能数据构建机架级性能模型。
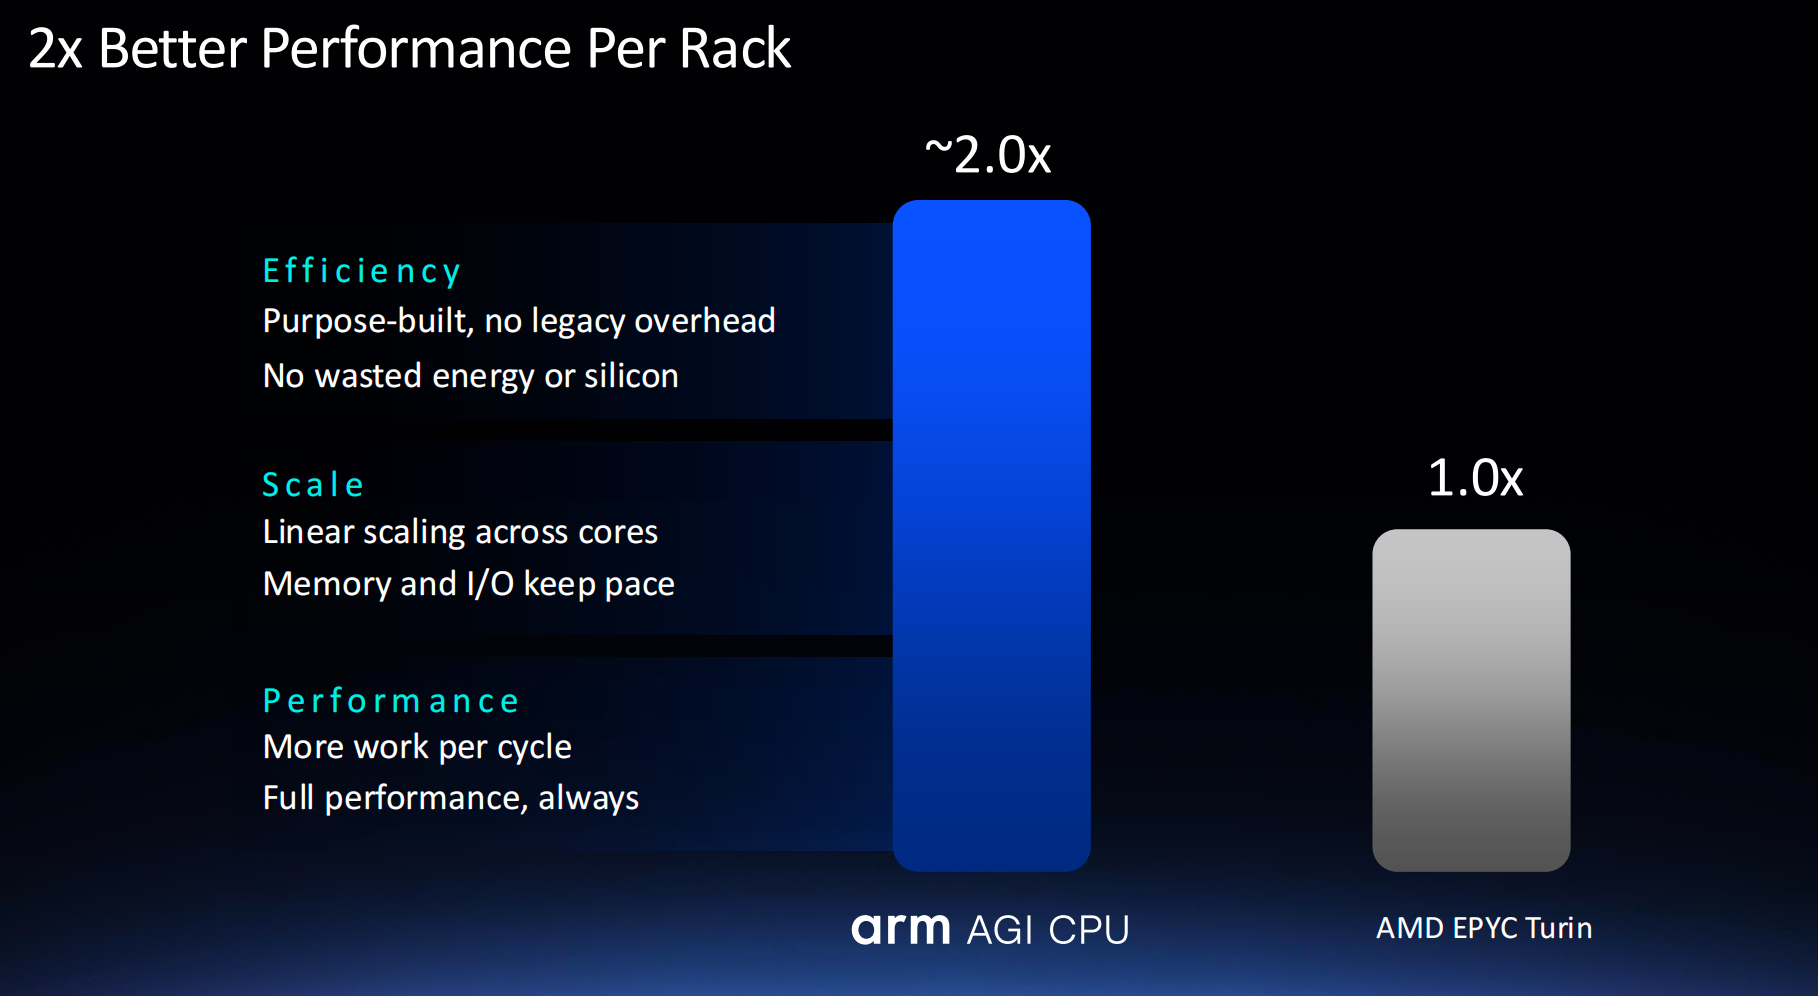
报告显示,对于所评估的智能体工作负载,在相同功耗预算下,Arm AGI CPU的每机架性能约为AMD EPYC 9755的1.99倍。分项来看:工具调用场景平均达到对比平台的1.7倍;推理与规划类应用(向量数据库、缓存等)达到2.2倍;端到端智能体基准结果为2倍。平均而言,Arm AGI CPU在每核及CPU SoC层面的性能都约高出对比平台20%。
测试工作负载的选择也颇具代表性:工具调用选取了NGINX和MySQL,推理与规划选取了向量数据库Milvus、模型服务框架vLLM和数据处理基准fastText,编排环节测量了沙箱执行开销(Docker、Firecracker、gVisor等多种沙箱技术),端到端智能体基准则选用了软件开发类的SWE-bench和Terminal-Bench。其中fastText场景的差距最为悬殊,Arm AGI CPU的每机架性能达到对比平台的3.19倍。
结语
在Ravi Malhotra看来,智能体AI时代CPU的关键任务可以分为三类:把已生成的Token转化为行动;Token生成环节中把数据存放在KV Cache和向量数据库中并尽快传输到加速器;以及编排与沙箱隔离——把Token生成与行动连接起来,构建完整的端到端流程。
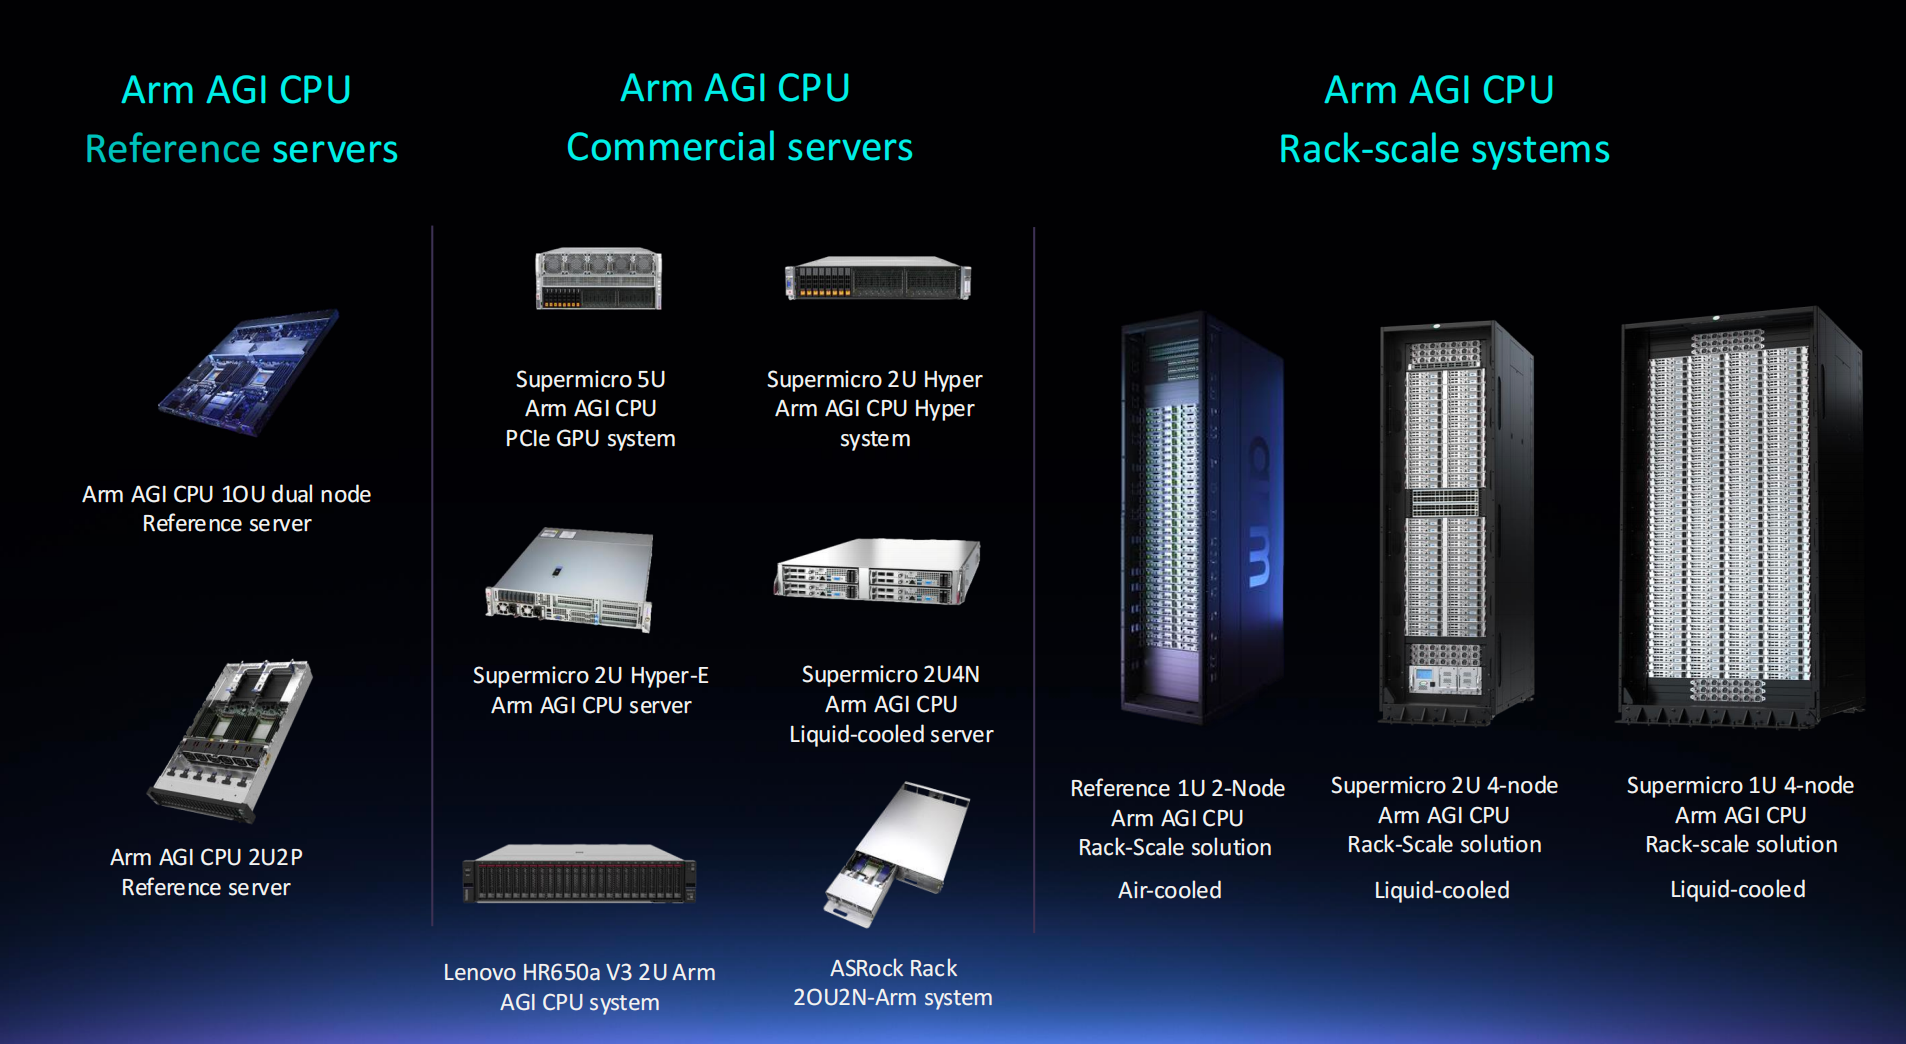
Arm正以不同的产品形态将AGI CPU推向市场。Arm设计了两款服务器参考设计——1OU双节点服务器参考设计和2U2P服务器参考设计,并已推进向开放计算全球峰会(OCP)贡献AGI CPU服务器参考设计,Meta的Yosemite YV5则将AGI CPU引入OCP机架级设计。合作伙伴方面,超微电脑(Supermicro)、联想和华擎科技提供一系列量产平台和商用服务器。以Supermicro 5U平台为例,其面向AI服务器场景,AGI CPU作为头节点与客户选用的加速器协同工作。机架层面,Arm同样提供风冷和液冷多种解决方案,涵盖19英寸和Open Rack双宽两种规格。
谈及评测方法论的未来演进,Ravi Malhotra表示,智能体基准测试的发展非常迅速,几乎每周或每隔一周都会出现一个新的基准。Arm持续关注并运行多种智能体基准测试,这项工作绝不会止步,Arm将继续走在行业前沿,就不同的用例和基础设施的各个方面分享更多见解。
在智能体AI时代,CPU重新回到舞台中央。当评估的单位从“模型调用”变为“完成任务”,当数据中心关注的焦点从单芯片峰值性能转向机架级持续吞吐,Arm用一套新的评估方法论和一份独立验证的实测报告,给出了自己的回答——也为整个行业如何衡量智能体时代的CPU性能,提供了一个可供讨论的起点。