Vera Rubin NVL72 与 Vera CPU 在甲骨文云全面商用,HGX Rubin NVL8 规划推出,OpenAI 生产负载先行背书。
当地时间10月27日,在拉斯维加斯举行的 Oracle AI World 大会上,英伟达与甲骨文宣布将 OCI(Oracle Cloud Infrastructure)超级集群扩展至多吉瓦(multi-gigawatt)级规模:NVIDIA Vera Rubin NVL72 系统与 Vera CPU 即日起在甲骨文云全面商用(GA),OCI 同时计划推出搭载8颗 Rubin GPU、兼容 x86 服务器生态的 HGX Rubin NVL8 系统,以支撑前沿模型训练、提升推理效率并扩展智能体工作负载。官方口径同时确认,OpenAI 已在 OCI 超级集群上以超过10万颗 Blackwell GPU 训练并服务 GPT-6 Astra,为本轮扩容提供了生产级背书。在 AI 基础设施资本开支高企、内存供应趋紧的产业背景下,多吉瓦级扩容既是算力需求的注脚,也是云厂商重构供应链话语权的重要信号。
一、事件:从 GB300 到 Vera Rubin,OCI 迈向多吉瓦
据英伟达与甲骨文双方官方公告,本次合作包含三层内容:其一,Vera Rubin NVL72 机架级系统与 NVIDIA Vera CPU 在 OCI 正式全面商用;其二,双方计划将 OCI 超级集群中的 Vera Rubin 部署规模扩展至多吉瓦级,以响应 AI 训练、推理与智能体应用持续增长的客户需求;其三,OCI 计划引入 HGX Rubin NVL8 系统,将下一代 Rubin GPU 以八卡配置带入 x86 服务器生态。双方未披露本次扩容涉及的合同金额与具体部署时间表。
从系统构成看,OCI 超级集群由 NVL72 机架级系统、Oracle Acceleron 网络与 NVIDIA Spectrum-X 以太网(Spectrum-6 交换机与 BlueField-4 DPU)以及吉瓦级供电与液冷设施组合而成。单个机架通过 NVLink 纵向扩展网络连接72颗 GPU,OCI 的多平面网络则可横向扩展至数十万颗 GPU。本轮 Vera Rubin 扩展建立在 OCI 既有的 GB200 与 GB300 NVL72 基础设施之上,并依托英伟达统一的 CUDA 软件栈保持跨代兼容。甲骨文配套技术稿称,吉瓦级园区在两公里半径内进行密度优化,供电与液冷按跨机架系统工程化设计,算力容量可在前沿训练与生产推理之间灵活调度。
性能层面,甲骨文披露 Vera Rubin 相比上一代 Blackwell 平台,每瓦推理吞吐最高提升30倍,训练性能提升4倍。英伟达 CEO 黄仁勋此前公开表示,每吉瓦的 Vera Rubin 系统最多可为英伟达带来400亿美元收入——以此口径衡量,多吉瓦级部署对应的收入空间已达百亿美元量级,这也是双方均以吉瓦而非台数作为计量单位的原因。
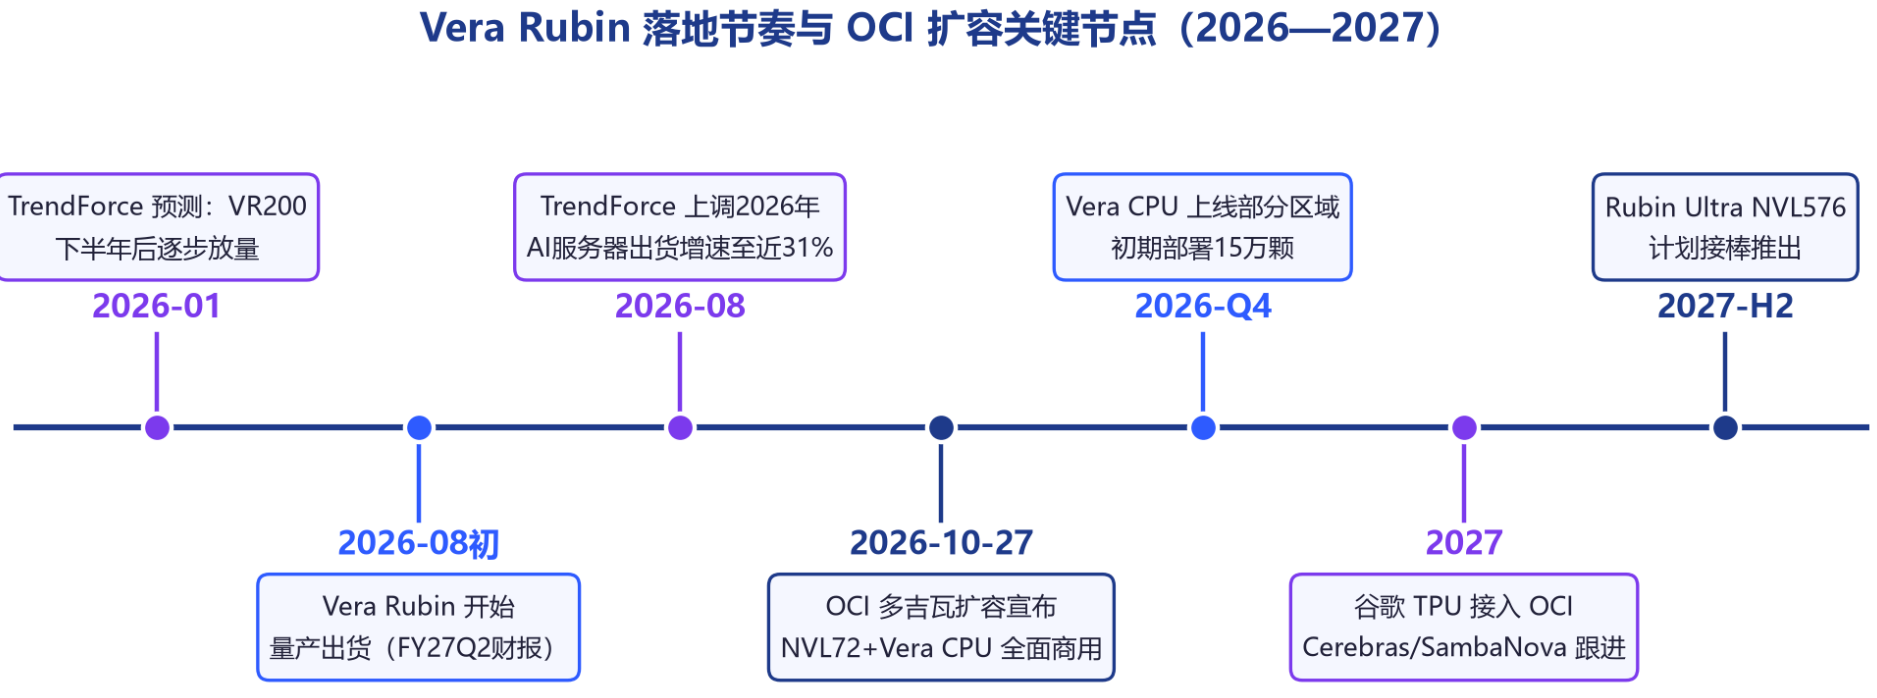
图1:Vera Rubin 平台落地节奏与 OCI 扩容关键节点(2026—2027)
二、平台拆解:整柜、CPU 与 x86 兼容的三层布局
本次发布的平台组合覆盖三种部署形态。整柜侧,Vera Rubin NVL72 延续机架级路线,通过 NVLink 将72颗 Rubin GPU 组成单一纵向扩展域。值得注意的是,Rubin 架构单芯片功耗已突破2000瓦,Vera Rubin NVL72 单机柜功率超过220千瓦,成为英伟达首个100%全液冷散热的系统——这一指标已在产业链公司年报中被多次引用,折射出散热与供电正在取代算力本身成为系统设计的首要约束。
CPU 侧,Vera CPU 是英伟达面向智能体(Agentic AI)工作负载的关键落子。每颗 Vera 处理器集成88个定制的 Arm 兼容 NVIDIA Olympus 核心,借助 Spatial Multithreading 提供176线程,内存带宽最高达1.2TB/s,第二代 NVIDIA Scalable Coherency Fabric 提供分割带宽3.4TB/s。甲骨文宣布成为首家将 Vera CPU 商用落地的超大规模云厂商:初期部署15万颗,通过裸金属与 Flex 虚拟机实例提供,2026年第四季度登陆部分区域;双路实例合计提供176核、352线程,配置1TB LPDDR5X 内存、7.68TB 本地 NVMe 存储与200Gbps Acceleron 网络。英伟达口径称,Vera CPU 在智能体负载上较领先的 x86 CPU 最高快80%,但甲骨文亦明确注明该数据来自 NVIDIA 平台基准测试而非 OCI 实例级实测,实际表现因负载与配置而异。
这一布局的逻辑在于:智能体并非只靠 GPU。智能体在模型调用之间需要执行工具调用、运行代码、检索数据等 CPU 密集型操作,这些环节执行缓慢会导致 GPU 在两次模型调用之间空转等待。Vera CPU 以高单线程性能加速单次工具调用与代码执行,以高内存带宽支撑多任务并发;配合 OCI Kubernetes Engine 实现 CPU 与 GPU 资源独立扩缩,客户可按负载匹配资源、降低闲置容量,而 Oracle Acceleron 为运行不可信的 AI 生成代码提供基于硬件的隔离。
x86 兼容侧,HGX Rubin NVL8 以八颗 Rubin GPU 经 NVLink 互连,置于标准 x86 服务器配置中:平台搭载两颗64核 Intel Xeon 6 处理器、4TB DDR5 内存与6.4Tbps 高速 RDMA 网络。它为不愿直接跃迁到整柜级方案的客户提供了小规模采用下一代 Rubin GPU 的选项,同时保持与既有 x86 应用的兼容性,覆盖训练、微调与推理等场景。
网络是本次扩容的另一关键变量。据甲骨文技术稿,Acceleron 构建于102.4Tb/s 的 Spectrum-X 以太网交换机之上,配合 ConnectX-9 超级网卡与 BlueField-4 DPU;其 Multipath Reliable Connection 协议将单一连接的数据包分散到八平面架构的数百条路径,结合多平面组网与 SRv6 源路由,两层网络即可支持超过13.1万颗 GPU。这一数字既界定了 OCI 单一集群的规模上限,也预示多吉瓦扩容的网络工程余量。
表1:Vera Rubin 平台三层产品布局关键规格
产品形态 | 定位 | 关键规格(官方口径) |
Vera Rubin NVL72 | 机架级训练/推理主力 | 72颗 Rubin GPU 经 NVLink 互连;每瓦推理吞吐较 Blackwell 最高30倍,训练性能4倍;单机柜功率超220kW,100%全液冷 |
OCI Compute with Vera CPU | 智能体 CPU 密集负载 | 88核 Arm 兼容 Olympus 核心/176线程;内存带宽最高1.2TB/s,SCF 分割带宽3.4TB/s;OCI 初期部署15万颗,2026年Q4上线部分区域 |
HGX Rubin NVL8(规划) | x86 兼容八卡部署 | 8颗 Rubin GPU 经 NVLink 互连;2颗64核 Intel Xeon 6、4TB DDR5、6.4Tbps RDMA,兼容 x86 应用生态 |
三、OpenAI 背书:十万卡集群上的生产级验证
多吉瓦扩容并非单纯的前瞻规划,而是已有生产负载先行验证。官方公告明确:OpenAI 已在位于得克萨斯州阿比林(Abilene)的 OCI 超级集群上,使用超过10万颗 NVIDIA Blackwell GPU 完成了 GPT-6 Astra 的训练与服务。这一表述从两家公司官方渠道同步发出,等于以最大客户的身份为 OCI 的集群工程能力做了背书。
OpenAI 计算基础设施工程负责人 Sreekanth Pothanis 表示,随着前沿模型持续演进,需要能够同步跟上的基础设施,NVIDIA Vera Rubin 在 OCI 上提供的计算性能与规模,可以加速模型训练并服务要求日益苛刻的 AI 工作负载。OpenAI 计算首席技术官 Uday Ruddarraju 则披露,公司作为 Vera CPU 的早期客户,正在 agentic sandbox 智能体沙箱负载上探索其潜力,认为 Vera CPU 提供了执行代码与运行工具所需的一流负载性能。
从产业视角看,阿比林集群正是 OpenAI 星际之门(Stargate)计划的旗舰站点。生产级负载先于扩容公告确认,说明多吉瓦规划有真实需求牵引,而非单纯的供应商叙事;反过来,OpenAI 训练与推理负载在 OCI 上的稳定运行,也成为甲骨文在超大规模云算力竞争中份额上升的最直接证据。
四、商业纵深:950亿美元资本开支与供应链锁定
在合作扩容的同时,两家公司的商业基本盘决定了这一规划的可持续性。甲骨文方面,据 Reuters 报道,公司在本次公告中维持了2027财年约900亿至950亿美元的资本支出目标;上月的财报电话会上管理层还表示,客户正越来越多地自行承担芯片费用。本周四(10月29日)甲骨文将举行投资者日,多吉瓦扩容的融资安排届时或有进一步披露。
更值得关注的细节是甲骨文的多元化操作:其一,甲骨文将首次向客户提供谷歌张量处理单元(TPU),并计划引入 Cerebras Systems 与英特尔参投的 SambaNova Systems 等推理芯片厂商的产品,谷歌 TPU 预计2027年起通过 OCI 提供;其二,即便是搭载英伟达芯片的系统,部分网络设备也将改用甲骨文自研 Acceleron 网络芯片。甲骨文云基础设施总裁 Mahesh Thiagarajan 对此解释称,不同的 AI 工作负载有不同的计算需求,提供选择让客户能够按性能、吞吐量与经济性选择基础设施。Cerebras CEO Andrew Feldman 则向 Reuters 表示,这意味着公司 tier-one 客户群的大规模扩张。训练市场英伟达占据主导,而推理市场竞争更多元,云厂商借推理负载引入多元算力、并借自研网络回收利润空间,正在成为行业通行打法。
英伟达方面的财报数据则勾勒出另一侧的供给压力。2026年8月26日发布的2027财年第二财季报告显示,公司单季营收962.21亿美元,同比增长106%;数据中心业务收入890亿美元,同比增长117%,占总营收92.5%;当季毛利率75.0%。Vera Rubin 已于2026年8月初开始量产出货,Blackwell Ultra 仍是当季出货主力,下一季度 Vera Rubin 接棒放量;公司给出第三财季营收指引1080亿美元,并前瞻2028财年营收增长约70%。
但比营收更值得注意的是供应链锁定:截至第二财季末,英伟达的供应及产能承诺由上一季度的1190亿美元翻倍增至2790亿美元,增量主要与内存采购有关,公司本季还与 SK 海力士签署了多年技术合作协议。与承诺翻倍相伴的是毛利率指引的下行路径——第三财季降至约74%,第四财季触底至71%—72%,2028财年随提价落地回升至72%—73%。英伟达管理层直言内存处于极端定价环境,涨价幅度超出预期且可能持续至2027年。换言之,多吉瓦级部署的另一半故事,是用巨额预付款换来的内存与产能确定性。
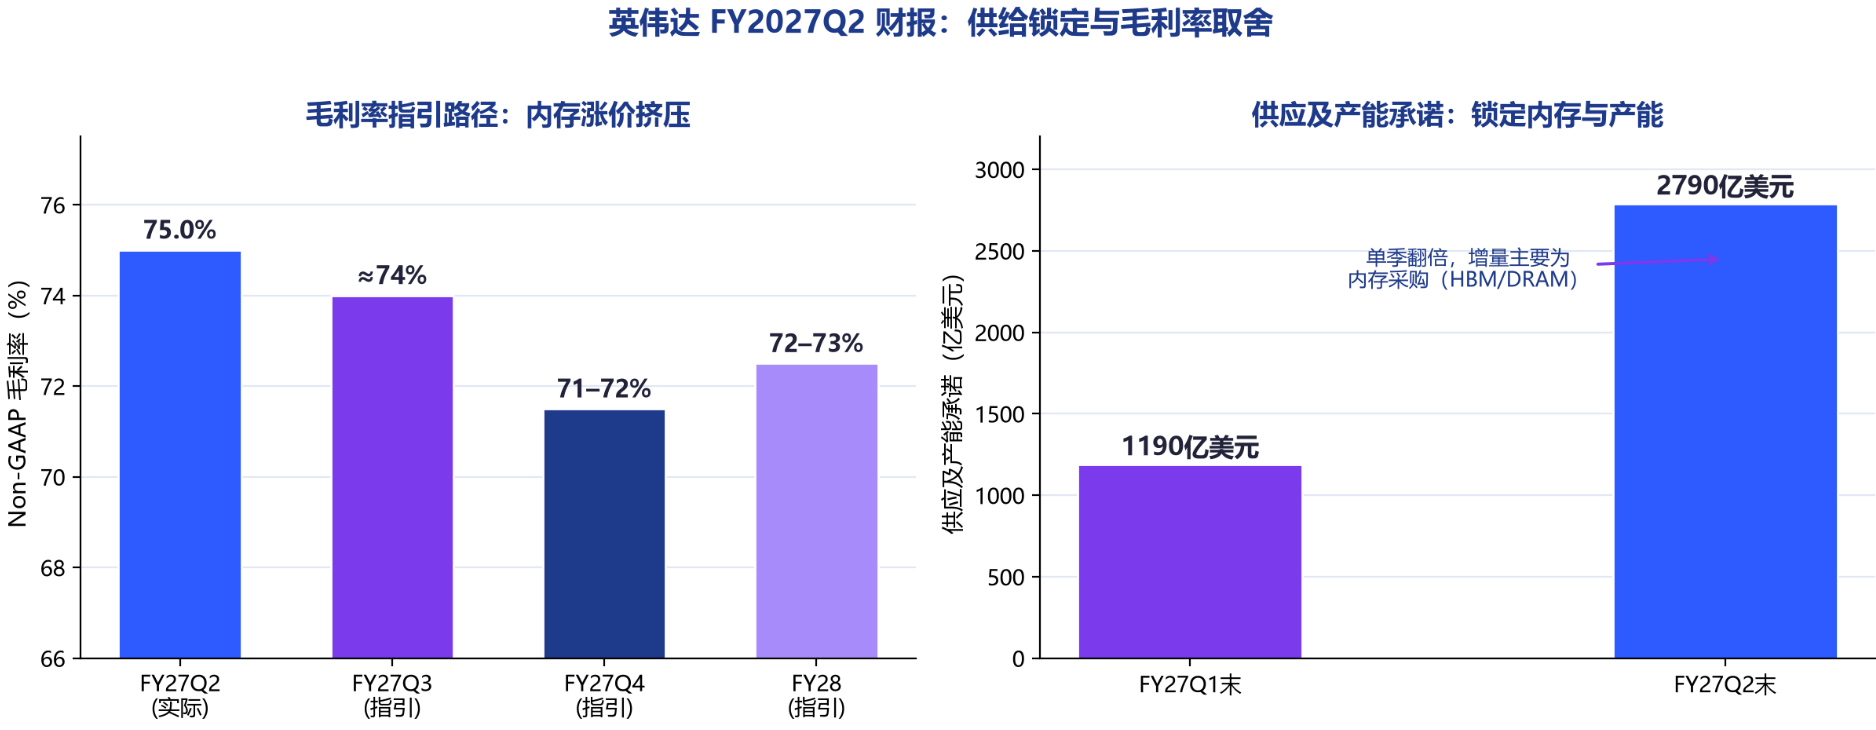
图2:英伟达毛利率指引路径与供应承诺翻倍(FY2027Q2—FY2028)
五、行业坐标:机构数据下的算力竞赛
把本次合作放进行业坐标系,第三方机构数据提供了量化标尺。TrendForce 集邦咨询2026年8月发布的报告显示,2026年全球九大云端服务供应商(谷歌、亚马逊、Meta、微软、甲骨文及字节跳动、腾讯、阿里巴巴、百度)总资本支出预估将同比增长约90%、突破8867亿美元;其中北美五大厂商合计占比近九成,甲骨文位列其中。该机构据此将2026年全球 AI 服务器出货量年增速从28%上调至近31%,并预估2027年九大 CSP 总资本支出将扩大至约1.3万亿美元、年增近50%。
芯片结构上,TrendForce 预估2026年 AI 服务器所搭载的 AI 芯片中 GPU 仍占69.7%、为最大宗,其中搭载英伟达 GB300 的机种成为出货主流,VR200 于下半年后逐步放量;与此同时,ASIC 类 AI 服务器出货占比将逼近28%的近年高点,谷歌、AWS、Meta 等厂商的自研芯片在2026至2027年陆续放量。这一结构为甲骨文同时引入 TPU、Cerebras 与 SambaNova 提供了需求注脚:推理负载的多样性正在把云厂商的芯片采购从单一供给推向组合配置。
总盘子方面,Gartner 此前预测2026年全球 AI 支出将达2.7万亿美元、同比增长49.5%,其中 AI 基础设施支出接近1.5万亿美元、约占总支出的56%;其亦预计2026年全球数据中心系统支出将超过7880亿美元。在国内市场,IDC 数据显示2025年上半年中国加速服务器市场规模达160亿美元、同比增长220%,并预计到2028年国内 AI 服务器工作负载中推理占比将从2024年的65%升至73%。推理主导的时代,与 Vera CPU、HGX NVL8 以及多元推理芯片的布局方向高度一致。
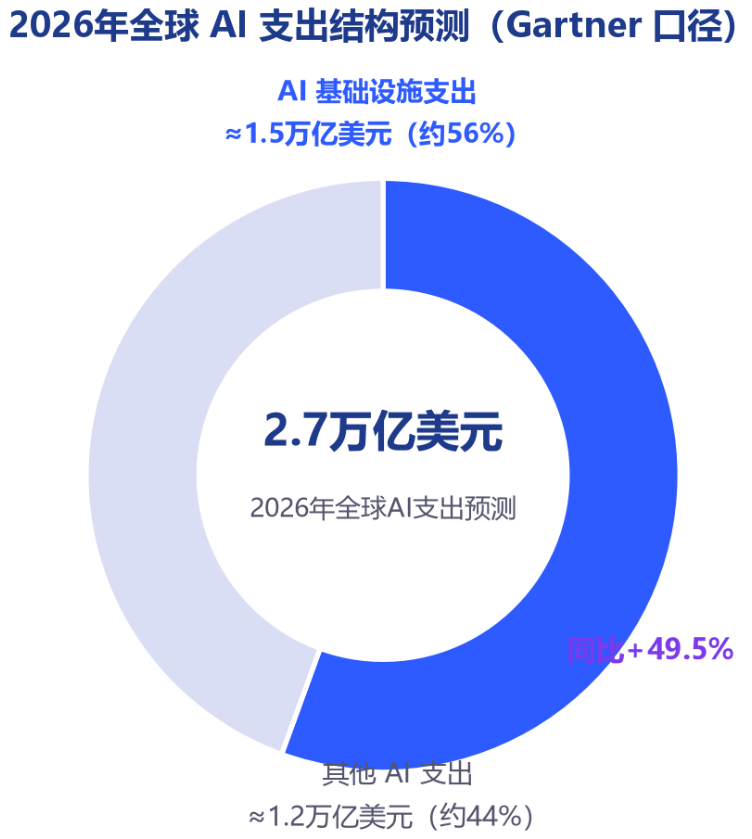
图3:2026年全球 AI 支出结构预测(Gartner 口径)
六、观察:多吉瓦背后的三重约束
多吉瓦级是 AI 基础设施从机架竞赛走向园区竞赛的标志性刻度,但它的兑现节奏受制于三重约束。其一是电力与散热。吉瓦级园区意味着一座中型城市的用电体量,单个 NVL72 机柜超过220千瓦的功率密度使全液冷成为必选项,供电、土地与电网接入周期动辄数年,任何一环不足都可能拖住整套系统的交付——这也是甲骨文强调两公里半径内密度优化、吉瓦级供电液冷工程化的原因。
其二是内存。英伟达财报确认内存价格涨幅超出预期、HBM 产能集中于 SK 海力士、三星与美光三家;2790亿美元的供应承诺表明,算力竞争的瓶颈正在从 GPU 晶圆转向存储,厂商间比拼的维度已从工程能力部分让位于资本与订单锁定能力。供应承诺的快速膨胀甚至被市场解读为一种准入壁垒:无法提前数年预付产能的竞争者,即便完成芯片设计也难以获得内存配额。
其三是竞争与话语权的再平衡。甲骨文在扩大英伟达合作的同时引入谷歌 TPU、Cerebras、SambaNova,并在英伟达系统中改用自研 Acceleron 网络,显示超大规模云厂商正在系统性地回收议价权与利润空间;英伟达则以 Vera CPU 向上补齐 CPU 短板、以全栈平台维持体系优势。双方在多吉瓦规模上的利益交汇,掩盖不了推理算力市场走向多元化的长期趋势。
综合而言,本次多吉瓦扩容公告的真实意义在于三点:Vera Rubin 平台完成了从量产到云上商用的关键跨越;OpenAI 十万卡级生产负载为 OCI 的集群工程能力提供了可验证的背书;云厂商与芯片厂商的分工与博弈进入新阶段。后续观察点集中在10月29日甲骨文投资者日的融资安排、Vera Rubin 四季度的出货爬坡,以及内存价格何时见顶——三者将共同决定多吉瓦蓝图兑现的速度。