《Old Ideas, Novel Problems》与 novelty-judge-bench 基准:六个评判器、两个想法池与 93.5%→40.9% 的崩塌曲线。
一、事件聚焦:Ai2 发布 novelty-judge-bench,直指大模型新颖性评判可靠性
当地时间 2026 年 10 月 27 日,艾伦人工智能研究所(Allen Institute for AI,Ai2)发布研究《Old Ideas, Novel Problems》(《旧想法、新问题》),并同步公开配套基准 novelty-judge-bench、数据集、代码以及一套可用于构建新评估集的自动化流水线。这项研究试图回答一个正在变得日益紧迫的问题:当越来越多的科研想法由 AI 生成,我们能否信任另一个大语言模型来判断这些想法是否真正新颖?
研究背景在于,Ai2 自身正在构建覆盖科学发现全链条的 AI 系统矩阵:DataVoyager 帮助研究人员探索和分析结构化数据,AutoDiscovery 生成并测试科学假设,Theorizer 将大规模文献中的证据综合为候选科学理论,再加上智能体产品 Asta。在这些系统中,“生成想法”只是前半程,后半程需要判断想法是否贡献了真正新的东西——这一判断通常被交给另一个大语言模型完成,Ai2 将其称为“新颖性评判器”(novelty judge)。
问题在于,这类评判器目前没有标准化的构建方法:研究团队自行选择模型、提示词、评估格式、推理预算,有时还外挂文献检索系统,而这些选择会实质性地改变评判结论。更关键的是,多数评判器只在人类撰写的论文上做验证,却在其真正要打分的 AI 生成想法上投入使用。论文作者为 Noy Sternlicht、Simra Shahid、Peter Jansen、Daniel S. Weld、Pao Siangliulue 与 Tom Hope,研究于 2026 年 10 月 1 日首次提交 arXiv(编号 2610.02022),10 月 26 日更新至 v3 版。
这一评估环节并非边缘需求。《第五范式:人工智能驱动的科技创新》与《人工智能应用发展趋势报告(2026)》显示,国内外的科研智能体实践中已普遍采用“以第三方语言模型作为评估器”的方式,对科学假设的新颖性与可行性进行自动评价,并以此驱动假设的迭代进化。评判器一旦失灵,整条 AI 科研流水线的筛选环节都将随之失真。
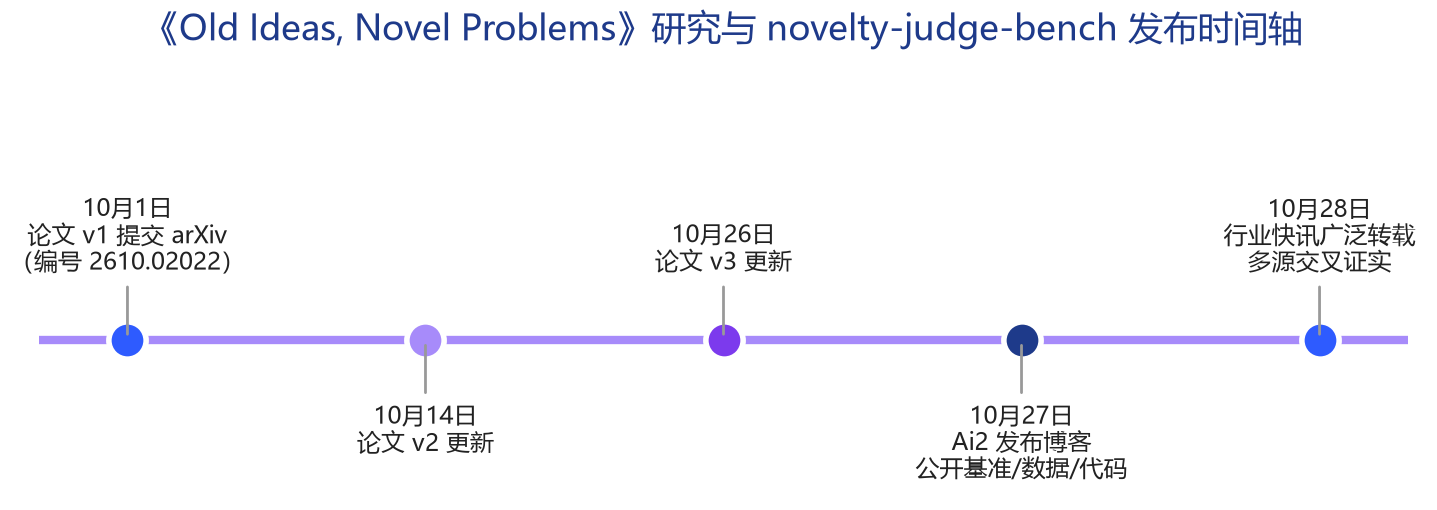
图1 《Old Ideas, Novel Problems》发布时间轴
二、关键数据:提示词微改致 GPT-5.4 准确率从 93.5% 跌至 40.9%
novelty-judge-bench 的构建绕开了“以论文录用与否代指新颖性”的常见捷径。研究团队围绕 ICLR 2026 同行评审数据搭建自动化挖掘流水线,直接从 OpenReview 评审意见中提取明确肯定或质疑原创性的段落:高新颖性池收录 154 个人类撰写的研究想法,来自各研究领域评分前 10% 的录用论文,且审稿人正面认定其新颖、无任何审稿人提出异议;较低新颖性池收录 145 个想法,来自评分后 10% 的被拒论文,审稿人提出原创性疑虑且无人正面认定其新颖。标注质量抽查显示,50 例中标注者同意 47 例,且分歧均不改变极性。
在 Human+Generated 设置下,上述 154 个已验证的人类想法与一个简单 LLM 生成器产出的 154 个想法(仅获研究领域和“提出新颖想法”指令,不做文献检索、工具调用与迭代反馈)配对打分。专家独立审查了其中 30 对配对——偏重最强评判器答错的案例——结果专家在全部 30 对中均偏好人类想法,并判定所有被抽查的生成想法都不新颖。
研究的六个受试评判器为:GPT-5.1、GPT-5.2、GPT-5.4,以及 Claude Sonnet 4.5、Claude Opus 4.5、Claude Opus 4.6;此外还测试了配备高推理预算和限定 arXiv 的迭代式实时搜索的 agentic 评判器 GPT-5.6 Sol。提示敏感性实验是全篇最刺眼的数据:对于同一组 Human+Generated 想法配对,提示 A 告知模型“审稿人发现每对中恰好有一个想法是新颖的”并要求指认,GPT-5.4 的判断准确率达 93.5%;而提示 B 仅简单询问“哪个想法是新颖的”,同一模型的准确率随即跌至 40.9%——不仅下降超过 50 个百分点,还低于二选一的随机水平(50%),模型在超过一半的相同配对上改变了判定。
对照组数据进一步凸显问题的特殊性:同样的提示改动,在仅含人类想法的 Human-Only 数据集上平均只造成约 7 个百分点的波动,说明评判器在人类研究上看似稳定,但在 AI 生成想法上行为迥异。不过人类想法并非完全免疫——Claude Opus 4.6 在 Human-Only 数据集上经同一改动也移动了 21 个百分点。研究还发现不存在普遍更优的提示词:删除“不要把琐碎的渐进式贡献当作新颖”这类指令,对部分评判器是提升、对另一些则是下降;在生成器对比实验中,提示词改动平均导致六评判器约四分之一至三分之一的判定翻转。
成本维度同样出人意料。在 Human+Generated 设置下按每次判定的调用成本与 macro-F1 衡量:仅花 2.59 美元、采用低推理预算加三次调用多数投票的简单 Claude Opus 4.6 提示基线取得 0.854 的 macro-F1;而两个专门为新颖性评估构建的专用系统全部落败——文献检索加重排序流水线的 Idea Novelty Checker(基于 Claude Opus 4.6)得到 0.642,成本 30.66 美元;Sakana AI 的 AI Scientist(迭代搜索 Semantic Scholar)得到 0.772,成本 82.05 美元。重装备的 GPT-5.6 Sol 得到 0.78,落后于 Claude Opus 4.6 提示基线最佳设置的 0.89 达 11 个百分点,而成本约为标准检索评判器的 10 倍。
表1 各评估系统成本与 macro-F1 对比(Human+Generated 设置)
评估系统 | macro-F1(越高越好) | 单次判定成本(美元) |
简单 Claude Opus 4.6 提示基线(低推理+3 次调用多数投票) | 0.854 | 2.59 |
Claude Opus 4.6 提示基线最佳设置 | 0.89 | — |
GPT-5.6 Sol(高推理+限定 arXiv 迭代搜索) | 0.78 | 约为标准检索评判器的 10 倍 |
Sakana AI 的 AI Scientist(迭代搜索 Semantic Scholar) | 0.772 | 82.05 |
Idea Novelty Checker(文献检索+重排序流水线) | 0.642 | 30.66 |
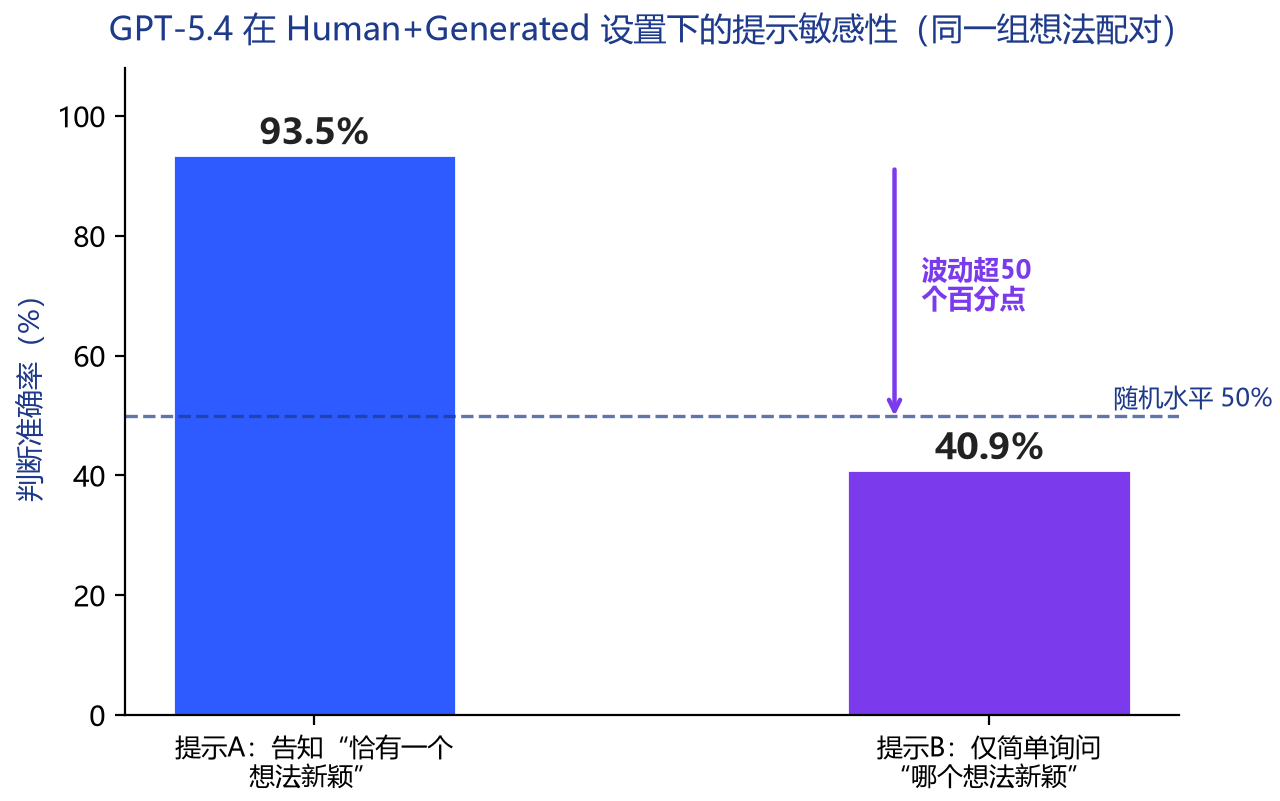
图2 提示词微改前后 GPT-5.4 在 Human+Generated 设置下的判断准确率
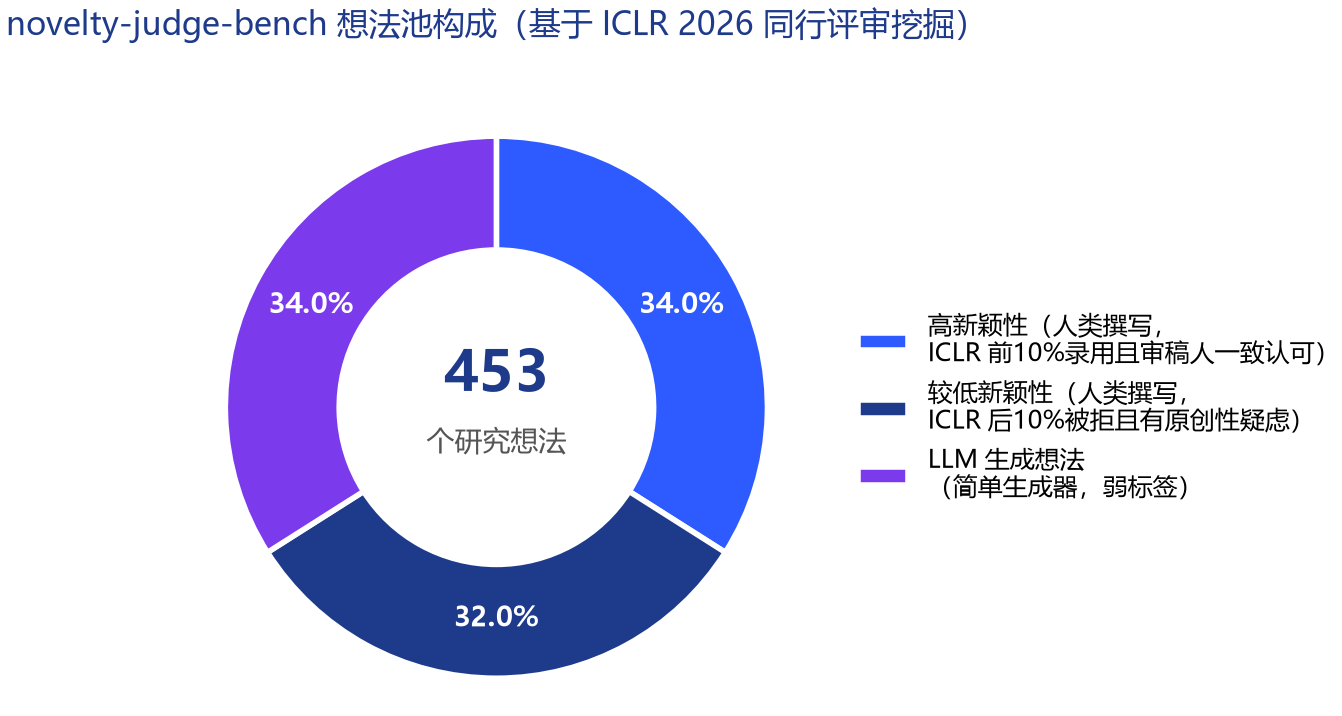
图3 novelty-judge-bench 想法池构成
三、机制剖析:为什么新颖性判断对大模型格外脆弱
第一层原因在于评判对象的分布错位。论文指出,多数新颖性评判器是在人类撰写的论文上构建和验证的,而其服役场景却是给 AI 生成的想法打分——两类文本在表述方式、论证结构与措辞习惯上分布不同。本次实验中,评判器在 Human-Only 数据集上仅约 7 个百分点的提示敏感波动,在 Human+Generated 数据集上被放大到 50 个百分点以上,正是这种分布错位的直接体现。为此,研究团队还将人类与 AI 想法统一改写为相同结构,以测试评判器是否只对写作风格作出反应。
第二层原因在于“新颖性”缺乏客观答案键。一个想法是否新颖,取决于它与既有文献的关系,而模型只能基于训练分布中的知识和外部检索来近似这种关系。实验表明,为评判器补充相关论文检索、扩大推理预算,都不能持续提升判断质量——更多搜索和更多算力并不等于更一致、更准确的判断。GPT-5.6 Sol 重金打造的 agentic 检索路线反而落后于朴素提示基线,说明失灵更多出在判断机制本身而非信息不足。
第三层原因是评估协议本身的脆弱性。研究强调,其核心发现部分并不依赖标注标签:两个完全合理的评估设置可以对同一组配对给出相反的答案,这一事实本身就构成不稳定性证据。换言之,即便不去争论某个想法究竟是否新颖,评判器随提示词、生成器、评估格式等设计选择而剧烈摇摆的行为,已经足以否定其作为“客观裁判”的资格。论文作者将这类评判器的现状概括为“临时搭建、很少压力测试”。
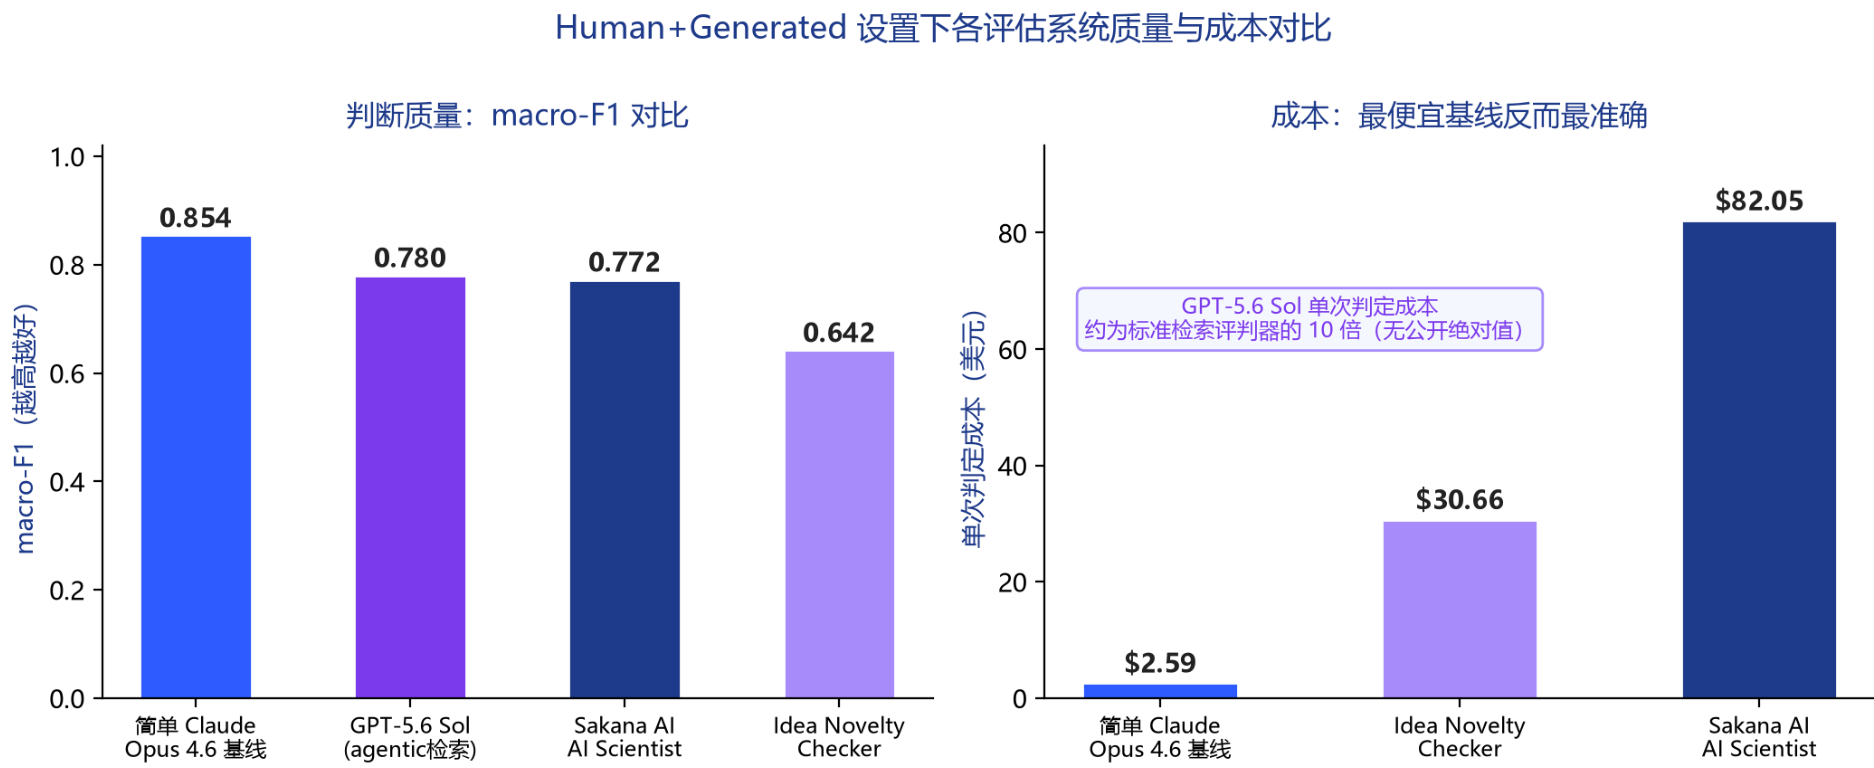
图4 各评估系统 macro-F1 与单次判定成本对比
四、产业影响:AI for Science 流程中的人工守门与评估工具市场
这项研究最直接的冲击对象,是 AI for Science 领域日渐成型的“生成—筛选—评审”自动化流水线。论文明确指出,新颖性判断不仅发生在流水线终点,也内嵌于 ideation 系统内部——智能体在候选想法池中反复筛选、精炼,每个环节都依赖评判器的裁决。若评判器随提示词设计而剧烈摇摆,那么系统报告的“新颖性增益”本身就需要重新审视:论文作者直言,这些结果对自动化 ideation 系统此前报告的新颖性提升提出了质疑。
对评估工具供应商而言,成本数据构成一次结构性警示。两个专用评估系统以 30.66 美元和 82.05 美元的单次判定成本,输给了 2.59 美元的朴素提示基线——复杂的检索管线与重排序机制没有换来判断力的提升。这一结果对“堆叠复杂度”的产品路线提出了挑战,也提示采购方在评估此类工具时,应要求厂商在真实服役场景(尤其是 AI 生成想法)上出示跨提示、跨模型的敏感性测试证据,而非仅有人类论文上的验证数据。
对科研机构与会议组织方而言,研究为同行评审的自动化边界划出了参考线。在评审人带宽紧张的背景下,用 LLM 辅助初筛的诱惑真实存在;但基准数据表明,至少在当前技术状态下,新颖性判断这一环节不宜完全交给大模型,尤其当被评审对象本身是 AI 生成内容时。人类专家的守门角色在 AI 生成想法的评估中不仅没有被削弱,反而被这次实测重新确认——专家审查 30 对配对全部判对,与最强评判器的失误形成对照。
五、展望与建议:谨慎使用、组合评估与人类监督
研究团队为这一方向给出了明确的后续议程:其一,在评判器实际要评估的想法类型上做测试,而不是只在人类论文上验证;其二,系统测量跨提示、跨模型的敏感性,把稳健性作为评判器的一项显式指标;其三,改进文献引入方式,让“对照既有工作”的判断建立在更可靠的信息基础之上;其四,构建能够随文献增长和 AI 能力演进而持续更新的基准,避免评估集与服役场景脱节。
对当下打算使用此类工具的机构,基准数据给出了三条可操作的启示。第一,先跑低成本基线:本次实验中,简单提示加多数投票的基线既更便宜又更准确,任何复杂评估系统在采购前都应先与之对比。第二,做提示敏感性压力测试:由于不存在普遍更优的提示词,评估方案应报告在多种合理提示下的判定方差,而非只报告单一配置的成绩。第三,为关键决策保留人类复核:在涉及资源分配、论文录用、研究方向取舍的场景中,新颖性判断的最终裁决权应留在人类专家手中。
novelty-judge-bench 的价值或许不在于给出了“哪个模型最好”的答案——它恰恰证明了这类排行榜在当前条件下并不可靠——而在于为整个行业提供了一面镜子:在 AI 大规模介入科学发现之前,如何判断“什么是真正的新”,仍是一个尚未解决的开放问题。正如 Ai2 在博客结尾所言,如果 AI 要在科学发现中扮演更大角色,我们就需要更可靠的方法来判断它是否真的在提出新东西;这项工作提供了研究这一问题的工具,同时也展示了尚未解决的部分还有多少。