半年30亿元的融资强度,把这家孵化自北大信研院的芯片初创推到了聚光灯下。在AI推理算力紧缺与先进制程受限的双重背景下,微纳核芯所代表的三维存算一体路线,正从学术实验室走向量产线。当“高性能、低功耗、低成本”的不可能三角出现新的解法,一场围绕AI推理芯片架构话语权的争夺,才刚刚开始。
近日,微纳核芯宣布获得10亿元人民币C+轮融资,本轮融资由建投投资领投,领阳基金、国投泰康、盛堃投资、财金投资、晓池资本、凯泰资本、杭州资本等机构参投,多名老股东继续加码。
这已是公司近两个月内的第二笔大额融资。今年9月,微纳核芯完成10亿元C1轮融资,投资方涵盖德联资本、优势资本、元昊投资、金浦投资、阳光人寿、元禾璞华、厚雪资本等专业机构,以及美格智能、华勤技术、知名大模型公司等产业资本。叠加本轮融资,公司两个月内C轮系列融资超20亿元,半年累计融资总额达30亿元,资金将用于芯片迭代、客户送测、软件栈适配及供应链量产备货。
拉长周期看,其融资节奏明显提速:2025年10月完成超1亿元B轮融资,由蓝驰创投领投,中芯聚源、锦秋基金等加持;此后B轮系列持续扩容,包括兆易创新参与的B2轮,以及2026年6月完成的超10亿元B3、B4轮,引入中国移动链长基金、立讯精密产投等产业资本,历史股东中深创投、中芯聚源、毅达资本等自B轮起持续加注。国资与产业资本的密集入场,与“十五五”规划纲要明确提出推进存算一体、三维集成、光电融合技术突破应用形成呼应;在美国收紧先进计算芯片出口管制、将处理性能与DRAM带宽纳入审核的背景下,这类“不依赖先进制程”的架构正获得战略溢价。
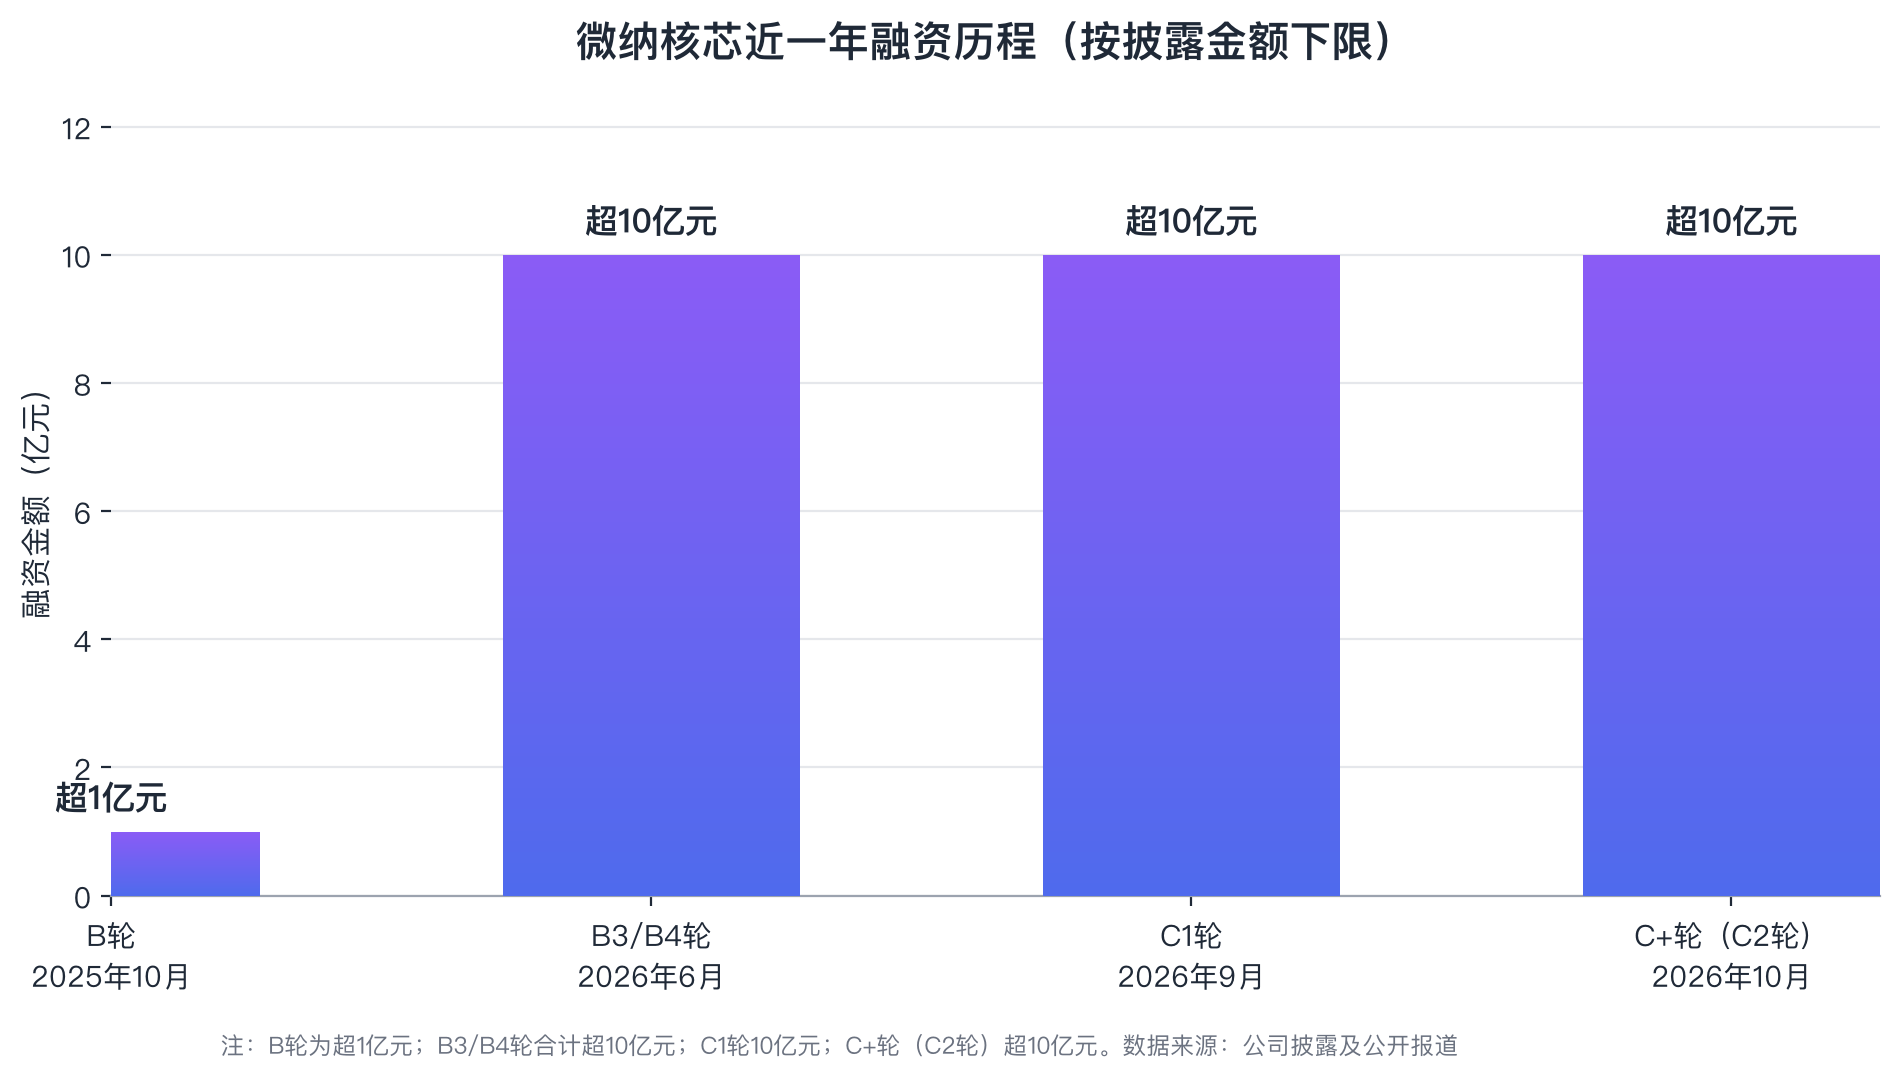
图表解读:从超1亿元的B轮,到连续两笔10亿元级的C1轮与C+轮,微纳核芯半年融资30亿元,投资方结构亦由财务资本向“国资+产业资本”演进。
北大系班底与3D-CIM:破解“不可能三角”
微纳核芯全称杭州微纳核芯电子科技有限公司,成立于2021年,总部位于杭州萧山,孵化于浙江省北大信息技术高等研究院。创始人、首席科学家兼董事长叶乐为北京大学集成电路学院副教授、博士生导师,在ISSCC、JSSC等芯片设计顶会顶刊发表论文近20篇。核心团队自2018年起研究存算一体CIM技术,汇聚百余名高校博士/博士后与头部大厂工程师,近六年在ISSCC连续输出十余项打破世界纪录的实测成果。
微纳核芯于2023年在业内首创三维存算一体(3D-CIM™)架构,将3D近存计算(DRAM)、SRAM存算一体与RISC-V异构存算三条路线融为一体。其中,SRAM存算一体将计算单元深度嵌入存储单元,并行完成大模型推理中占比99%以上的矩阵/张量计算;实测流片结果显示,较传统冯·诺依曼架构可提升4-6倍算力密度和5-10倍能效比。公司还构建了覆盖指令集、算子库、编译器、工具链的RV-CIM全栈体系,以降低新架构的开发与迁移门槛。
产品端,公司布局端侧LP-CIM™与云侧PCIe-CIM™两条产品线:前者与存储原厂深度协同,面向AI手机、AI PC、机器人等场景提供极致性价比方案;后者以国产成熟工艺实现先进制程等效算力,覆盖服务器、智算中心等场景。目前第一代三颗芯片已完成投片,计划2027年初开展客户送测和批量供货,年内将陆续完成多场景客户送样测试。
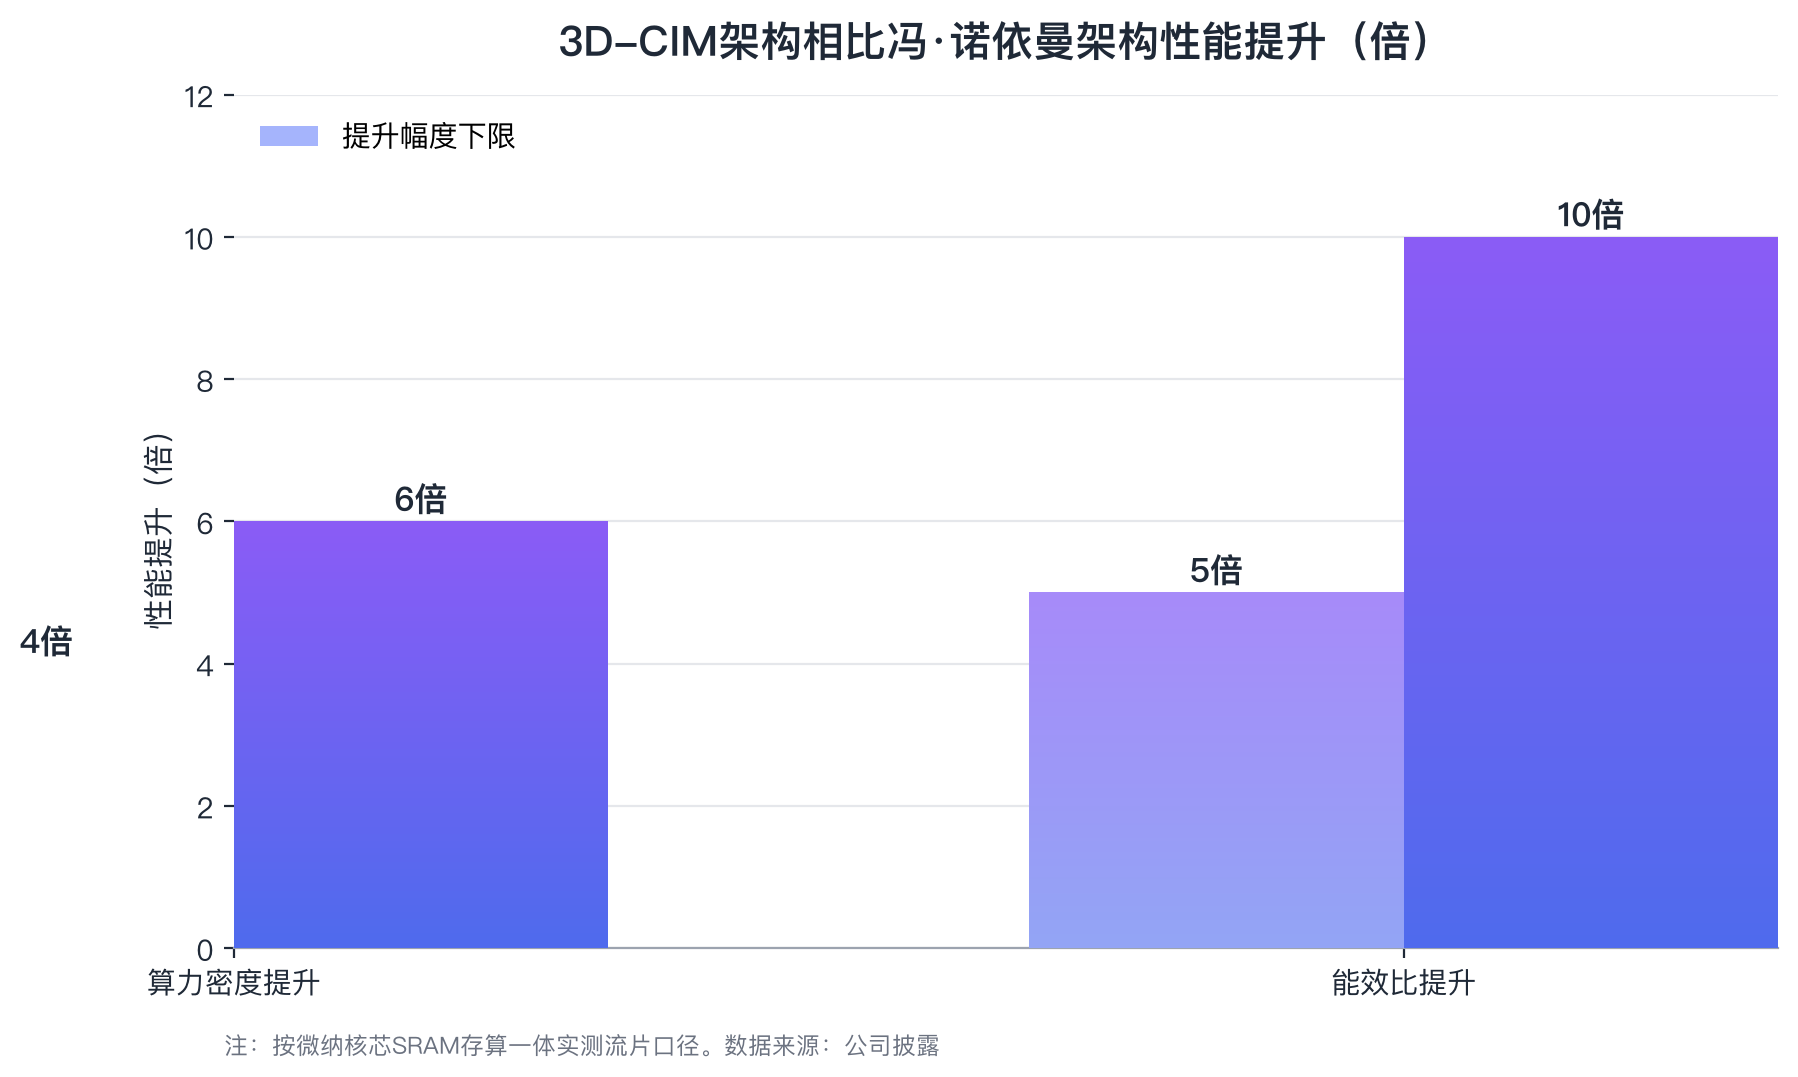
图表解读:按公司披露的实测口径,其方案算力密度提升幅度为4倍至6倍,能效比提升幅度为5倍至10倍,对应成本与功耗的同步改善。
从“存储墙”到千亿市场
存算一体的核心,是将计算功能直接嵌入存储单元,消除数据在处理器与存储器间的频繁搬运。按融合程度,业界将其划分为近存计算(以2.5D/3D先进封装缩短物理距离,典型如HBM)、存内处理(存储芯片内嵌计算单元)、存内计算(直接利用存储单元物理特性完成计算)三个阶段,并视之为继CPU、GPU之后的算力架构“第三极”。需要指出的是,HBM本身并不负责计算,并非严格意义的存算一体,三星HBM-PIM则代表了更深层融合的探索方向。
需求端,国务院《关于深入实施“人工智能+”行动的意见》提出2027年智能体终端普及率达70%;Omdia预测全球端侧AI芯片组市场规模将从2024年的20亿美元增至2028年的167亿美元。政策端,“十五五”规划纲要首次将存算一体纳入前沿技术突破应用方向。
市场空间方面,QYResearch预计全球存算一体市场规模将从2022年的4383万美元增至2029年的306.28亿美元,复合增长率高达154.68%;量子位智库预计中国存算一体芯片市场2025年约125亿元,2030年达约1136亿元,其中中小算力芯片约1069亿元、大算力芯片约67亿元。资本动向同样火热:2025年中国芯片一级市场投资事件超1200起、金额1244亿元,资本正转向具备落地优势的细分环节。
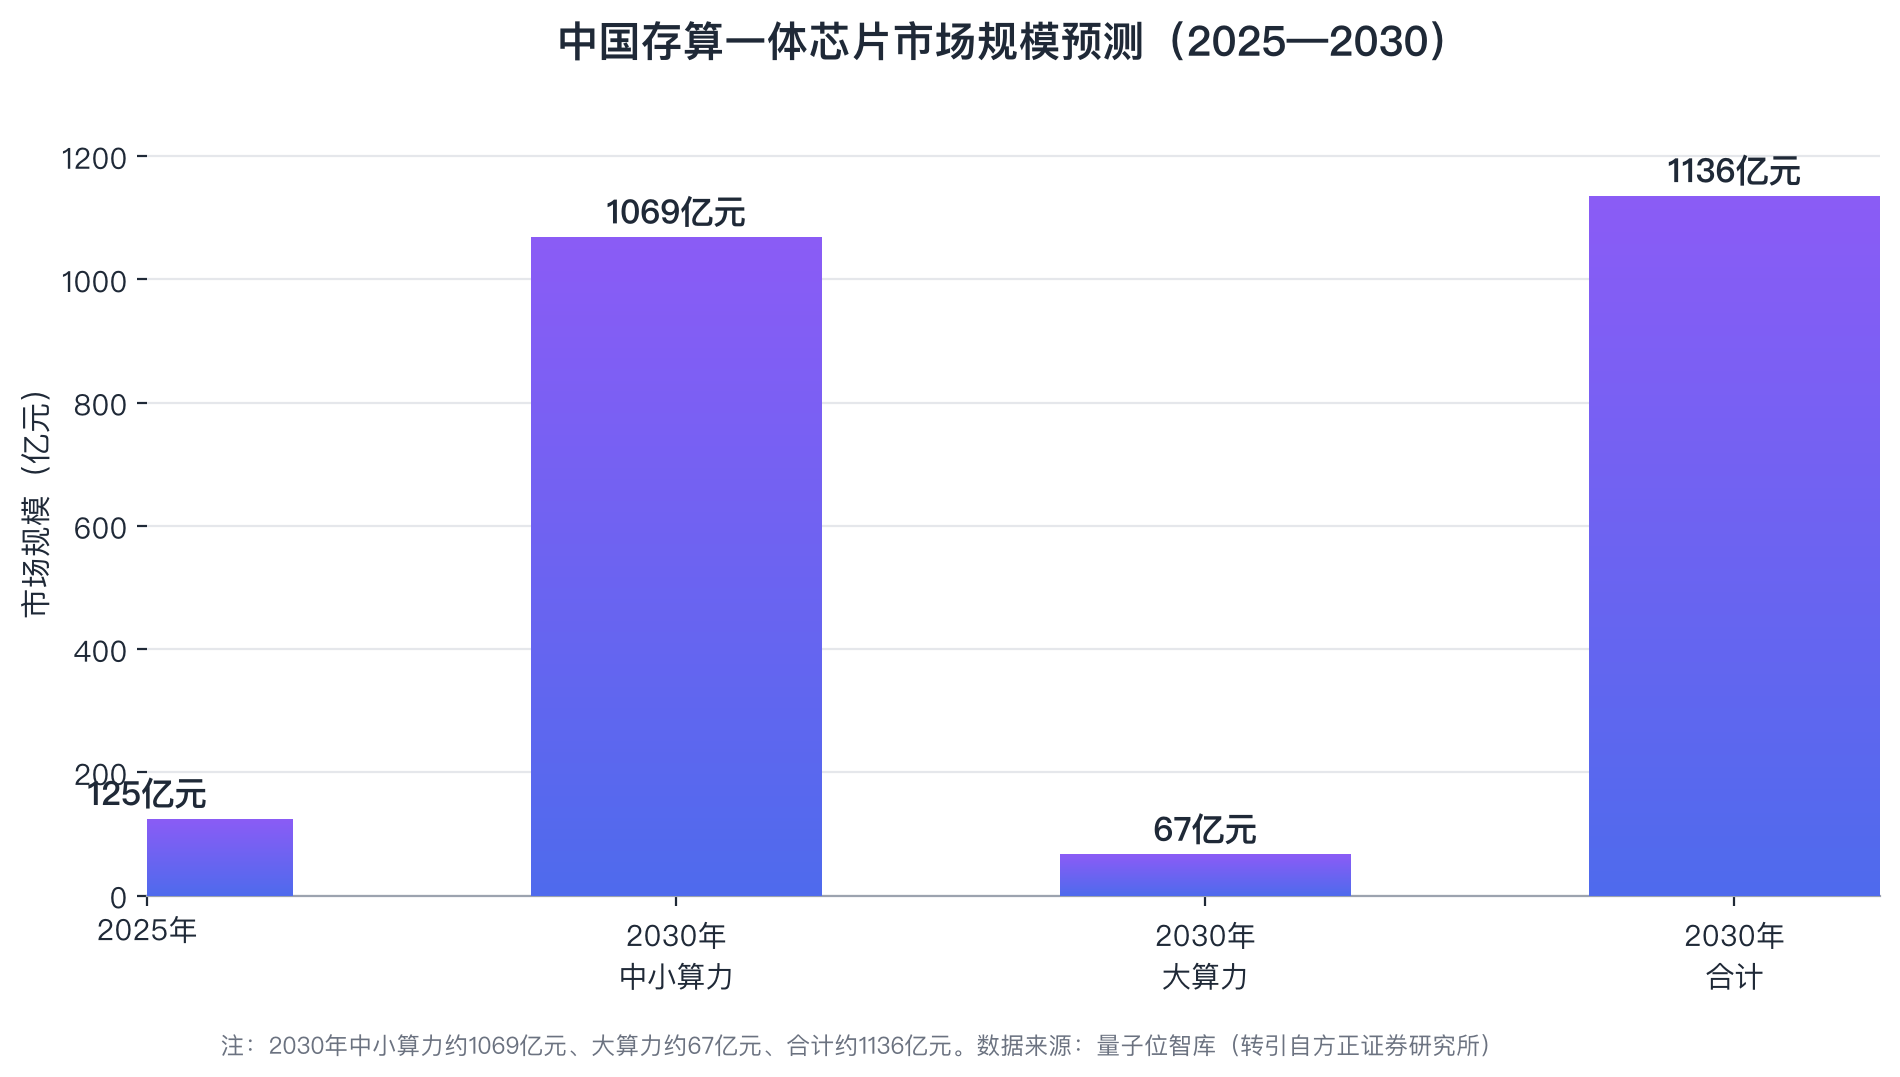
图表解读:中国存算一体芯片市场规模预计从2025年的约125亿元增至2030年的约1136亿元,其中面向端/边缘侧推理的中小算力芯片贡献主要增量。
多路线赛马:国产存算一体的竞速图谱
存算一体并无统一技术答案,国内已形成SRAM数字存算、Flash模拟存算、ReRAM全数字存算、3D DRAM等多路线并行的格局。
后摩智能是商业化进展最快的厂商之一:其鸿途H30为国内首款大算力存算一体智驾芯片,算力256TOPS、典型功耗35W;第二代漫界M50于2025年四季度量产,不到一年拿下超150个端侧产品定点、服务客户超百家,其架构可将核心计算阵列面积压缩至传统架构的三分之一、功耗降至十分之一;基于3D CIM架构的A20芯片已投产,支持16芯全互联,可覆盖3B至30B级模型,M6X系列综合能力达M50的3至6倍。
知存科技基于NOR Flash模拟存算路线,已有芯片实现商业应用并进入规模化交付。恒烁股份的CiNOR“恒芯1号”基于65nm NOR Flash制程完成流片,利用其模拟特性在芯片内一次完成向量矩阵乘法,“恒芯2号”已回片测试,同时与中国科学技术大学合作研发SRAM数字存算一体技术。
亿铸科技聚焦ReRAM全数字路线,其AI芯片已完成流片验证,近日完成超10亿元融资;其CEO熊大鹏认为,CIM在能效与成本效益上可超越HBM,有效数据带宽或达HBM的数倍至十倍。思敏威主打“青衡”HPU架构,融合SRAM存内计算与3D异质封装近存计算,2025年率先流片验证FP4浮点存内计算IP,今年10月完成亿元级天使轮融资,中兴通讯等机构参与,第一代3D堆叠量产芯片流片在即。
此外,光羽芯辰独创EdgeAIon™ 3D存算一体架构,聚焦AI PC、AI手机,近期完成数亿元融资;谦合益邦布局3D DDRAM路线;铭芯启睿(RRAM感存算)已完成超亿元Pre-A轮融资;千芯科技、苹芯科技、九天睿芯等亦在细分方向推进。国际上,英特尔、IBM、三星、特斯拉及Groq、d-Matrix等公司早已有CIM技术布局。
送样之后:从架构优势到商业胜势
尽管资本与政策形成共振,存算一体从“实验室明星”成长为“产业主线”仍需跨过三重门槛:其一,商业化验证,多数企业仍处送样或小批量阶段,微纳核芯2027年初才批量供货,年内多场景送样表现是关键观察点;其二,软件生态,工具链成熟度直接决定新架构芯片“是否好用”;其三,竞争加剧,后摩智能等已进入量产兑现期,路线之争将正面交锋;其四,市场不确定性,各机构统计口径不一,规模预测仍存较大变数。
微纳核芯半年30亿元的融资强度,标志着三维存算一体已进入资本密集投入期;未来一两年,量产交付能力、软件生态成熟度与终端场景定义能力,将决定谁能率先把架构优势转化为商业胜势。