——1638个用例基准超Claude Opus 5等全部受测前沿模型,自托管成本最高低约147倍
2026年11月4日,巴西AI研究实验室Dharma-AI在Hugging Face发布文档字段提取模型Dharma Field Extractor。这是一款20亿参数的专用小语言模型,输入一张文档图像,直接输出结构化的JSON字段。在其自建的1638个用例基准上,该模型以0.834的字段级F1超过Claude Opus 5(0.816)等全部四个受测前沿大模型配置;按单张L40S GPU每小时2.24美元折算,自托管成本较前沿API低约6倍至147倍。
一、不做整页识别,只取业务字段
传统OCR忠实还原整页文字,但当业务系统真正需要的只是供应商、发票号、到期日、金额四个字段时,OCR返回的逐行文本仍需人工或代码映射到数据库字段。通用大模型可以通过提示词完成这项工作,但在高吞吐业务场景下,前沿API的价格与时延使其成为“解决一个定义清晰问题的昂贵方式”。
Dharma Field Extractor提供两种请求模式。开放模式不提供schema,模型从上下文与版面中自行识别结构化字段——标签加值的组合、表头压着数据列的表格——把找到的内容全部以键值对返回;模式驱动模式则由用户逐字段指定类型(字符串、数字或布尔值),输出键名与下游系统完全一致,表格逐行逐列填充,文档上不存在的字段返回null而非编造数值。
字段抽取正是智能文档处理行业的核心命题。Gartner在《智能文档处理解决方案市场指南》中将其定义为“从多格式、多版式文档内容中自动提取数据”的专用数据集成工具,并指出生成式AI虽已重塑这一市场,但大模型在准确性、时延与成本上仍逊于其他机器学习模型,其定位是IDP内部的一个组件而非竞争者。合合信息在2026年多模态文本智能白皮书中同样指出,扫描件模糊倾斜、版式不固定、跨页表格与合并单元格、领域术语壁垒,都是通用方案难以逾越的障碍。
二、OCR专用基座加4.3万样本LoRA微调
Dharma Field Extractor的基座是DharmaOCR-LITE v1.1——一个20亿参数、经监督微调与DPO优化的OCR专用版本。研究团队在该检查点上训练LoRA适配器,训练样本共43384条,覆盖开放与模式驱动两种请求方式。
训练数据分为三路:来自公开网络的英语多域文档、来自内部真实场景的巴西葡语文档,以及小占比的欧洲与亚洲多语言数据,全部完成字段级标注,覆盖收据、商业发票、表单、银行对账单、身份证件与合成文档。
这条路线有前作背书。2026年4月,Dharma-AI发布30亿参数的DharmaOCR-LITE初代模型,其论文《DharmaOCR:在结构化OCR上超越开源与商业基线的专用小语言模型》(arXiv编号2604.14314)显示,该模型在巴西葡语OCR上超过所有受测商业前沿API;三个月后更新、资源更足的前沿模型出现,这一差距依然保持。
三、1638个用例:0.834对0.816
基准测试覆盖546份文档、三种请求场景,合计1638个用例:不带schema提取全部字段;只含真实字段的部分schema;以及故意加入虚构字段(幻影字段)的schema——用以检验模型是否会无中生有。评分公式为字段级F1(按路径匹配,含表格内位置)乘以匹配值的Levenshtein相似度,再乘以有效JSON输出占比。
在同一基准、同一轮测试中,20亿参数的Dharma Field Extractor得分为0.834;四个受测的前沿配置中,最接近的Claude Opus 5为0.816,差距1.8分;差距最大的GPT-5.6 Luna为0.741,相差9.3分。
【图表:Dharma Field Extractor与前沿大模型字段级F1对比】
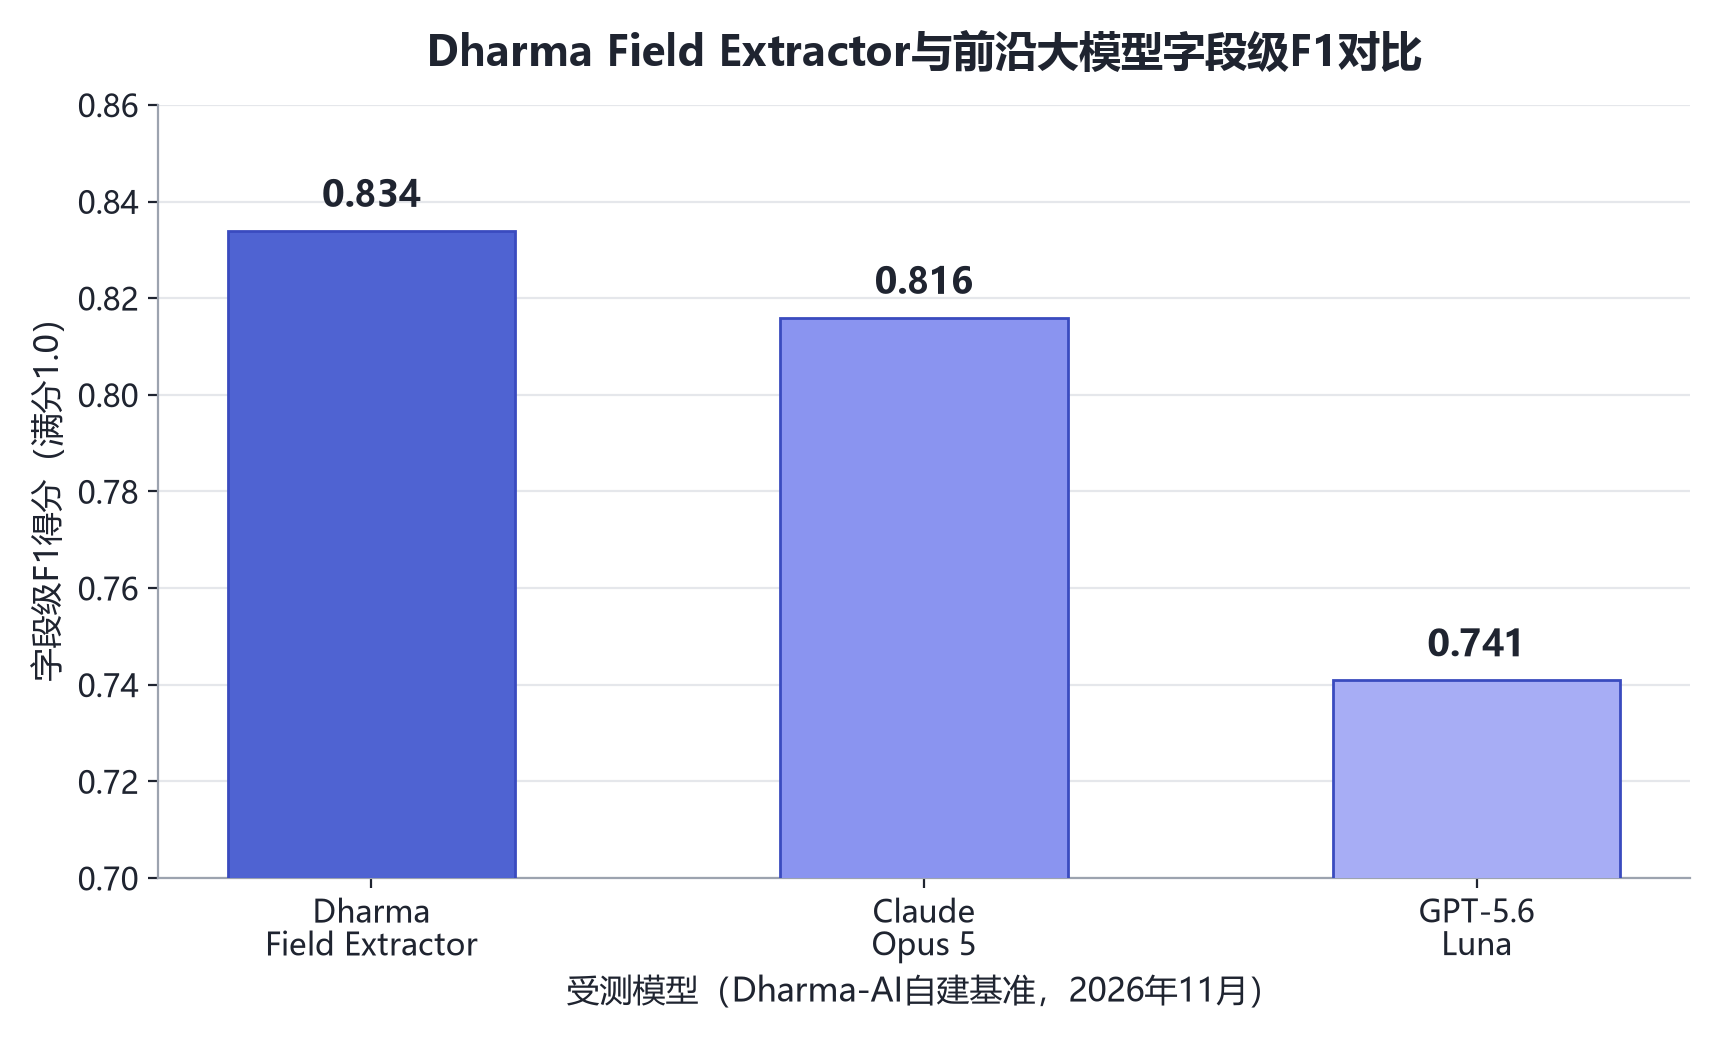
在Dharma-AI自建的字段提取基准上,2B专用模型以0.834居首,领先Claude Opus 5约1.8分、领先GPT-5.6 Luna约9.3分;专用小模型高于全部受测通用前沿模型。需要提示的是,该基准由Dharma-AI自行构建与运行,属厂商自评结果。
四、成本账:单卡L40S,最高便宜147倍
成本测算采用实测token对照列表价的方法:前沿模型侧记录每页平均输入输出token(含推理token),对照各厂商公开列表价;受测模型统一将推理档位设为low,Claude Opus 5使用自适应effort(简单页面可跳过推理)。Dharma Field Extractor则按自托管单张L40S GPU每小时2.24美元折算。
结果显示,自托管成本较前沿API低约6倍(对比GPT-5.6 Luna)至147倍(对比GPT-5.6 Sol)。
【图表:自托管成本较前沿API降低倍数】
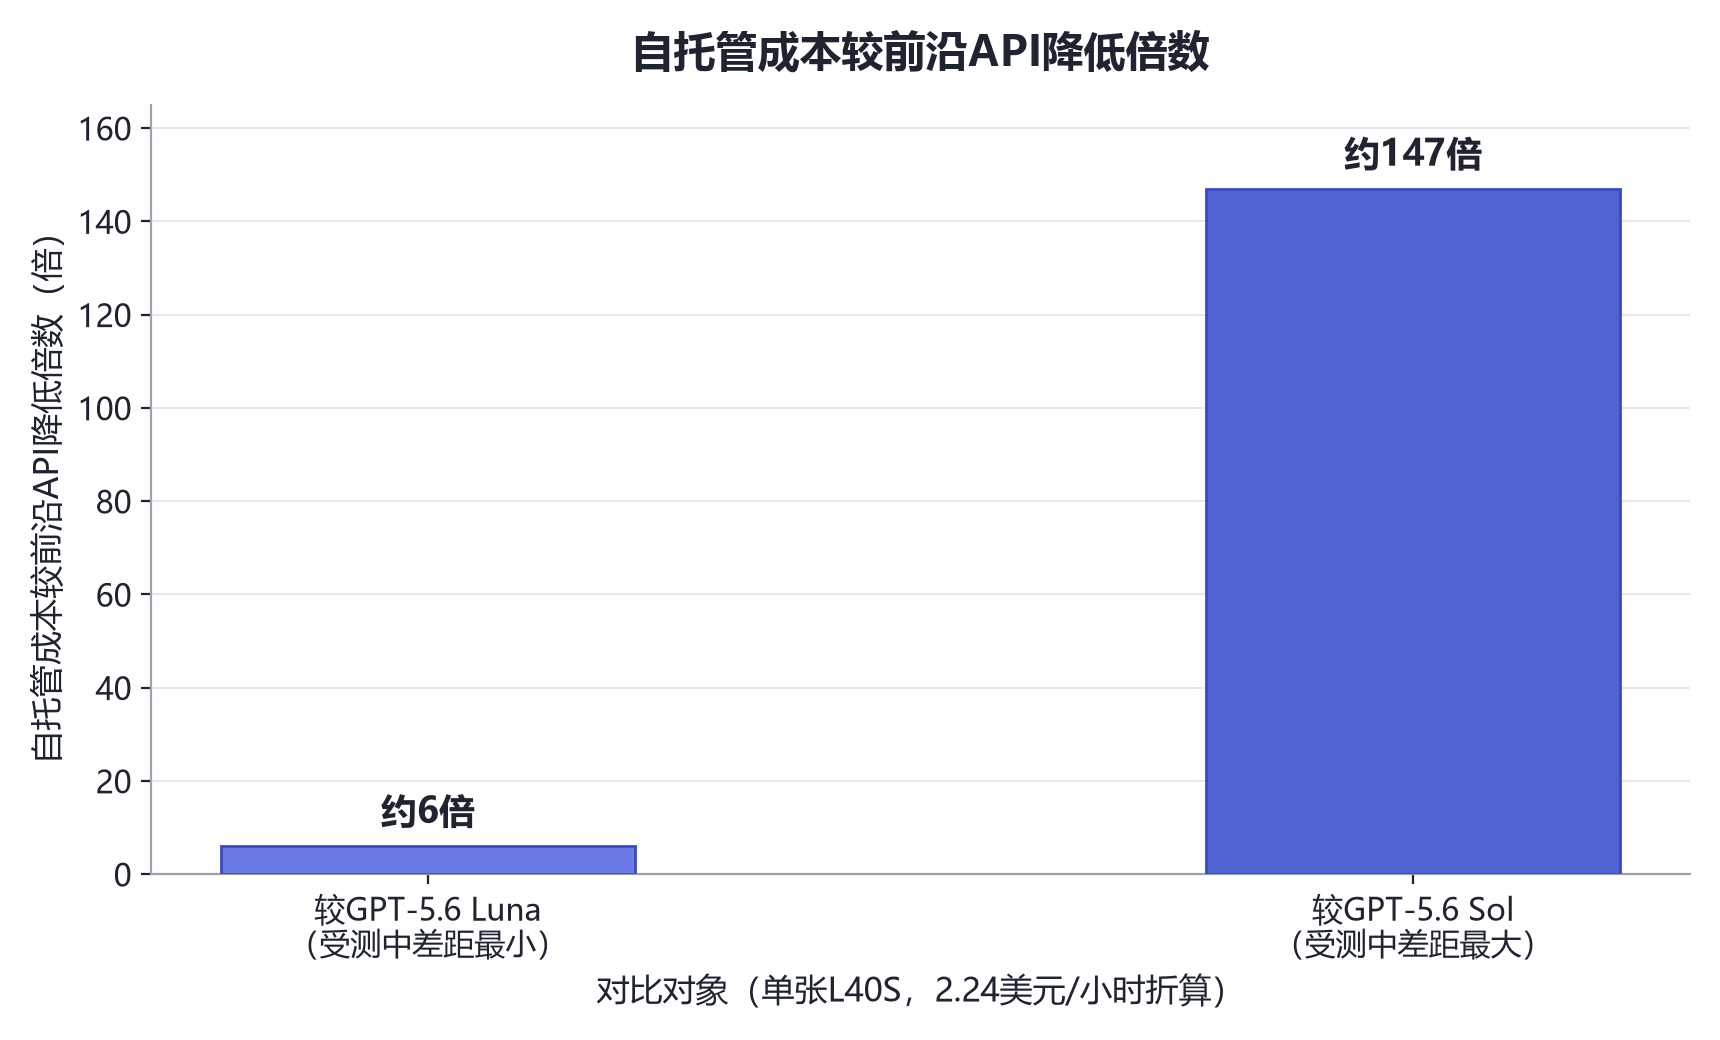
受测四个前沿配置中,与GPT-5.6 Luna的成本差距最小(约6倍),与GPT-5.6 Sol差距最大(约147倍)。Dharma-AI强调这并非销售报价——自托管成本取决于硬件、调用量与时延要求,测算意在证明自托管主权小模型(SSLM)是前沿API的真实替代选项。
五、泛化实测:训练集之外的SROIE与FUNSD
在两个未参与训练的公开数据集上,模型展示了零样本泛化能力。SROIE收据测试要求提取票面全部18个字段:多行、无标签的账单地址被归为单个字段,salesperson与ref两个空白字段正确返回null,全部金额分毫不差。
在FUNSD复印差异表单上,模型面对12个布尔字段(含一组嵌套的5个子选项)准确勾出唯一选中的“原件质量差”项(旁边有手写“faded”标注),其余11项判定为false,同时正确读出手写Bates编号,两个空白字段返回null。
六、全球同频:文档智能的“小模型时刻”
Dharma-AI并非孤例。近一年间,轻量专用文档模型在全球密集落地:小米开源0.8B(8亿参数)文档解析模型,将文档解析、信息抽取与视觉问答压进同一模型,其三阶段训练以OCR持续预训练打底;腾讯混元2025年11月开源1B(10亿参数)的HunyuanOCR,在OmniDocBench复杂文档解析评测中获94.1分;面壁智能开源MiniCPM-OCR系列,1.3B(13亿参数)的1.0版本在Real5-OmniDocBench取得93.68分,2B(20亿参数)的Jev版本承担解析结果质检;DeepSeek-OCR2以3B(30亿参数)规模、Apache-2.0协议开源,将复杂页面的处理压缩至256至1120个视觉token。
【图表:全球文档智能赛道专用小模型参数规模对比】
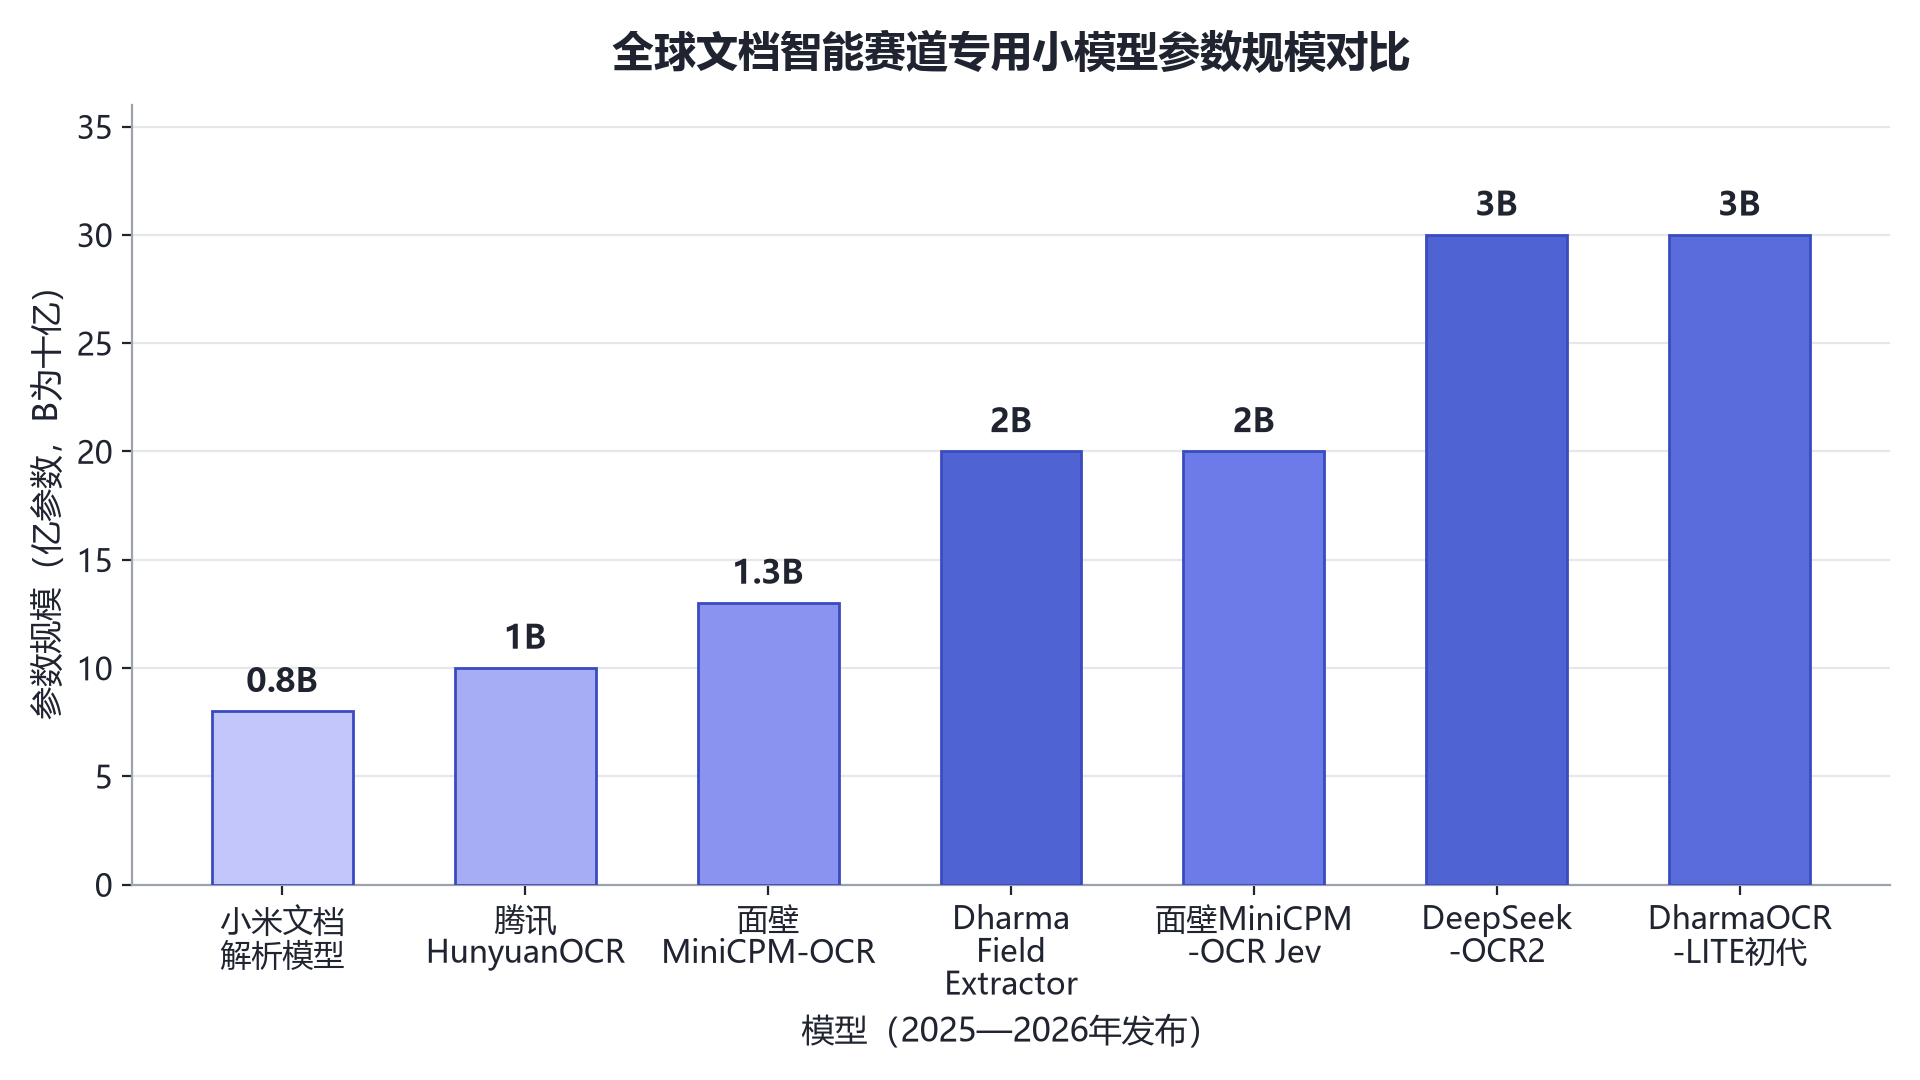
从0.8B到3B,头部厂商不约而同地把文档智能模型压进小参数区间,以更低的算力成本换取单一任务上的高精度;正如小米团队在发布时所判断的,文档智能的竞争焦点正从“堆参数”转向“参数效率与真实场景鲁棒性”。
需求侧同样清晰。Gartner统计,全球有超过90家厂商提供IDP产品,预计2026年市场规模达20.9亿美元,2021年至2026年复合增长率13%。中国市场,泛微网络在2026年半年报中披露,其智能文本与数据互转引擎可对各类文本进行自定义字段抽取、自动形成表格或台账;云从科技2025年年报显示,其OCR文档处理平台面向银行信贷、合同审查等场景,持续建设运营、财报、合同、流水四大机器人应用。Gartner在2025年4月的公开表态中指出,业务工作流中任务的多样性与对更高准确率的需求,正推动企业转向在特定功能或领域数据上微调的更小专用模型,这类模型响应更快、算力消耗与运维成本更低;其2026年8月发布的小语言模型报告则更为直接——将大模型仅当作运行时工具而非小模型孵化器是“代价高昂的战略失策”,产品负责人应立即运营化小语言模型,以大幅削减云支出、降低时延并赢得隐私优先的端侧体验。在企业侧,越来越多团队开始研发小语言模型:规模更小、只需较少算力即可在专属数据上训练、可靠性更高。
成本环境也在助推这一趋势。中国国家超算互联网推出“618算力促销”,以9.9元月度token套餐、OCR服务折扣吸引企业与开发者,行业分析认为部分算力资源利用率仍有提升空间——算力供给充裕与推理价格下行,让自托管专用小模型的经济性更为凸显。
七、冷静看待:厂商基准与产业验证
值得注意的是,这一领先成绩出自厂商自建、自评的基准。科技评测网站explainx.ai在对照核查中提醒,“在厂商基准上击败前沿模型”是厂商主张,第三方复核仍然必要。Gartner也在IDP市场指南中强调,没有任何单一IDP厂商能在不做优化的情况下处理所有文档类型,最优性能来自针对文档类型、业务功能与行业训练的模型组合——大模型是其中的组件之一。
Dharma-AI对自身定位的表达则更为克制:参数量设定了模型能力的上限,训练决定它在具体任务上能达到多高;“你的业务不需要最大的模型,它需要一个为你的问题训练的模型。”
结语
从OCR流水线识别,到20亿参数模型直出结构化JSON,文档智能正在完成从“读懂一页”到“取出一格”的能力收敛。Dharma Field Extractor的0.834与6至147倍的成本差,为小模型专用化路线添上了一个可供复核的数据点;而它能否从厂商基准走进生产环境,将取决于第三方复测与企业级部署的真实成绩。可以确定的是,在这条赛道上,比拼的已经不是谁的模型最大,而是谁离自己的问题最近。