2026年9月14日,NVIDIA官方宣布Perplexity本地智能体平台Portable Computer正式登陆Windows应用,面向24GB及以上显存的GeForce RTX PC与RTX PRO工作站。这标志着"全栈本地Agent"从开发者玩具走向消费级产品,也把"24GB显存"推上端侧AI的门槛线。本文沿事件时间线、合作双方、技术架构、赛道格局、硬件经济学与产业启示六条线索,拆解这次合作如何同时为Perplexity的订阅价值与NVIDIA的端侧硬件叙事提供支点,并审慎评估端侧Agent赛道在隐私、延迟、成本三重逻辑下的真实渗透节奏——高端小众先行,随显存升级曲线缓缓下沉。
事件还原:一次官宣背后的完整时间线
一次看似寻常的产品上线公告,背后是一条跨越20个月的硬件—模型—平台演进链路。2026年9月14日,NVIDIA官方博客(作者Gerardo Delgado)发文宣布:Perplexity本地智能体平台Portable Computer正式上线Perplexity Windows应用,面向配备24GB及以上显存的GeForce RTX PC与RTX PRO工作站(NVIDIA Blog《Perplexity Portable Computer Is Now Available on Windows, Powered by NVIDIA RTX》)。用户经Microsoft Store的Perplexity Windows应用即可获取,模型一键下载,订阅层面覆盖个人版与企业版的Pro(20美元/月)与Max(200美元/月)两档用户。
产品逻辑上有两个关键设定。其一,本地完成的任务不消耗Perplexity Computer的云额度;其二,当任务需要更强推理能力或实时信息时,智能体会识别并在请求用户授权后再上云,此时可调用Perplexity Search及15个以上的前沿模型——本地与云端之间有一条明确的授权边界。
回溯时间线,这次合作并非偶然:2025年1月6日CES上,黄仁勋发布预期价3,000美元的Project DIGITS;同年3月18日GTC上更名为DGX Spark,定价3,999美元;2025年10月15日正式发售;2026年2月27日,因LPDDR5X供应紧张涨价约17.5%至4,699美元;2026年8月25日,Portable Computer首发搭载DGX Spark与Linux RTX PC;至2026年9月14日登陆Windows RTX PC;而基于GB300 Ultra的DGX Station(2026年四季度上市,特指Windows版)"支持功能预计很快上线"。硬件发售在前、平台搭载在后,NVIDIA为其端侧设备逐步补齐了"杀手级应用"拼图。
【图1】合作与产品演进时间线(2025-01 至 2026-09)
时间 | 关键事件 |
2025-01-06 | CES :黄仁勋发布 Project DIGITS (预期价 3,000 美元, DGX Spark 前身) |
2025-03-18 | GTC :更名为 DGX Spark ,定价 3,999 美元 |
2025-10-15 | DGX Spark 正式发售 |
2026-02-27 | 因 LPDDR5X 供应紧张涨价约 17.5% 至 4,699 美元 |
2026-08-25 | Portable Computer 首发登陆 DGX Spark 与 Linux RTX PC |
2026-09-14 | Portable Computer 正式登陆 Windows RTX PC |
2026Q4 (计划) | DGX Station 上市(Windows版), " 支持功能预计很快上线 " ) |
从CES的概念机,到涨价的量产机,再到Windows平台的软件落地,这条时间线勾勒出NVIDIA端侧战略的完整闭环。而要理解闭环两端为何是NVIDIA与Perplexity,需要分别拆开这两家公司。
合作双方拆解:入口与算力的双向绑定
一次深度合作的本质,是双方各自握有对方最需要的资产:Perplexity握有"AI时代入口"的用户心智与Agent产品形态,NVIDIA握有端侧算力的硬件供给与开发者生态。
Perplexity:估值与ARR的陡峭曲线
公司估值自2024年末(11—12月)的90亿美元起步,2025年7月在NVIDIA、软银愿景基金二期、NEA、IVP等参投下,估值较2024年末(11—12月)的90亿美元翻倍至180亿美元(其间2025年3月曾估值约140亿美元,据Bloomberg),2025年8月据报道已达约200亿美元(The Information)。收入侧,ARR从2024年底Sacra估计的约6,300万美元,到2025年3月约1亿美元(Sacra估计),再到2025年年中约1.5亿美元(为2025年6—8月数据的插值);2026年8月The Information报道ARR已超过7.5亿美元——较2026年初不足2.5亿美元增长约三倍,主要增长来自云端Agent产品Perplexity Computer。需要强调:这一ARR为投资者简报口径、未经审计。用户与流量侧,2025年中月活超4500万;月搜索查询量方面,2025年5月CEO Srinivas在Bloomberg Tech Summit披露约7.8亿次/月,2026年中已超10亿次/月。The Information 2026年8月报道,NVIDIA正洽谈以超过300亿美元的估值参投Perplexity新一轮融资——目前仍处传闻阶段。
NVIDIA:不止是财务投资人
NVIDIA已是Perplexity多轮融资的参投老股东,黄仁勋多次公开表示日常使用Perplexity;Perplexity被列入NVIDIA Nemotron开放模型联盟,并采用NVIDIA Nemotron 3 Ultra开放模型;2026年7月24日,NVIDIA与Perplexity共同署名的《开放权重与美国AI领导力》公开信发布(该信由20余家机构联署(初始署名方25家),Perplexity为署名方之一)。投资、模型、平台、公共议程四条线并行,合作的紧密度远超一般商业联盟。
算力供给:三级硬件梯度
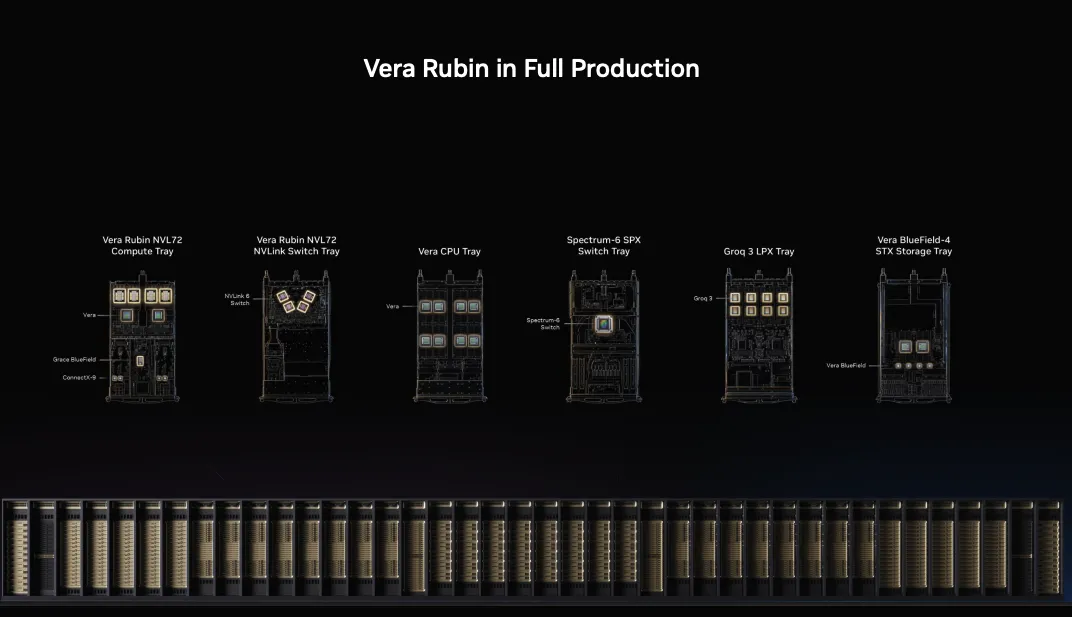
NVIDIA为端侧Agent准备了清晰的硬件阶梯:底层是RTX PC(24—96GB GDDR显存,消费与工作站通用);中层是DGX Spark——搭载GB10 Grace Blackwell芯片,集成20核Arm CPU与6,144个CUDA核心的Blackwell GPU,128GB LPDDR5X统一内存、带宽273GB/s,FP4算力1 PFLOPS(带稀疏理论峰值),机身仅150×150×50.5毫米、重1.2公斤,现价4,699美元;顶层是DGX Station——GB300 Ultra配备252GB HBM3e(带宽7.1TB/s)与72核Grace CPU,合计748GB一致性内存(NVIDIA官方口径),FP4算力最高20 PFLOPS(带稀疏理论峰值),支持最高1万亿参数模型,2026年四季度上市(Windows版;Linux版已由第三方渠道出货),功耗1,600W。销售热度亦有佐证:日本正规渠道NTTPC报价约89万日元(含税893,200日元,为2026年2月涨价后的当前挂牌价;首发含税价约704,000日元);据ASUS财报电话会及多家媒体报道(WCCFTech、新浪财经等),ASUS RTX Spark笔记本(ProArt P14/P16)首批配额在上市前售罄。
【图2】NVIDIA 端侧硬件三级梯度与定位
层级 | 产品 | 核心规格 | 定位 |
底层 · 通用 | RTX PC / RTX PRO 工作站 | 24—96GB GDDR 显存( RTX 3090 24GB → RTX PRO 6000 96GB ) | 消费级与工作站通用入口 |
中层 · 个人 AI 超算 | DGX Spark ( GB10 ) | 128GB LPDDR5X 统一内存 / 273GB/s / FP4 1 PFLOPS(稀疏理论峰值) / $4,699 | 桌面级本地 Agent 主力机型 |
顶层 · 企业级 | DGX Station ( GB300 Ultra , 2026Q4 ) | 748GB 一致性内存 / 252GB HBM3e @7.1TB/s / FP4 最高 20 PFLOPS(稀疏理论峰值) / 1,600W | 万亿参数模型与常驻 Agent 基础设施 |
入口方需要可信的算力底座,算力方需要标杆级的端侧应用——双向绑定就此成型。但真正决定这次合作含金量的,是技术层面一个尖锐的问题:一个全栈Agent,如何塞进24GB显存?
技术纵深:全栈本地 Agent 如何跑进 24GB 显存
端侧Agent的第一性难题是资源约束,Perplexity给出的答案是一场从模型到工具链的系统性瘦身。
全栈都在设备端
据Perplexity官方博客:模型、Agent运行框架(harness)、编排器(orchestrator)、规划器(planner)、工具路由器、调度器、持久化任务队列、本地搜索索引,全部运行在设备端,而非依赖云端分解任务。
模型选择与量化
本地模型包括经Perplexity后训练并针对RTX GPU优化的Qwen 3.8 27B,以及Perplexity自有后训练版PPLX 27B;此外,NVIDIA Nemotron 3.5 Lightning——一个30B参数的开源MoE模型,每token仅激活3B——经NVFP4量化后约22GB,上下文最高100万token,已宣布加入模型选择器。量化是24GB门槛成立的前提:27B模型BF16精度下约54GB,经NVFP4(4-bit)量化后约22–24GB;Nemotron 3.5 Lightning(30B MoE)经NVFP4量化后约22GB(自66GB BF16压缩),才装得下"模型权重+KV cache+运行时"的最小可行配置。
Harness 的协同设计
一个耐人寻味的工程细节:Qwen 3.8 27B标称26万token上下文,但超过10万token后能力明显下降,因此Perplexity采用极简harness策略——精简system prompt、缩小工具集、技能按需加载与卸载,并把MCP连接器改造为紧凑的命令行工具,辅以自验证钩子。这印证了一个行业判断:端侧模型的能力边界,倒逼Agent框架重新设计而非简单移植。
基准数据:厂商自评,须打引号
Perplexity自建Local Knowledge Work Bench(53个任务)上,PPLX 27B在DGX Spark准确率85.4%、Qwen 3.8 27B为82.6%,优于对比的开源harness(Pi 77.6%、Hermes 74.0%)——但这是厂商自评结果,无独立第三方复核。
24GB 门槛的量化逻辑与硬件清单
24GB卡的实测极限是装下32B级Q4量化模型;70B级Q4约42GB,需要32GB以上显存或128GB统一内存。Perplexity基础设施VP(VP, Computer Enterprise & Infrastructure)Nate Kupp称24GB是"保证体验的底线、同时兼顾可及性"的入门底线(VentureBeat,2026年8月)。满足门槛的GPU清单包括:RTX 3090 24GB(936GB/s)、RTX 4090 24GB(1,008GB/s)、RTX 5090 32GB(1,792GB/s)、RTX 6000 Ada 48GB,以及RTX PRO 6000 Blackwell 96GB(官方现价16,000美元,2026年8月)。
端云混合:授权边界与隐私设计
当本地编排器识别出某一步骤需要云端能力时,数据在离开设备前会先征求用户许可,再经本地PII分类器筛选,仅发送与任务相关的必要上下文;云端仅返回指引,不获得本地文件、工具或其余对话的访问权。生态连接器覆盖Outlook、OneDrive、Word、Google Drive、Gmail、Slack、GitHub七大服务,另有本地MCP服务器连接其他桌面应用(Windows版本地MCP支持待官方文档确认,截至2026年9月);代码与工具执行则在操作系统级强制沙盒(如Windows Sandbox)与浏览器沙箱环境中完成。
【图3】端云混合架构示意(本地层 → 授权升级 → 云层)
本地层(设备端,默认路径) | 授权边界(数据出设备前) | 云层(按需升级) |
Qwen 3.8 27B / PPLX 27B 本地模型 · 编排器 · 规划器 · 工具路由器 · 调度器 · 持久任务队列 · 本地搜索索引 · OS级强制 沙盒与内置浏览器(内置浏览器待官方证实) · 本地 MCP 服务器( Windows 支持待官方确认) · 七大连接器( Outlook/OneDrive/Word/Google Drive/Gmail/Slack/GitHub ) | 本地编排器识别需云端能力的步骤 → 征求用户许可 → PII 分类器筛选 → 仅发送相关上下文 | Perplexity Search 及 15+ 前沿模型;云端仅返回指引,不获得本地文件、工具或其余对话访问权;本地任务不消耗云额度 |
NVIDIA官方博客给出三个案例,勾勒出这类本地Agent的典型场景:工程场景中对GitHub PR进行审查、分组并生成文档更新提案;金融场景中对两年的券商对账单、1099表与税表进行本地追溯,分析费用与税负拖累,每个数字引用到具体文件页码;创业场景中本地分析用户激活漏斗、定位流失点并推送Slack。三个案例的共同点是敏感数据全部留在本地——这正是端云混合设计的价值出口。
技术架构回答了"能不能跑",下一层问题是:这条赛道有多大的土壤,又有多少人在跑?
赛道全景:端侧 Agent 的市场土壤与竞争格局
端侧Agent不是一个孤立产品,它踩在AI PC大盘放量、竞争阵营卡位、本地/云端权衡三重土壤之上。
AI PC 大盘:三条曲线,三种口径
随着Windows 10于2025年10月14日正式终止支持,2026至2028年被行业视为AI PC的集中换机窗口期,全球市场在多重机构预测下呈现显著增长态势。Gartner数据显示,2026年全球AI PC出货量预计达1.43亿台,渗透率约55%,较其此前预测的2025年7,780万台(渗透率31%)实现大幅跃升;而IDC口径则显示2025年AI PC出货量已达约1.14亿台,渗透率约43%,两家机构对2025年的判断差异主要源于统计口径不同。从更长周期看,Canalys预测2024—2028年AI PC出货量年复合增长率(CAGR)为44%,2028年将达到约2.05亿台,同时行业观察指出AI PC普遍存在10—15%的价格溢价。在中国市场,IDC预计2026年生成式AI PC出货量约2,200万台,同比增长146.5%,2025—2029年CAGR高达58.7%,显示出强劲的本土增长潜力。
【图4】AI PC 出货量与渗透率(Gartner / IDC / Canalys 分机构口径)
机构(口径) | 2025 年 | 2026 年(预测) | 长期预测 |
Gartner ( NPU 口径) | 预测 7,780 万台 / 渗透率 31% | 1.43 亿台 / 约 55% | — |
IDC (证券时报转引) | 转引出货约 1.14 亿台 / 渗透率约 43% | 1.43 亿台 / 突破 55%(该数字实为Gartner口径,见正文说明) | 2026 中国 GenAI PC 约 2,200 万台( +146.5% ); 2025—2029 CAGR 58.7% |
Canalys | — | — | 2024—2028 CAGR 44% ; 2028 年达约 2.05 亿台; AI PC 溢价 10—15%(行业普遍观察) |
注:Gartner 与 IDC 对 2025 年数据的差异源于统计口径不同(预测口径 vs 实际统计口径)。
竞争阵营:三条路线
其一是Apple的端云分层路线:端侧AFM约30亿参数(2-bit量化为2025年更新版,跑在Neural Engine上),WWDC25开放Foundation Models framework;2026年有报道称,重推理任务将转向授权的Google Gemini定制模型(据报道约10亿美元/年、约1.2万亿参数),简单任务留在端侧。
其二是微软:Copilot+ PC以NPU 40+ TOPS为硬件门槛,但本地LLM生态薄弱——Qualcomm 45 TOPS、AMD 50 TOPS的NPU上实际可用的本地大模型软件有限;定价体系为M365 Copilot每用户每月约22—30美元(Business约22美元、Enterprise约30美元两档)、Copilot Pro每月20美元。
其三是开发者生态:Ollama在GitHub已有约18万stars(2026年9月)、月活开发者数百万(Ollama自述2026年7月约890万),2025年7月发布官方桌面App(Agent Loop与MCP为后续迭代加入),正转型"本地智能体平台";LM Studio自2025年7月起允许免费商用。Portable Computer的打法本质是与Ollama生态争抢"开箱即用"心智——Perplexity把模型选择、软件栈配置全部托管,把门槛从"会装环境"降到"会点订阅"。
本地 vs 云端:一组量化权衡
隐私上,本地数据不出设备,而云Agent需上传屏幕/文档,企业合规团队常予否决;延迟上,云端单次往返约500ms,一个10步任务累计网络延迟超过5秒,而本地首token可低于50ms(行业经验值);成本上,本地边际成本趋近于零——SLM自托管每天处理1亿token约50美元(量级估算,无权威公开出处),相对调用云端前沿大模型API可降低数量级成本;若与同级SLM云API相比则基本相当。劣势同样明确:模型能力上限、硬件异构性、模型更新速度。
行业渗透现状
据行业估算,2026年生产环境中的AI Agent部署架构呈现“云优先”主导格局(约占80%),混合架构与纯本地部署分别占比15%和5%;尽管云端仍是主流,但混合架构份额正稳步上升。Fortune Business Insights预测,2026年全球AI推理市场规模将达1,178亿美元,其中边缘推理占比高达70.76%。在此背景下,Perplexity推出的Portable Computer精准契合了“本地优先处理敏感数据+云端授权执行高阶任务”的混合形态需求,成为这一趋势下的典型代表。
大盘在放量、竞对在卡位、权衡逻辑清晰,那么最后一块拼图是:谁买得起这张门票?这把问题引向硬件经济学。
硬件经济学:24GB 门槛是护城河还是天花板
价格带:门票不便宜
RTX 5090的官方建议零售价(MSRP)为1,999美元,但受供应链紧张及AI算力需求外溢影响,2026年8月其美国市场街价已飙升至4,000—5,000美元区间,其中公版Founders Edition起价约4,600美元,AIB定制型号价格波动剧烈且于9月进一步上涨;相比之下,上一代旗舰RTX 4090的MSRP为1,599美元。在中国市场,特供版RTX 5090D v2(配备24GB GDDR7显存)在京东平台的常规售价约为20,000—21,000元,紧俏时期价格甚至触及20,099—31,999元高位。与此同时,面向专业工作站的RTX PRO 6000 Blackwell官方价格在2026年8月已上调至16,000美元。若简单对比中国市场约2万元人民币的RTX 5090D v2与美版1,999美元的RTX 5090 MSRP,两者因产品规格差异(如显存容量、算力限制)及市场供需结构不同而不可直接等价,这种价格与配置的错位正是“本地Agent硬件税”的量化锚点。
关键张力:可服务装机只有约 1.5%
2025年9月,NVIDIA在显卡市场占据74.12%的份额,其中RTX 4090占比约0.93%(反映2025年5—8月水平),RTX 5090占比约0.31%—0.32%,满足24GB显存门槛的桌面独立显卡合计仅占1.2%—1.5%;至2025年12月,RTX 5090份额升至0.60%。同期显存结构呈现迁移趋势:8GB显存卡份额降至33.66%(环比下降1.37个百分点),16GB显存卡占比升至7.52%(环比增加0.72个百分点,增幅最大),显示显存升级正加速向16GB集中,但与24GB门槛之间仍存在明显断层。由此可见,24GB显存门槛将可服务装机量限制在约1.5%的低个位数游戏用户群体内,其渗透路径注定遵循“高端小众先行、随显存升级曲线下沉”的规律;而在工作站领域,RTX PRO 6000可通过MIG技术切分为4个24GB实例以服务多用户,从而有效摊薄硬件成本。
【图5】24GB+ 显卡:Steam 装机份额与价格带
显卡 | 显存 | Steam 装机份额( 2025-09 ) | 价格带( MSRP / 市场价) |
RTX 4090 | 24GB | 0.7%-0.9%左右 | MSRP $1,599 |
RTX 5090 | 32GB | 约 0.31—0.32% ( 2025-12 升至 0.60% ) | MSRP $1,999 ; 2026-08 街价约 $4,000—5,000(公版FE约$4,600起) |
RTX 5090D v2 | 24GB GDDR7 | — | 入门款/活动价下限约 ¥20,000—21,000,2026年8月后主流型号实际普遍更高(¥2.3万-3万) |
RTX PRO 6000 Blackwell | 96GB | 工作站渠道 | 官方现价 $16,000(2026年8月) (可 MIG 切分 4×24GB ) |
合计( 24GB+ 桌面独显) | — | 约 1.2–1.5% 量级 | 中国街价约¥2万 / 美版MSRP $1,999(两口径不等价) |
注:约 1.2–1.5% 为量级估算(RTX 4090 + RTX 5090 等合计,未含 Steam 调查中未单列的 RTX 3090);Steam 装机口径与 JPR 的 AIB 出货市场口径(2025Q4 NVIDIA 份额 94%)属不同统计维度,不可混用。
商业模式题眼:本地是放大器,不是替代品
"本地任务不消耗云额度"这一设计,实质是额度保护加隐私溢价的组合策略:本地推理不蚕食云收入,反而放大订阅价值、支撑Max每月200美元档位的价值叙事。对Perplexity而言,24GB门槛既是护城河(筛出高价值用户),也确实是一时走不出的天花板。
AIB 大盘参照
JPR数据显示,2025年四季度全球AIB(独立显卡)出货1,150万块、同比增长36%,NVIDIA份额达94%的历史新高(actual)。大盘在增长,但增长的主力并非24GB+高端卡——硬件结构与软件门槛之间的错位,仍需时间弥合。
综上所述,24GB门槛在短期内更像一面筛选墙:它保护了体验,也圈定了市场。这种张力如何演化,构成最后一章挑战与启示的底色。
挑战与产业启示
风险清单,如实陈列
第一,可服务装机稀缺:24GB+显卡在Steam装机中约1.5%,消费级基本盘暂薄。
第二,基准可信度:Perplexity的基准为厂商自评、无第三方复核;NVIDIA自报Nemotron 3.5 Lightning的GPQA为75.x%,而OpenRouter第三方实测为63.0—68.8%,差距7—12个百分点,须如实标注。
第三,NVIDIA以300亿美元以上估值参投Perplexity仍处融资谈判传闻阶段。
第四,Perplexity ARR未经审计。
第五,DGX Spark的273GB/s内存带宽构成吞吐瓶颈:Llama 8B Q4量化下约55–80 tok/s,对比RTX 5090约145 tok/s——该设备刻意为能效与内存容量而非吞吐优化,选购预期需校准。
第六,Digital Trends相关原文未能无损核验,本稿不引用其内容。
趋势判断:临界点与共识模式
综合Gartner、Canalys与IDC的一致方向,2026年被视为AI PC从高端选配走向主流普及的临界点;Agent应用的落地正在催生本地算力刚需;"低延迟+数据不出端"的隐私属性,是端侧AI不可替代的核心价值。算力下沉已现拐点信号:据转引的IDC数据,2026年一季度边缘AI芯片出货同比增长78%,而云侧仅增长12%(经券商研报/媒体转引)。混合架构——本地优先+云端授权升级——正在成为2026年的共识模式,本次NVIDIA×Perplexity合作正是该模式最完整的样板。
工具链的配套演进
NVIDIA同步开源了NeMo Switchyard路由库,按准确率、速度、成本将Agent工作流的各步骤路由至最合适的模型;其内部基准显示,可将任务完成成本降至单独使用Claude Opus 4.8等前沿模型的约三分之一(NVIDIA Developer Blog,厂商自报)。路由层的成熟,意味着端云混合不只是产品策略,也正在沉淀为标准化基础设施。
市场空间参照
据弗若斯特沙利文预测,全球端侧AI市场规模将从2025年的3,219亿元增至2029年的1.22万亿元、CAGR约40%;同期中国端侧AI市场2029年约3,077亿元。端侧不是小池子,但兑现节奏取决于硬件渗透与模型能力的双曲线交汇。
【图6】本地 vs 云端 Agent 对比矩阵
维度 | 本地 Agent ( Portable Computer 模式) | 云端 Agent |
隐私 | 数据不出设备; PII 分类器守门;企业合规友好 | 需上传屏幕 / 文档;企业合规团队常予否决 |
延迟 | 首 token 可低于 50ms | 单次往返约 500ms ; 10 步任务累计网络延迟超 5 秒 |
成本 | 边际成本趋近于零(自托管 1 亿 token/ 天约 $50 ) | 云端前沿大模型 API 同规模高一个数量级(与同级 SLM 云 API 相当) |
能力上限 | 受显存约束: 24GB 装下 32B 级 Q4 量化模型;硬件异构、模型更新慢 | 可调用 15+ 前沿模型,能力天花板高 |
收束
NVIDIA与Perplexity的这次合作,与其说定义了一款产品,不如说定义了一套标准——全栈本地运行、显存门槛量化、端云授权边界、隐私溢价订阅。它用24GB这道清晰的线,把"端侧Agent"从概念变成了可验证的工程事实;也用Steam装机约1.5%的现实提醒我们,爆发仍在前夜而非当下。高端小众先行、随显存升级曲线下沉、混合架构成为共识——这三条路径大概率将贯穿未来两到三年的端侧AI叙事。对产业观察者而言,值得跟踪的指标已经明确:16GB向24GB的显存迁移速度、第三方对厂商自评基准的复核结果,以及DGX Station上市后高带宽统一内存能否改写本地Agent的吞吐天花板。